系好安全带,来听听我们的故事:我们如何从被 snmpwalk 输出淹没,一路走到构建出一条以设备为中心、通往 Zabbix 7 基于遍历的模板的道路。
最初的问题
每一位监控工程师都经历过这样的时刻。
网络中新增了一台设备:一台防火墙、一台 NAS、一台 UPS,或者一台来自您尚未纳入标准的供应商的交换机。您打开 Zabbix 模板列表,没有任何匹配项。您下载供应商的 MIB 包,它体积庞大。您运行 snmpwalk,输出长达数千行。
然后,真正的工作才开始:弄清楚其中任何一项对监控意味着什么。
不是“存在哪些 OID”。这部分通常很容易。难点在于判断哪些 OID 值得在生产模板中占有一席之地,哪些会产生噪音、重复数据,或者产生一个因遍历而陷入超时的发现规则。
这正是我们着手解决的问题。不是“发现 SNMP”,SNMP 本身已经慷慨地做到了这一点。我们希望缩短从第一次遍历到可用 Zabbix 模板的路径,同时不假装自动化可以取代人的判断。
这段历程最终造就了 snmp-scanner:一个带有 Web UI 的 Node.js 工具,它可以遍历 SNMP 设备、分析 OID 结构、匹配内置的设备知识库,并导出 Zabbix 7 基于遍历的模板。
“起点:一次遍历,全面可见。”
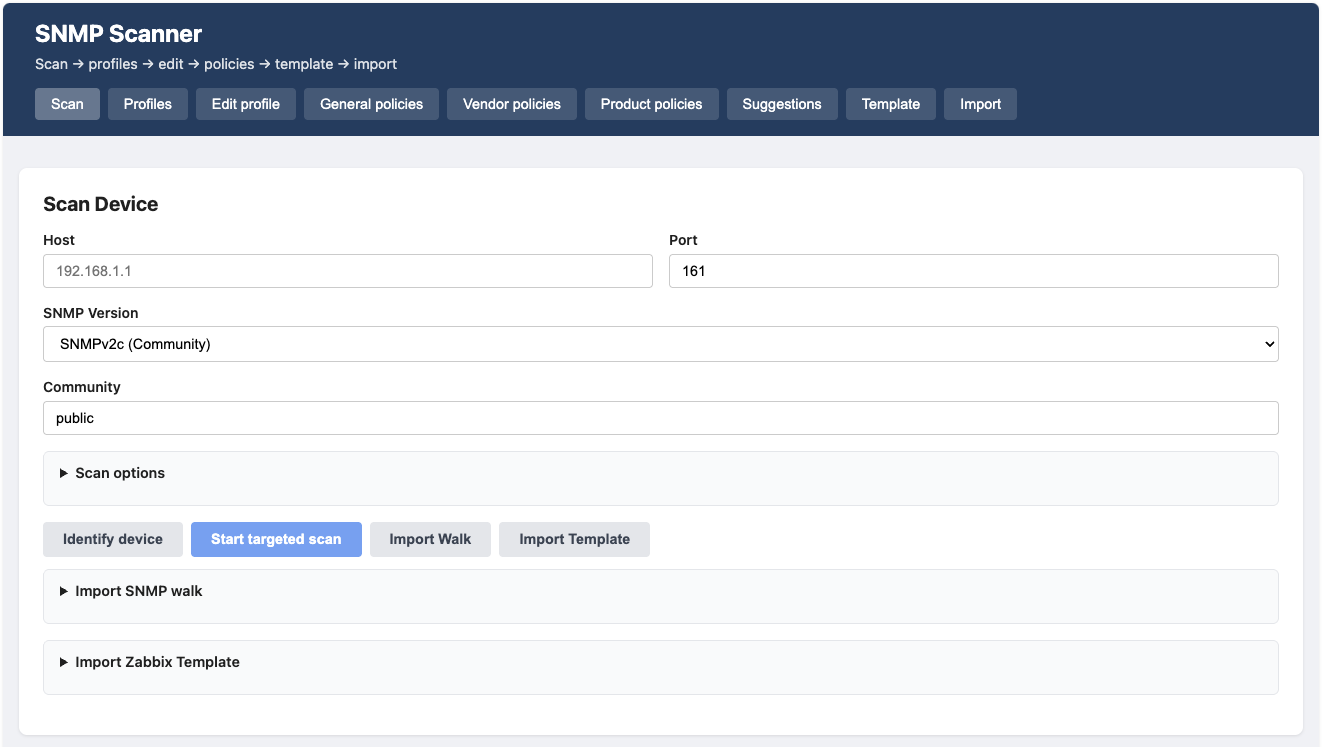
Scan 选项卡:主机、SNMP 版本、实时流式显示的遍历进度。
第一个目标:找到值得关注的 OID
我们的第一反应很直接:用一键式工具自动完成 OID 发现。
如果能以编程方式找出“值得关注的”对象,就能省去在遍历文件中手动 grep 的数小时时间。该工具的早期版本正是专注于此:
- 确定企业编号:根据 sysObjectID
- 检测供应商:根据企业 ID、sysDescr 和目录元数据
- 收集 MIB 模块:解析供应商的 .mib 文件,或通过 snmptranslate 解析名称
- 选择候选项:看起来可监控的标量、表列和表根
这种方法的效果比预期的还要好……至少一开始是这样。
企业编号检测和供应商匹配为我们提供了立足点。MIB 导入补充了符号和标签。表分析将标量与带索引的结构区分开来。遍历结果第一次不再像是一堵由数字砌成的墙。
但我们当时解决的是一个错误的核心问题。
流水线概览

真正的问题从来不是找到 OID
以下是改变项目方向的关键:
找到 OID 很容易。知道哪些 OID 重要却很难。
在网络或存储设备上执行一次典型的企业级遍历,所呈现的数据远远超出任何合理的监控模板应包含的范围。其中大部分属于以下几类,在您真正尝试将它们投入运维之前,它们看起来都很重要:
- 配置对象:适用于资产信息,很少用于告警
- 诊断和调试计数器:在实验室中很有意思,在生产环境中却是噪音
- 没有运维意义的计数器:它们会递增,但没人知道它们变化时该怎么办
- 重复项:同一概念通过多个 OID 或多种表结构暴露出来
- 数以百计的表:许多表只有一行、索引方式怪异,或者没有稳定的发现键值
我们是吃了苦头才明白这一点的。
早期导出的模板包含数百个监控项。发现规则超时。LLD 宏与索引列对不上。监控项的 OID 在技术上正确,名称在实践中却毫无用处。
该工具擅长发现,但还不擅长甄选。
这一区别成为了核心设计原则:展示完整的遍历。甄选最终选用的内容。
目录负责建议,工程师负责决定。没有任何内容被隐藏,但也并非所有内容都会被自动选中。
补充上下文
一旦我们接受了 OID 发现只是第一步,该工具就必须针对扫描到的每个候选项回答更难的问题:
| 问题 | 为什么重要 |
| 这是一个指标吗? | 适合用于图形和趋势 |
| 这是一个状态吗? | 更适合作为触发器或值映射 |
| 这是一个表吗? | LLD 的候选项 |
| 它能否成为基于遍历的 LLD? | Zabbix 7 模式:一个主遍历,依赖发现 |
| 它是否具有触发器潜力? | 还是仅用于资产信息的噪音? |
正是从这里开始,snmp-scanner 不再只是一个遍历查看器。
OID 分析区分标量与表,并对行数据进行采样。表配方处理通用解析无法应对的已知结构,例如 IF-MIB 和 ENTITY-MIB。
监控项策略对类型、单位和预处理应用全局规则。LLD 宏逻辑从 INDEX 列以及 name/descr 字段推导出 {#SNMPINDEX} 和可选的显示宏。
遍历适用性检查也变得同样重要。一个有 4,000 行、选中了 12 列的表不只是“可发现的”,它可能太大而无法安全遍历。现在,该工具会估算 varbind 数量并应用上限,在导出之前通过 UI 反馈提示哪些表被跳过。
具体到 Zabbix,我们很早就决定采用基于遍历的发现。在 Zabbix 7 中,依赖发现规则由主 SNMP 遍历上的预处理链提供数据,而不是为每一列都增加独立的 SNMP 监控项。
这一选择以编写模板时的复杂度换取运行时的效率和一致性,但前提是您选择了正确的表和列。
标量和 LLD 表并排显示,附带目录匹配横幅和建议徽标。
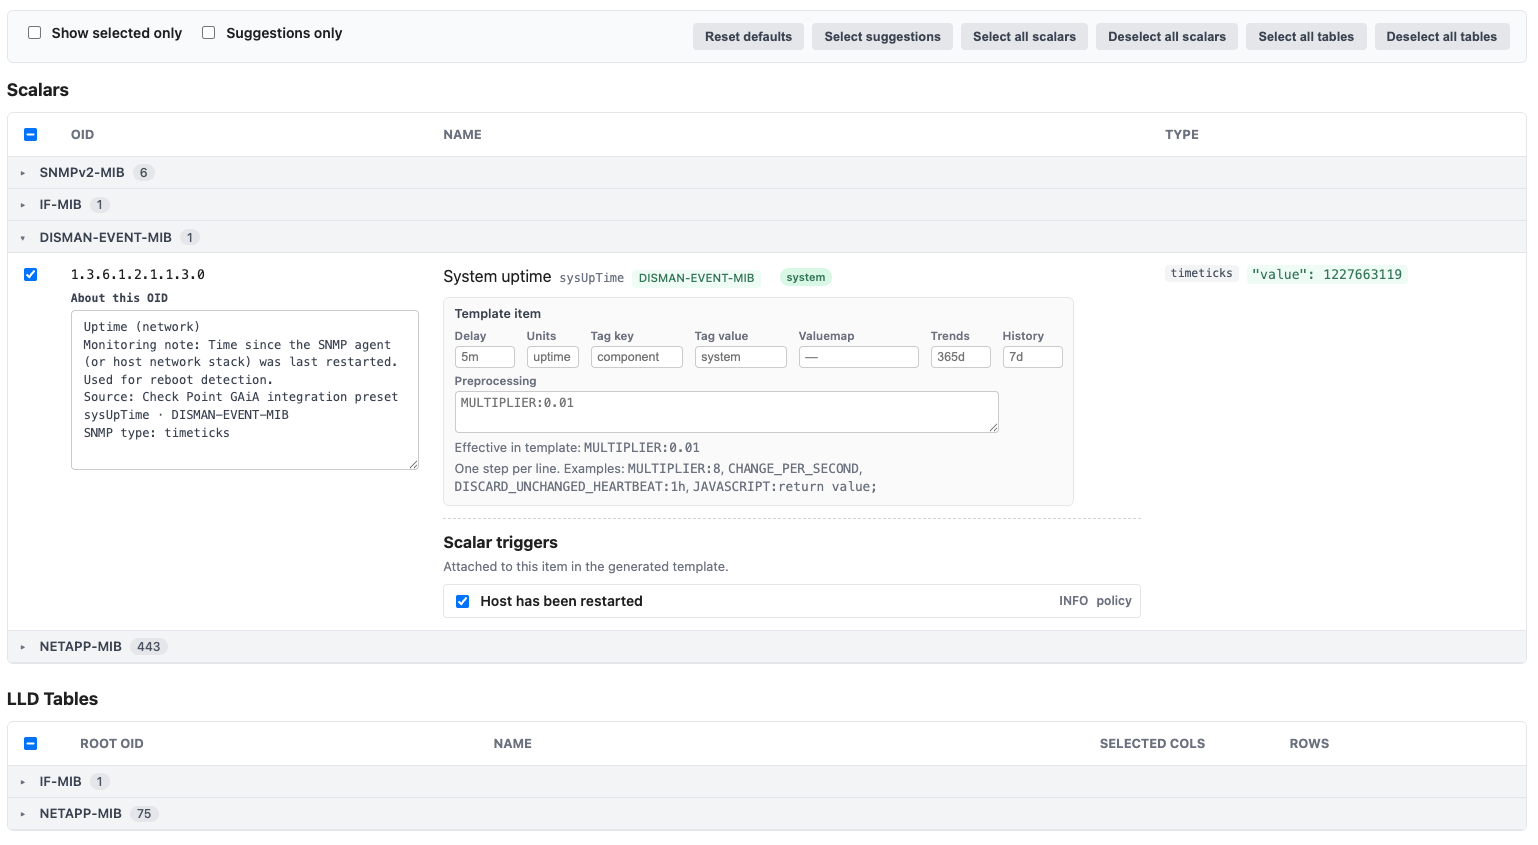
“完整遍历可见,甄选出的内容高亮显示。”
Template 选项卡,遍历限制横幅显示被跳过的表和行数上限。
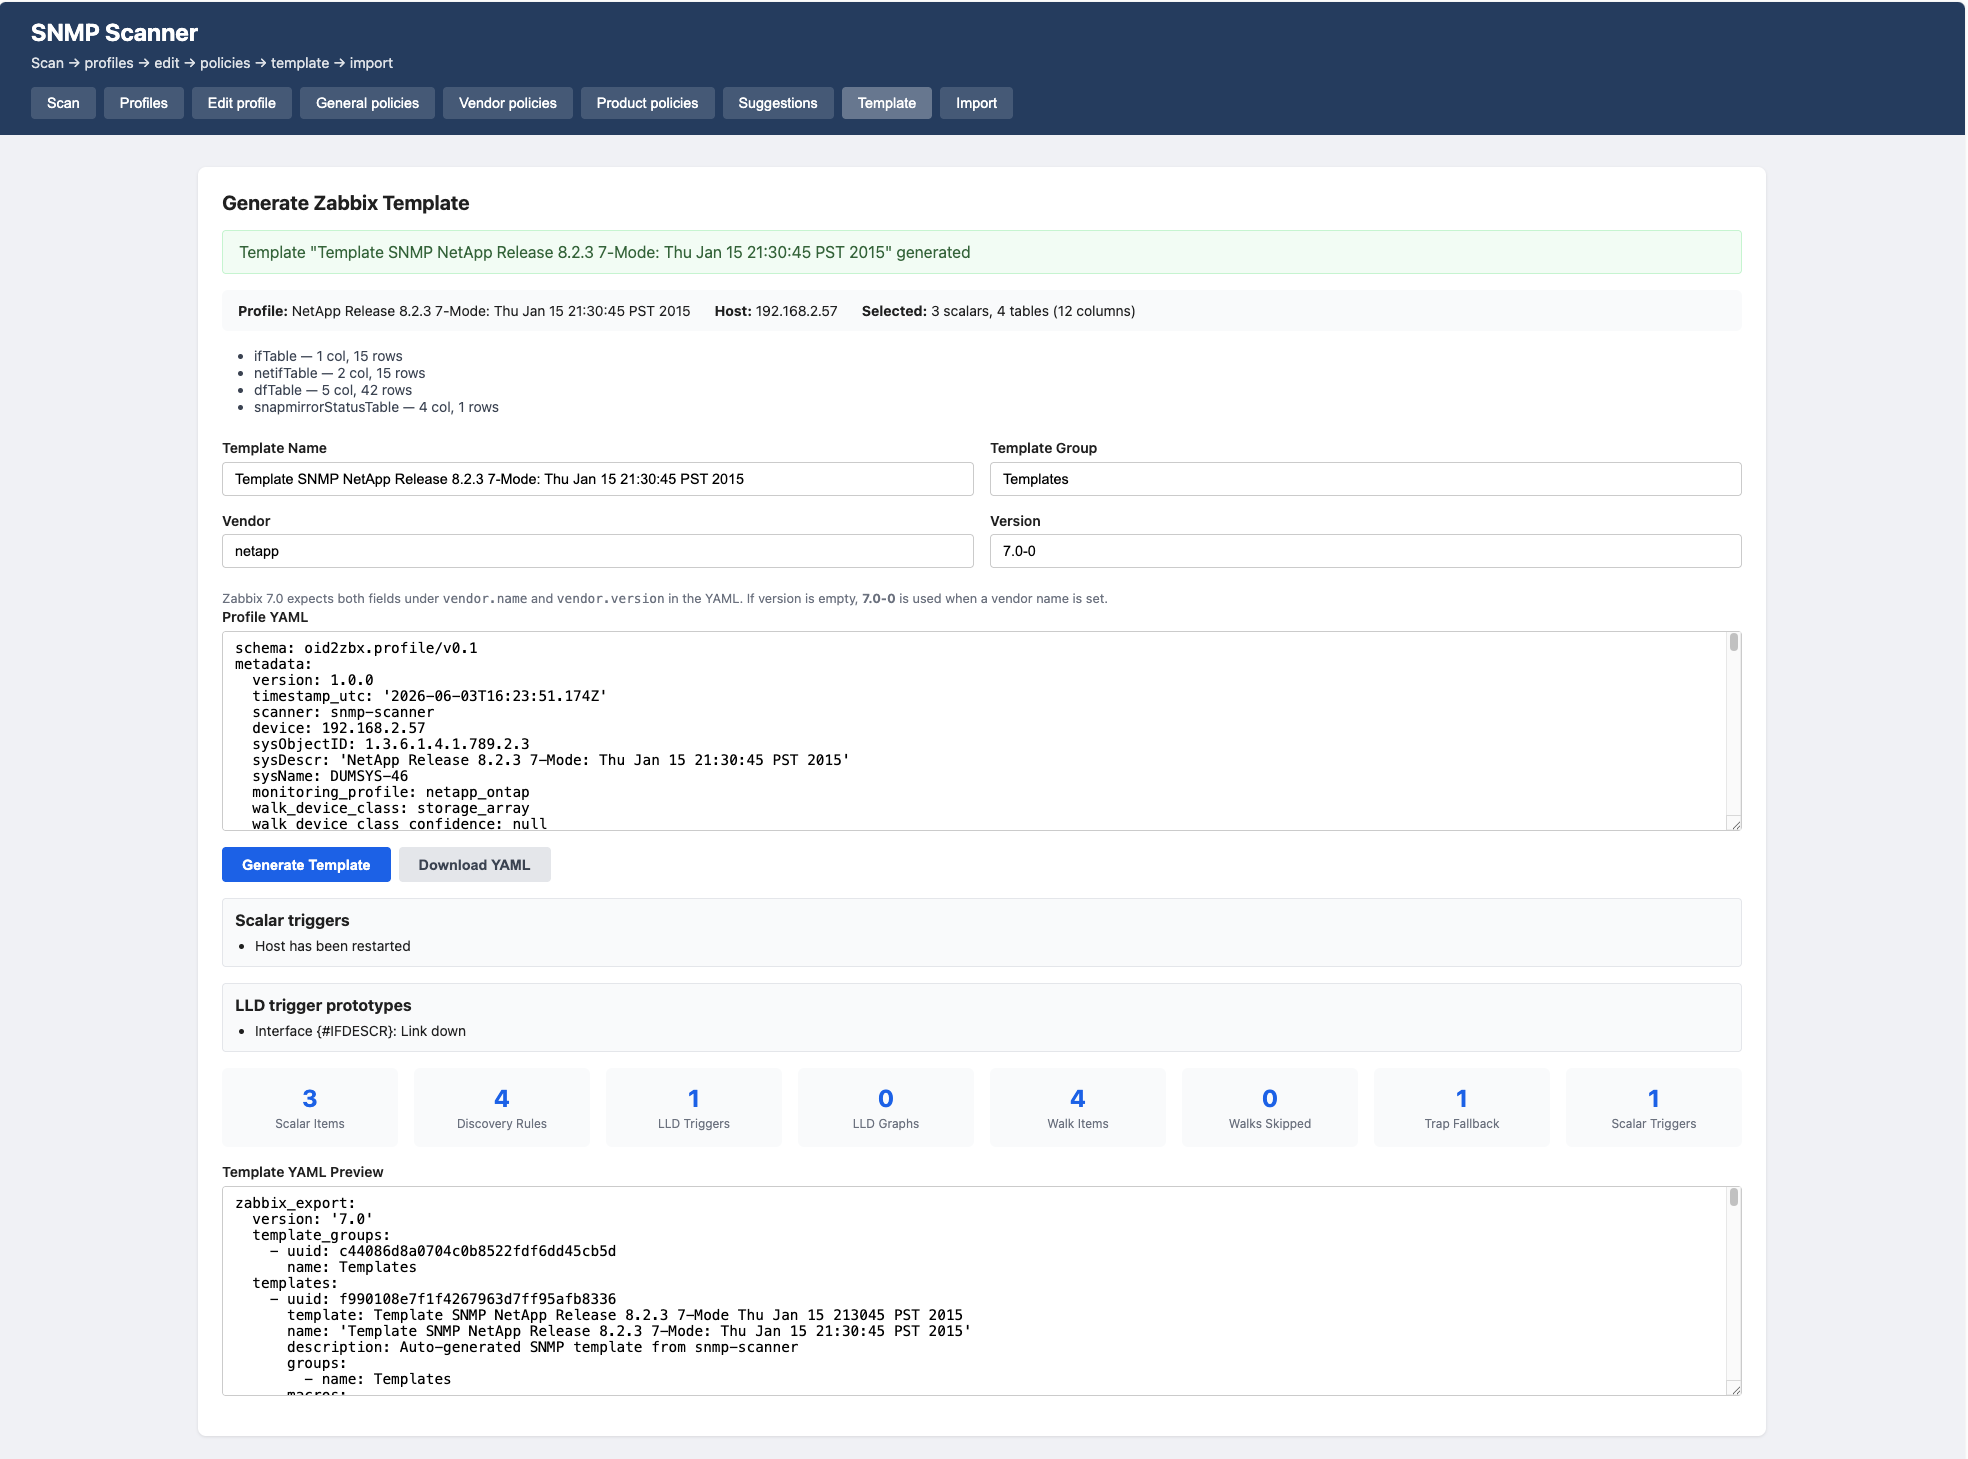
“发现并不等同于遍历适用性。”
向现有监控系统学习
原始 MIB 文件告诉您供应商定义了什么,却不会告诉您运维人员监控什么。
因此我们把目光投向别处,不是为了寻找运行时依赖,而是为了获取领域知识。
Zabbix 官方模板和社区模板成为我们主要的数据丰富来源。在开发阶段,我们解析模板 YAML,并按 OID 将元数据合并到设备包中:监控项键值、预处理步骤、触发器原型、值映射。扫描时不会从 Zabbix 获取任何内容,这些知识在 git 中进行版本管理,并随工具一起发布。
基于其他供应商的开源信息,我们构建了自己的操作系统检测模型:一个经过实战检验的大型映射,涵盖 sysObjectID 前缀、sysDescr 模式和设备指纹,作为目录匹配的提示层。可以把它理解为:“成千上万的部署早已对这类设备形态进行了分类。”
同样的原则也适用于从其他监控工具配置文件导入的历史数据:来源出处和跨来源的一致性比任何单一供应商的树都更重要。
值得借鉴的洞见是:现有的监控项目就是一个知识库,记录了人们已经认定值得关注的内容。
MIB 导入回答“存在什么”。监控模板回答“人们实际使用什么”。
我们如今的导入优先级正体现了这一点:
- Zabbix 模板 → 甄选 + 键值 + 触发器
- SNMP 遍历 → 证明某个绑定在此设备上有效的证据
- OID 目录 → 标识(符号、标签、MIB 模块)
- MIB 解析 → 仅作为候选项!!绝不单独自动推荐!!
我们的知识层
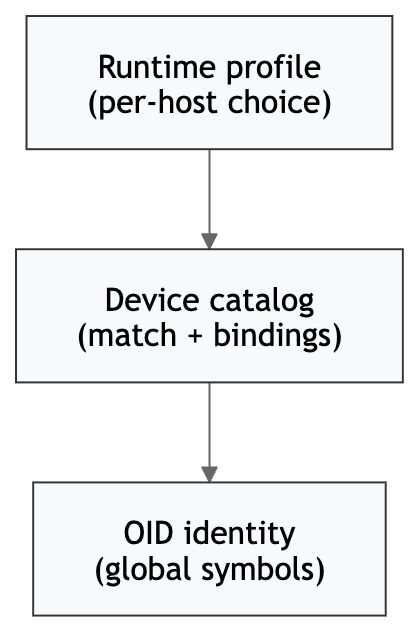
从 OID 到指标:更大规模的重新设计
下一个瓶颈在于语义,而不在于技术。
同一种监控含义,例如 CPU 利用率、磁盘 SMART、接口流量,在不同的供应商、模板和 MIB 模块中以不同的 OID 出现。
我们有多套并行的结构:集成预设、OID 目录、监控配置文件、建议类别,以及以 OID 为键的评分。对于“这测量的是什么”,没有共享的标识。
因此,我们目前正在向以设备为中心的知识模型迁移:
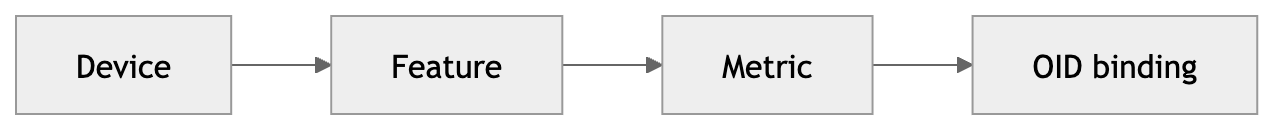
- 指标是监控含义(cpu_utilization, disk_smart, if_in_octets)。
- 绑定是该指标在特定产品上的呈现方式。
- OID 标识保持全局性,由设备文件引用。
评分被刻意拆分为三层:
| 层 | 问题 | 是否存储在 git 中? |
| monitoring_value | 这个指标有多重要? | 是 |
| binding_confidence | 此绑定在该设备上是否有效? | 否 – 扫描证据 |
| effective_score | 现在应高亮显示或自动选择什么? | 否 – 仅限运行时 |
设备匹配分数和指标排名绝不能合并。选出正确的 Cisco 交换机型号是一个问题,判断哪些指标应纳入模板并为其排名则是另一个问题。
我们还将大约 830 个旧版集成预设整合为按企业划分的设备包。尽可能采用原生的甄选包,无法做到时则采用合并后的草稿。同时通过虚拟适配层保持向后兼容。
Feature → Metric 面板,显示监控价值、层级和有效分数。
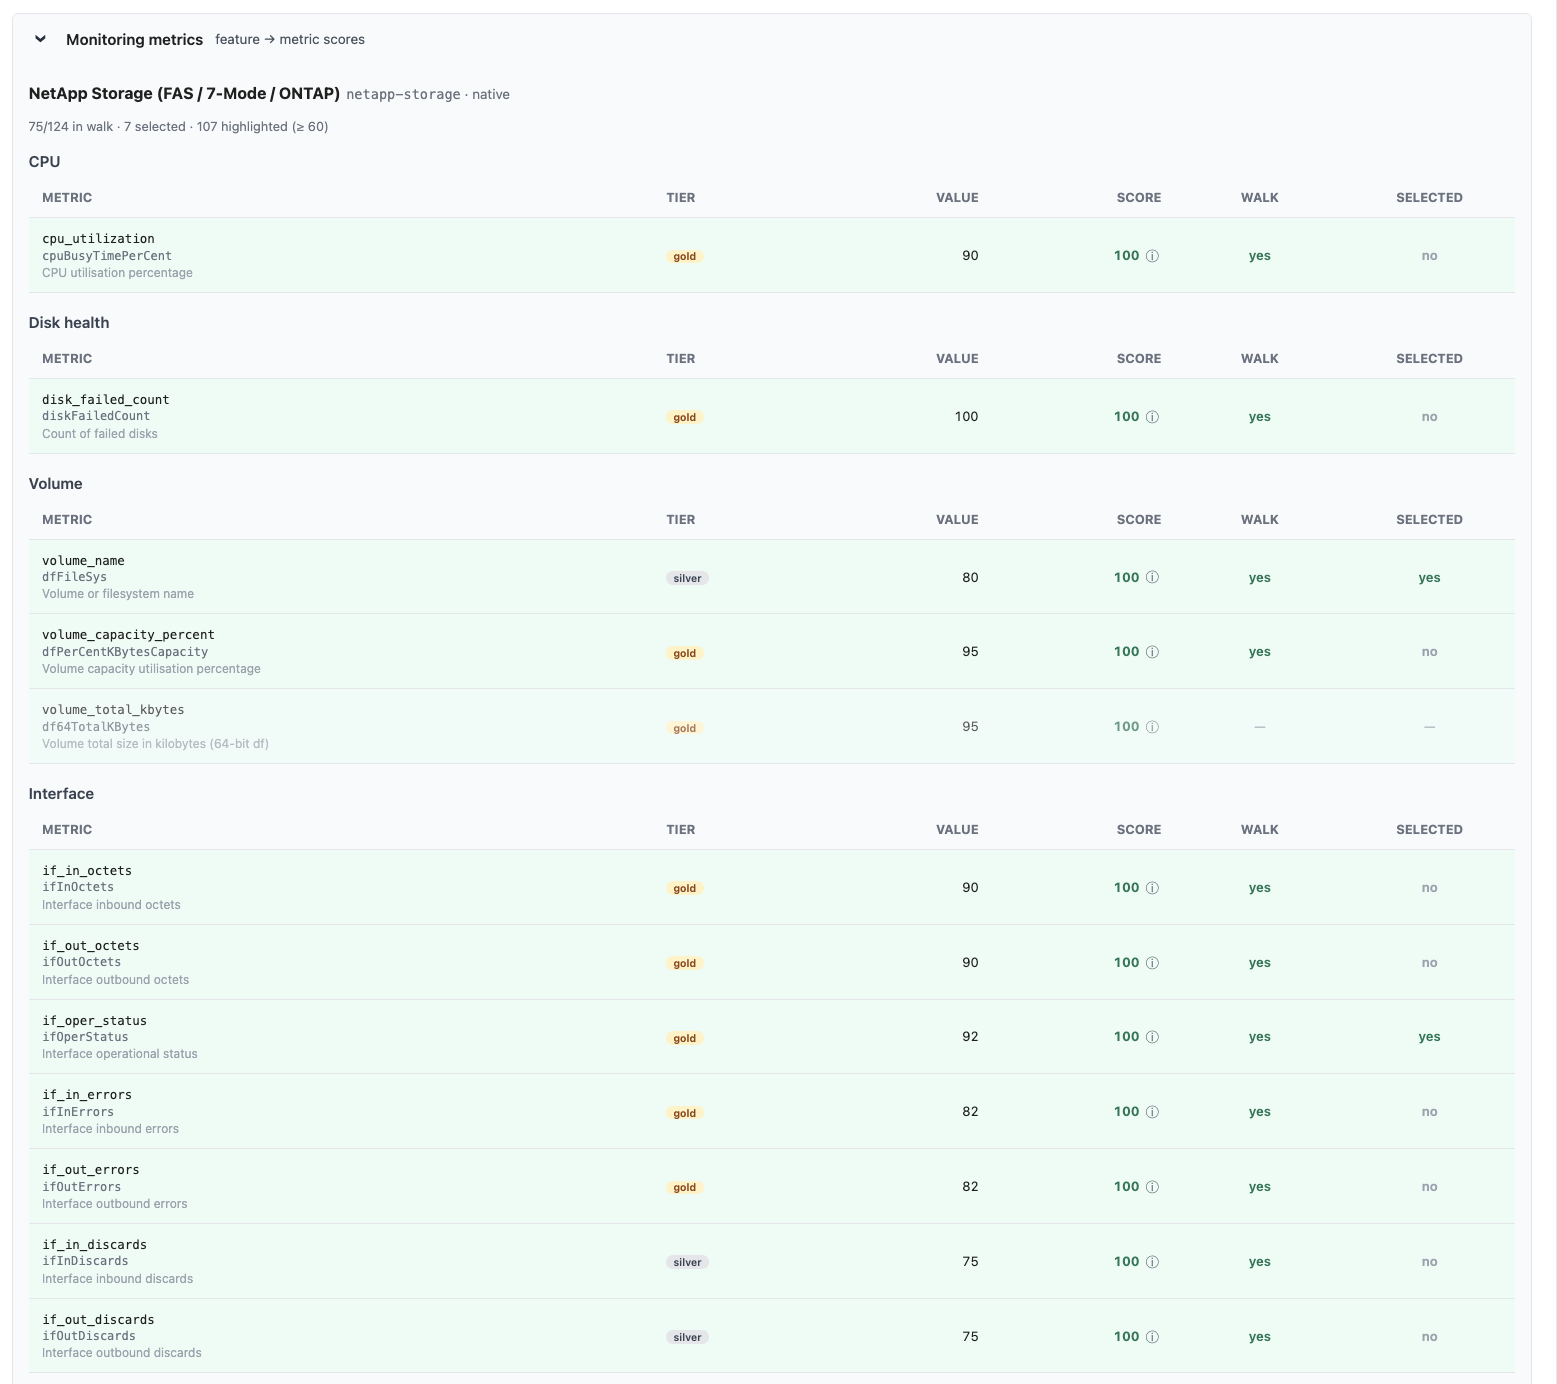
“甄选的单位是指标,而不是 OID。”
经验教训
这些是我们希望第一天就写在墙上的经验教训。
经验 1:大多数 SNMP 数据都不是有用的监控数据
一次完整的遍历是一份 agent 所暴露内容的完整清单。一个好的模板则是为可运维性而选出的子集。混淆两者,就会得到包含 500 个监控项、却无人维护的模板。
经验 2:设备分类比 OID 发现更重要
知道您面对的是一台 QNAP QTS 5 设备、一台 Cisco IOS-XE 交换机还是一台 NetApp FAS 文件服务器,比任何通用的“值得关注的 OID”启发式方法都更能缩小候选集。基于 sysObjectID、sysDescr 和企业 ID 的匹配规则,效果优于单纯的符号模式匹配。
经验 3:表往往比标量对象更有价值
标量提供主机名和运行时间。表则提供接口、磁盘、传感器、风扇和电源,这些正是 LLD 当初被发明出来所要处理的结构。表根检测、索引处理和遍历配方比挑选标量更值得投入工程时间。
经验 4:生成所有内容只会产生无法使用的模板
我们最初的“成功”指标是监控项数量。如今我们真正有用的指标是可维护的监控项数量。我们现在执行模板安全自动选择策略:自动选择的监控项有硬性上限,MIB 草稿永不自动选择,并且只有在用户反复选择之后才进行渐进式学习。
经验 5:好的过滤比好的发现更重要
发现告诉您有什么。过滤告诉您什么应该进入生产环境。全局拒绝列表、设备类别建议、监控价值层级和遍历大小限制都不是事后补充,它们本身就是产品。
经验 6:现有的监控项目蕴含宝贵的领域知识
MIB 是必需的。模板带有主观判断。两者的结合,即模板智慧加上遍历证据,再加上 MIB 标识……这胜过任何单一来源。
我们的 snmp-scanner 目前能做什么
如果您想了解具体情况,以下是当前的工作流程:
- 扫描设备(SNMPv2c/v3),或导入现有的遍历文件
- 分析 OID 结构:标量、表、行样本
- 从目录中匹配设备包(约 830 个设备系列,正在整合为原生包)
- 通过三层预选指标:通用默认值、设备预设、启发式建议
- 在 UI 中编辑发现配置文件:切换选择、调整宏、检查遍历限制
- 导出 Zabbix 7 YAML 模板,并通过 API 导入
主要特性:
- 完整遍历,甄选后的选择:不隐藏任何内容
- git 中的 JSON 知识:没有运行时数据库,不从外部仓库实时获取
- 基于遍历的 LLD:适用于 Zabbix 7
- MIB 导入:用于 OID 标识;MIB 到设备草稿用于候选包(提升前由甄选人员审核)
- 以指标为键的学习:用户的重复选择会影响运行时排名,但不影响 git,直到维护者将其提升
- 回归测试夹具:针对匿名化的遍历(NetApp、Palo Alto、Cisco 等)测试流水线变更,无需实时 SNMP
该工具同时服务两类受众:需要探索和调试遍历的工程师,以及需要针对已知设备类别更快交付模板的工程师。
生成的 Zabbix 模板预览 + 成功的 API 导入。
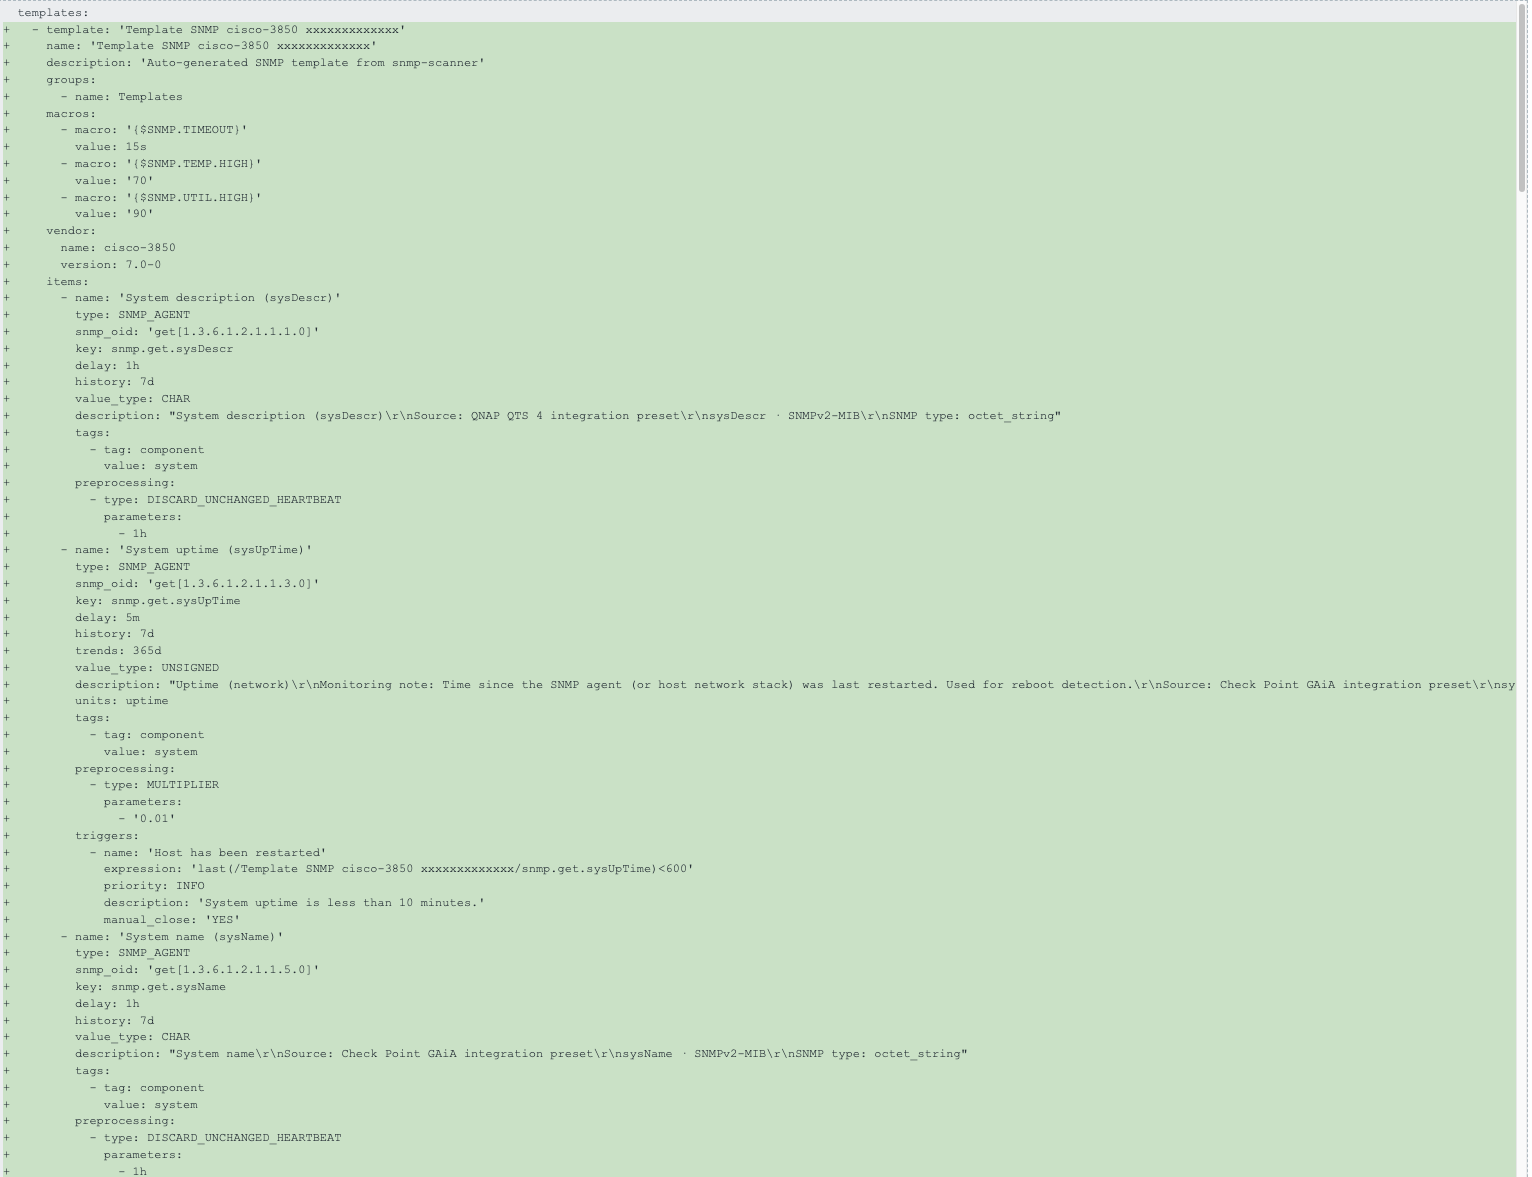
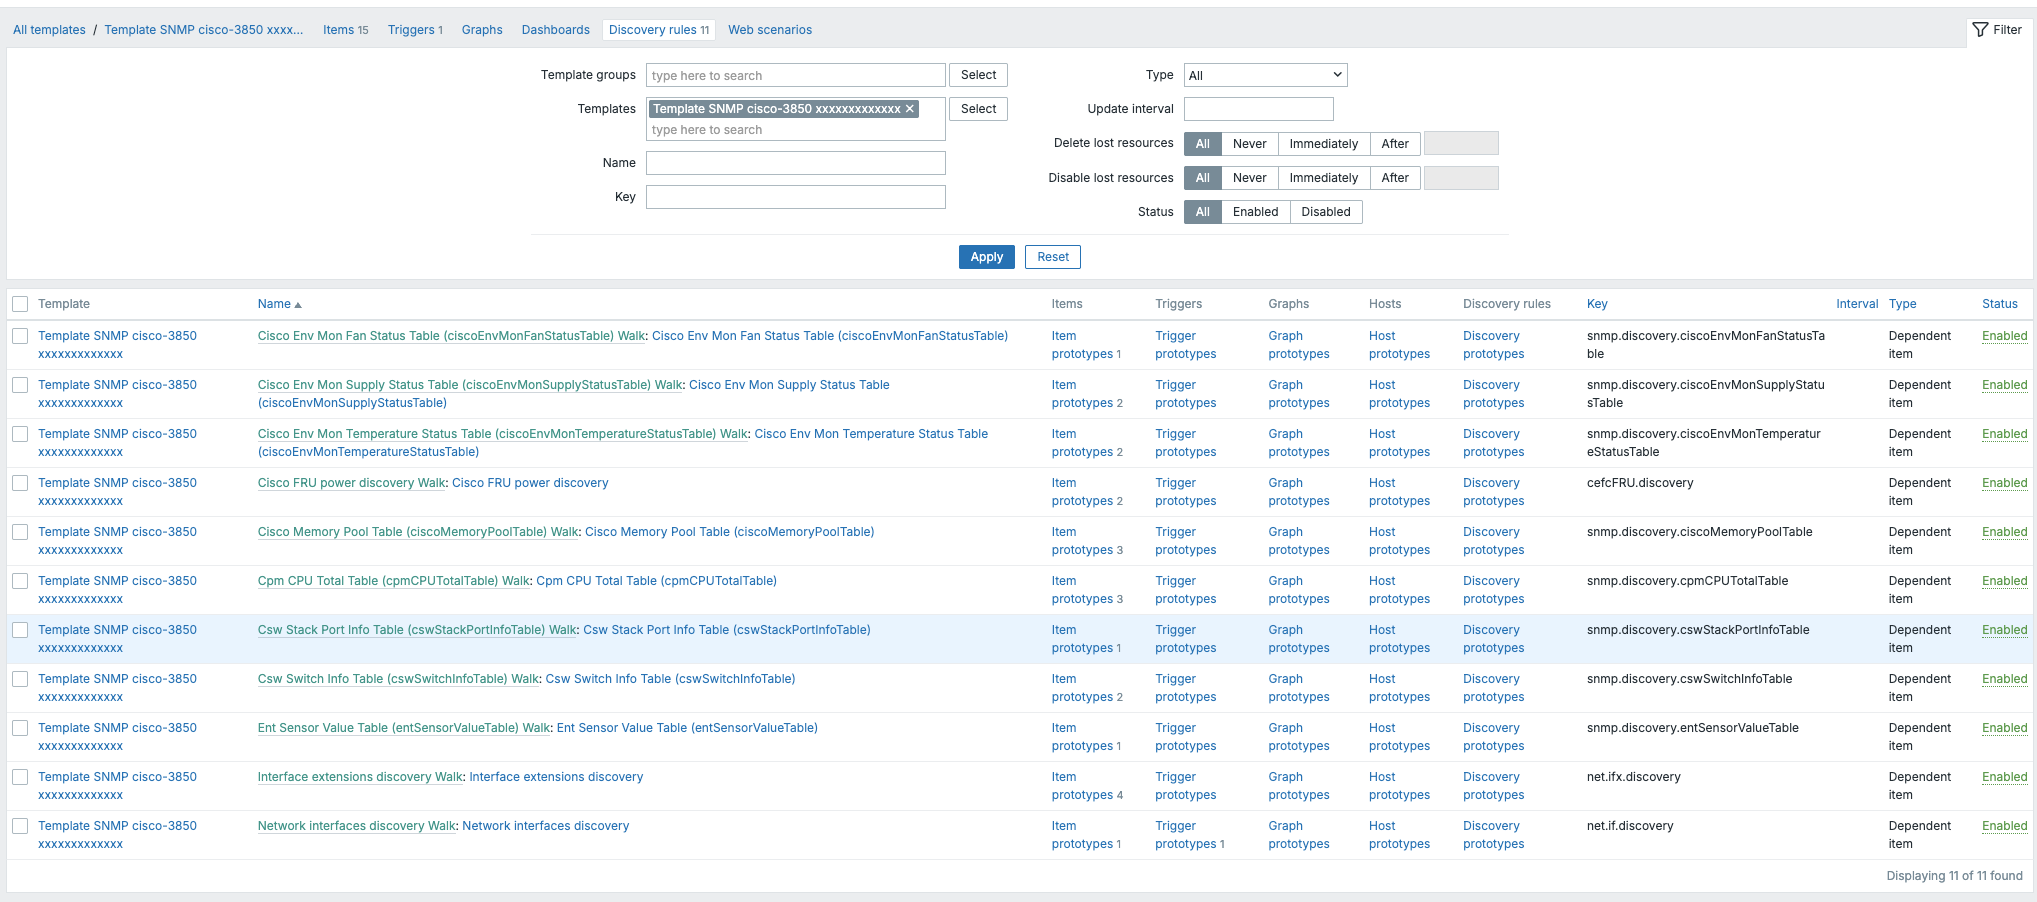
“在一次会话中,从遍历到导入模板。”
我们目前的进展
我们已经走过了“查找 OID”阶段,深入到了“治理自动化”阶段。
最近的工作重点是受控的自动选择:首次扫描仅遵循 git 中经过甄选的 default_selected 绑定;当社区学习和有效分数超过阈值时,重复扫描可以进行软自动选择,且始终不超出模板安全上限。源自 MIB 的草稿会一直留在候选范围内,直到有人将其提升。
目录正处于迁移过程中:旧版集成 JSON 正在逐步退役,取而代之的是规范的 devices/*.json 包,并通过合成保持向后兼容。OID 目录数据采用分片以支持扩展。对于我们已经完成端到端遍历和甄选的供应商,例如 Cisco、QNAP、NetApp、Palo Alto、Eaton、F5 等,操作系统检测和 Zabbix 数据丰富与原生包并存。
我们坦诚地说明自动化不能做什么:它不能取代模板设计中的判断。它压缩的是繁琐的中间环节:遍历解析、命名、表检测、预设匹配,以及初版监控项结构。
下一步计划
路线图遵循同样的原则:更多智能,更多防护措施。
更好的触发器生成:从 Zabbix 源模板中合并更多触发器原型语义;改进标量级和表级触发器导出,不再局限于运行时间这类默认设置。
更智能的指标分类:扩展指标注册表和功能分类体系(cpu, memory, disk_health, interface, psu, …)。从 monitoring_value 推导层级,而不是依赖并行的评分系统。规范绑定生命周期:candidate → known_good → recommended → blocked。
AI 辅助的监控建议:我们的设想是,它很可能作为排名和审核加速器发挥作用,而不是作为自主的模板作者。硬性约束,即遍历大小、触发器合理性、设备类别、重复检测,都是结构性的。AI 可以帮助对含义不明确的符号进行分类,或提出指标映射供甄选人员审核;但它不应绕过从遍历 → 模板 → 推荐的证据阶梯。
运维层面的完善:按表类型设置遍历限制(接口 vs 路由 vs ARP),SNMP trap / 通知支持,以及在 UI 中更清晰的“将此扫描选择提升到目录”路径。
结语
SNMP 自动发现听起来像是一个搜索问题。实际上,它是一个甄选问题,外面包着一个分类问题,再外面包着一个模板易用性问题。
我们最初试图找到值得关注的 OID。而我们之所以能一直保持实用,是因为我们承认了值得关注 ≠ 可监控,并构建了一个既尊重遍历的完整性、又尊重模板纪律的系统。
如果您正盯着一份新的 snmpwalk 输出和一个缺失的 Zabbix 模板,这并不说明您在 SNMP 上失败了。您正处在领域知识最为重要的那一步。
SNMP 自动发现不是一个发现问题。它是一个建立在分类和领域知识之上的甄选问题。
这正是我们的工具帮助我们的地方:遍历清晰可见,候选项已排好序,通往 Zabbix 7 模板的路径比花一个下午手动进行 OID 考古还要短。
如果您在迁移方面需要帮助,或希望确保在扩展和优化 Zabbix 时遵循最佳实践,请随时联系 OICTS。我们是一家业务遍及全球的 Zabbix 高级合作伙伴,在美国、英国、荷兰和比利时设有办事处,随时准备在每一步为您提供帮助。
 Prev Post