Пристегнитесь: это история о том, как мы прошли путь от попыток не утонуть в выводе snmpwalk до создания ориентированного на устройства подхода к шаблонам Zabbix 7 на основе обхода.
Исходная проблема
Каждый инженер по мониторингу знает этот момент.
В сети появляется новое устройство — брандмауэр, NAS, ИБП, коммутатор производителя, который у вас еще не стандартизирован. Вы открываете список шаблонов Zabbix. Ничего подходящего. Вы скачиваете пакет MIB производителя. Он огромный. Вы запускаете snmpwalk. В выводе тысячи строк.
И тут начинается настоящая работа: понять, что все это означает для мониторинга.
Не «какие OID существуют». Эта часть обычно проста. Сложно решить, какие из этих OID заслуживают места в шаблоне для продуктивной среды, а какие создадут шум, дублирующиеся данные или правило обнаружения, которое само загонит себя в тайм-аут при обходе.
Именно эту проблему мы взялись решить. Не «обнаружить SNMP». SNMP и так щедро это делает. Мы хотели сократить путь от первого обхода до пригодного к использованию шаблона Zabbix, не делая вид, что автоматизация может заменить экспертное суждение.
Этот путь привел к созданию snmp-scanner: инструмента на Node.js с веб-интерфейсом, который выполняет обход SNMP-устройств, анализирует структуру OID, сопоставляет устройство со встроенной базой знаний об устройствах и экспортирует шаблоны Zabbix 7 на основе обхода.
«Отправная точка — один обход, полная видимость».
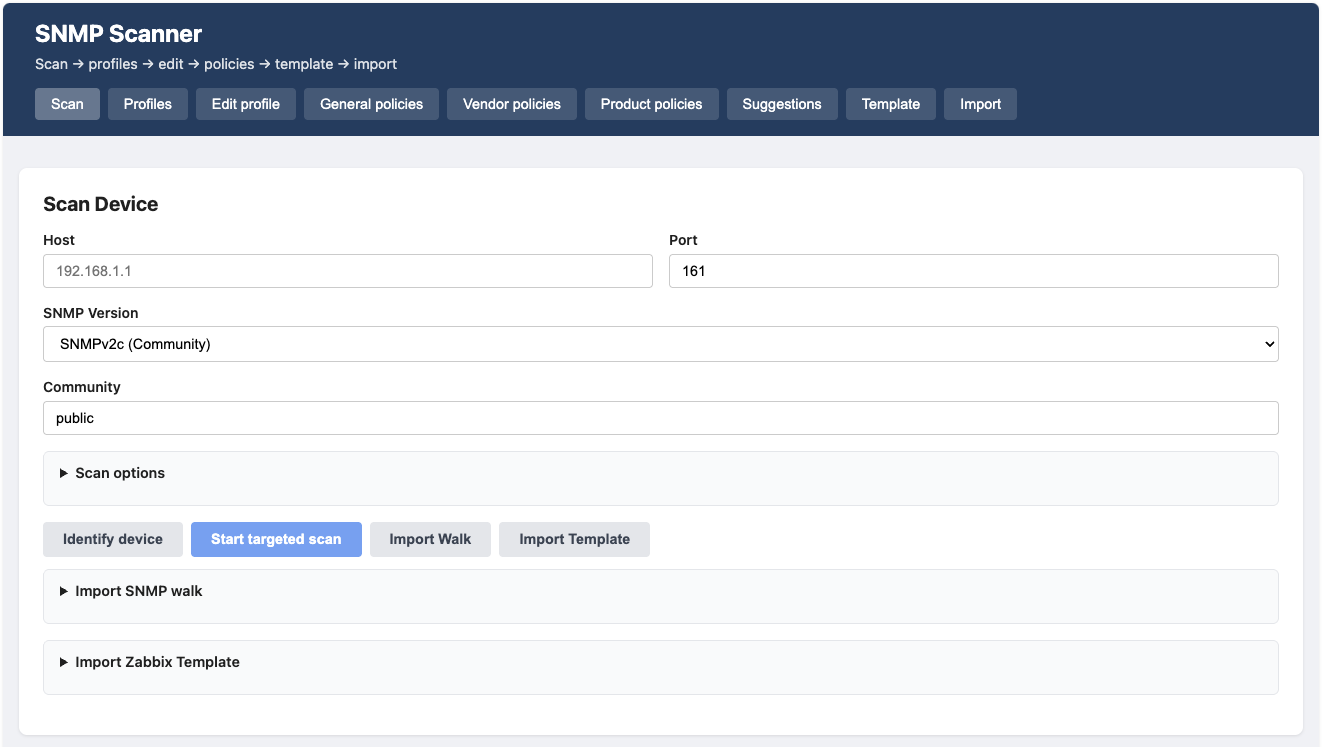
Вкладка Scan: узел сети, версия SNMP, ход обхода в реальном времени.
Первая цель: найти интересные OID
Наш первый порыв был очевиден: автоматизировать обнаружение OID с помощью инструмента в один клик.
Если бы мы могли программно выявлять «интересные» объекты, мы бы сэкономили часы ручного grep по файлам обхода. Ранние версии инструмента были сосредоточены именно на этом:
- Определить номер enterprise: по sysObjectID
- Определить производителя: по enterprise ID, sysDescr и метаданным каталога
- Собрать модули MIB: разобрать файлы .mib производителя или получить имена через snmptranslate
- Отобрать кандидатов: скаляры, столбцы таблиц и корни таблиц, которые выглядели пригодными для мониторинга
Это сработало лучше, чем ожидалось… поначалу.
Определение enterprise и сопоставление производителей дали нам точку опоры. Импорт MIB заполнил символы и метки. Анализ таблиц отделил скаляры от индексированных структур. Впервые обход не казался стеной из чисел.
Но главной мы считали не ту проблему.
Обзор конвейера

Настоящая проблема никогда не заключалась в поиске OID
Вот что изменило направление проекта:
Найти OID легко. Понять, какие из них важны, — трудно.
Типичный обход ветки enterprise на сетевом устройстве или системе хранения данных выдает гораздо больше данных, чем должен содержать любой разумный шаблон мониторинга. Большая их часть попадает в категории, которые выглядят важными, пока вы не попытаетесь применить их на практике:
- Объекты конфигурации: полезны для инвентаризации, редко для оповещений
- Диагностические и отладочные счетчики: интересны в лаборатории, создают шум в продуктивной среде
- Счетчики без эксплуатационного смысла: они растут, но никто не знает, что делать, когда они меняются
- Дубликаты: одно и то же понятие, представленное под несколькими OID или в таблицах разной структуры
- Сотни таблиц: многие с одной строкой, странной индексацией или без стабильного ключа обнаружения
Мы усвоили это на собственном горьком опыте.
Ранние экспорты давали шаблоны с сотнями элементов данных. Правила обнаружения завершались по тайм-ауту. LLD макросы не совпадали со столбцами индексов. У элементов данных были технически правильные OID и практически бесполезные имена.
Инструмент хорошо справлялся с обнаружением. Но еще не справлялся с отбором.
Это различие стало основным принципом проектирования: показывать обход целиком. Осознанно формировать выборку.
Каталог подсказывает, инженер решает. Ничего не скрыто. Но не все выбирается автоматически.
Добавляем контекст
Как только мы признали, что обнаружение OID — это лишь первый шаг, инструменту пришлось отвечать на более сложные вопросы о каждом просканированном кандидате:
| Вопрос | Почему это важно |
| Это метрика? | Подходит для графиков и трендов |
| Это статус? | Лучше как триггер или преобразование значений |
| Это таблица? | Кандидат для LLD |
| Можно ли сделать из этого LLD на основе обхода? | Подход Zabbix 7: один основной обход, зависимое обнаружение |
| Есть ли у этого потенциал для триггера? | Или это шум, полезный только для инвентаризации? |
Именно здесь snmp-scanner перерос простое средство просмотра обходов.
Анализ OID отделяет скаляры от таблиц и берет образцы данных строк. Рецепты таблиц обрабатывают известные структуры, такие как IF-MIB и ENTITY-MIB, с которыми универсальный разбор не справляется.
Политики элементов данных применяют глобальные правила для типов, единиц измерения и предобработки. Логика LLD макросов выводит {#SNMPINDEX} и необязательные макросы отображения из столбцов INDEX и полей name/descr.
Не менее важными стали проверки пригодности для обхода. Таблица с 4000 строк и 12 выбранными столбцами не просто «доступна для обнаружения» — она может оказаться слишком большой для безопасного обхода. Теперь инструмент оценивает количество varbind и применяет ограничения, а интерфейс сообщает о пропущенных таблицах еще до экспорта.
Что касается именно Zabbix, мы с самого начала сделали ставку на обнаружение на основе обхода. В Zabbix 7 это зависимые правила обнаружения, которые получают данные через цепочку предобработки из основного обхода SNMP, вместо того чтобы множить отдельные элементы данных SNMP для каждого столбца.
Этот выбор означает более сложное создание шаблона ради эффективности и согласованности во время выполнения, но только если выбрать правильные таблицы и столбцы.
Скаляры и таблицы LLD рядом, с баннером совпадения с каталогом и значками подсказок.
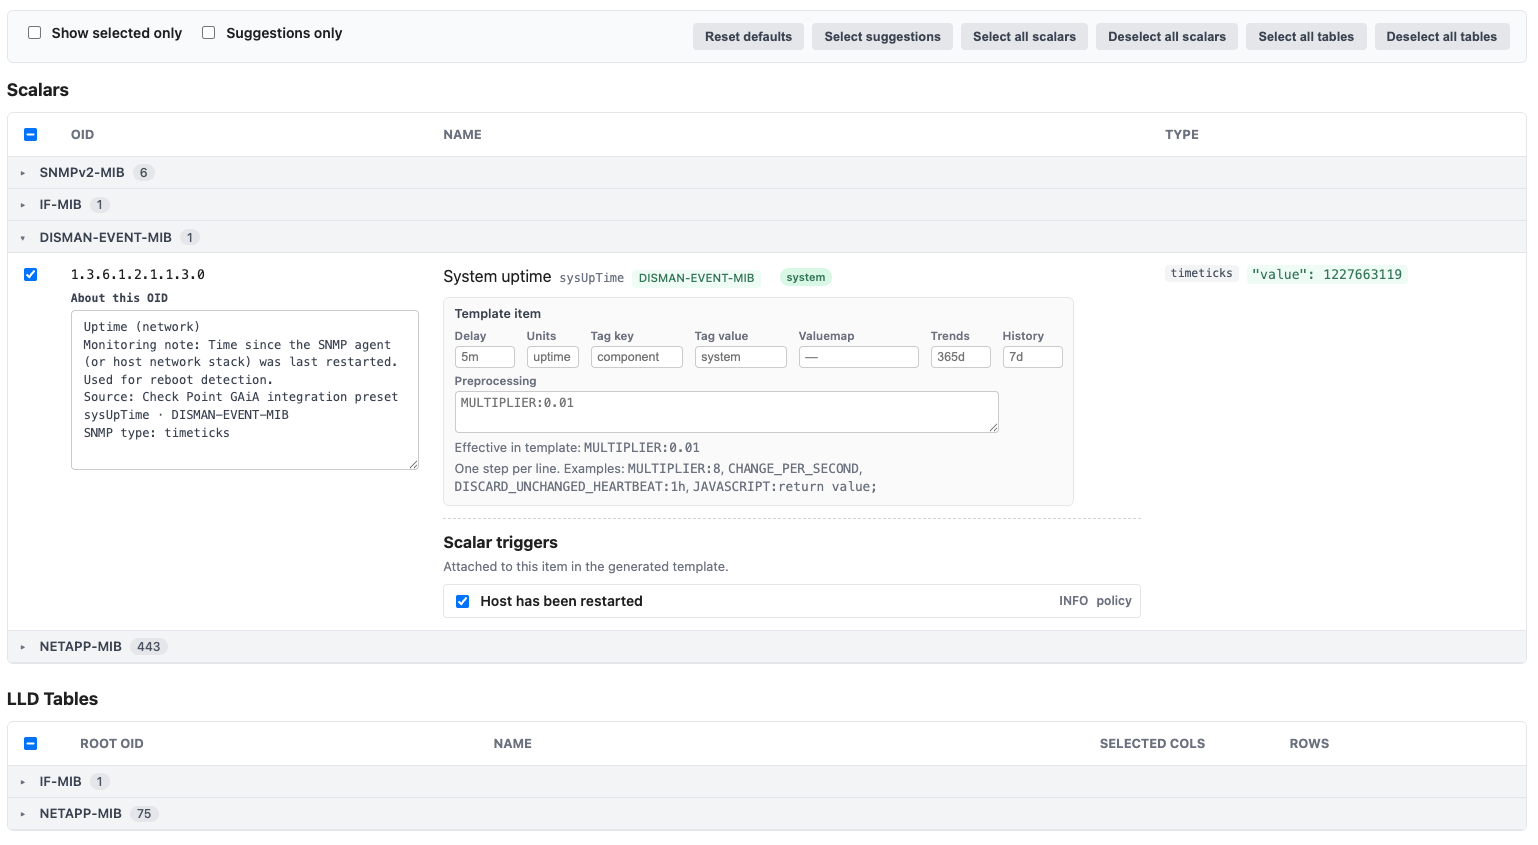
«Весь обход на виду, отобранное выделено».
Вкладка Template с баннером ограничений обхода, где показаны пропущенные таблицы и ограничения по числу строк.
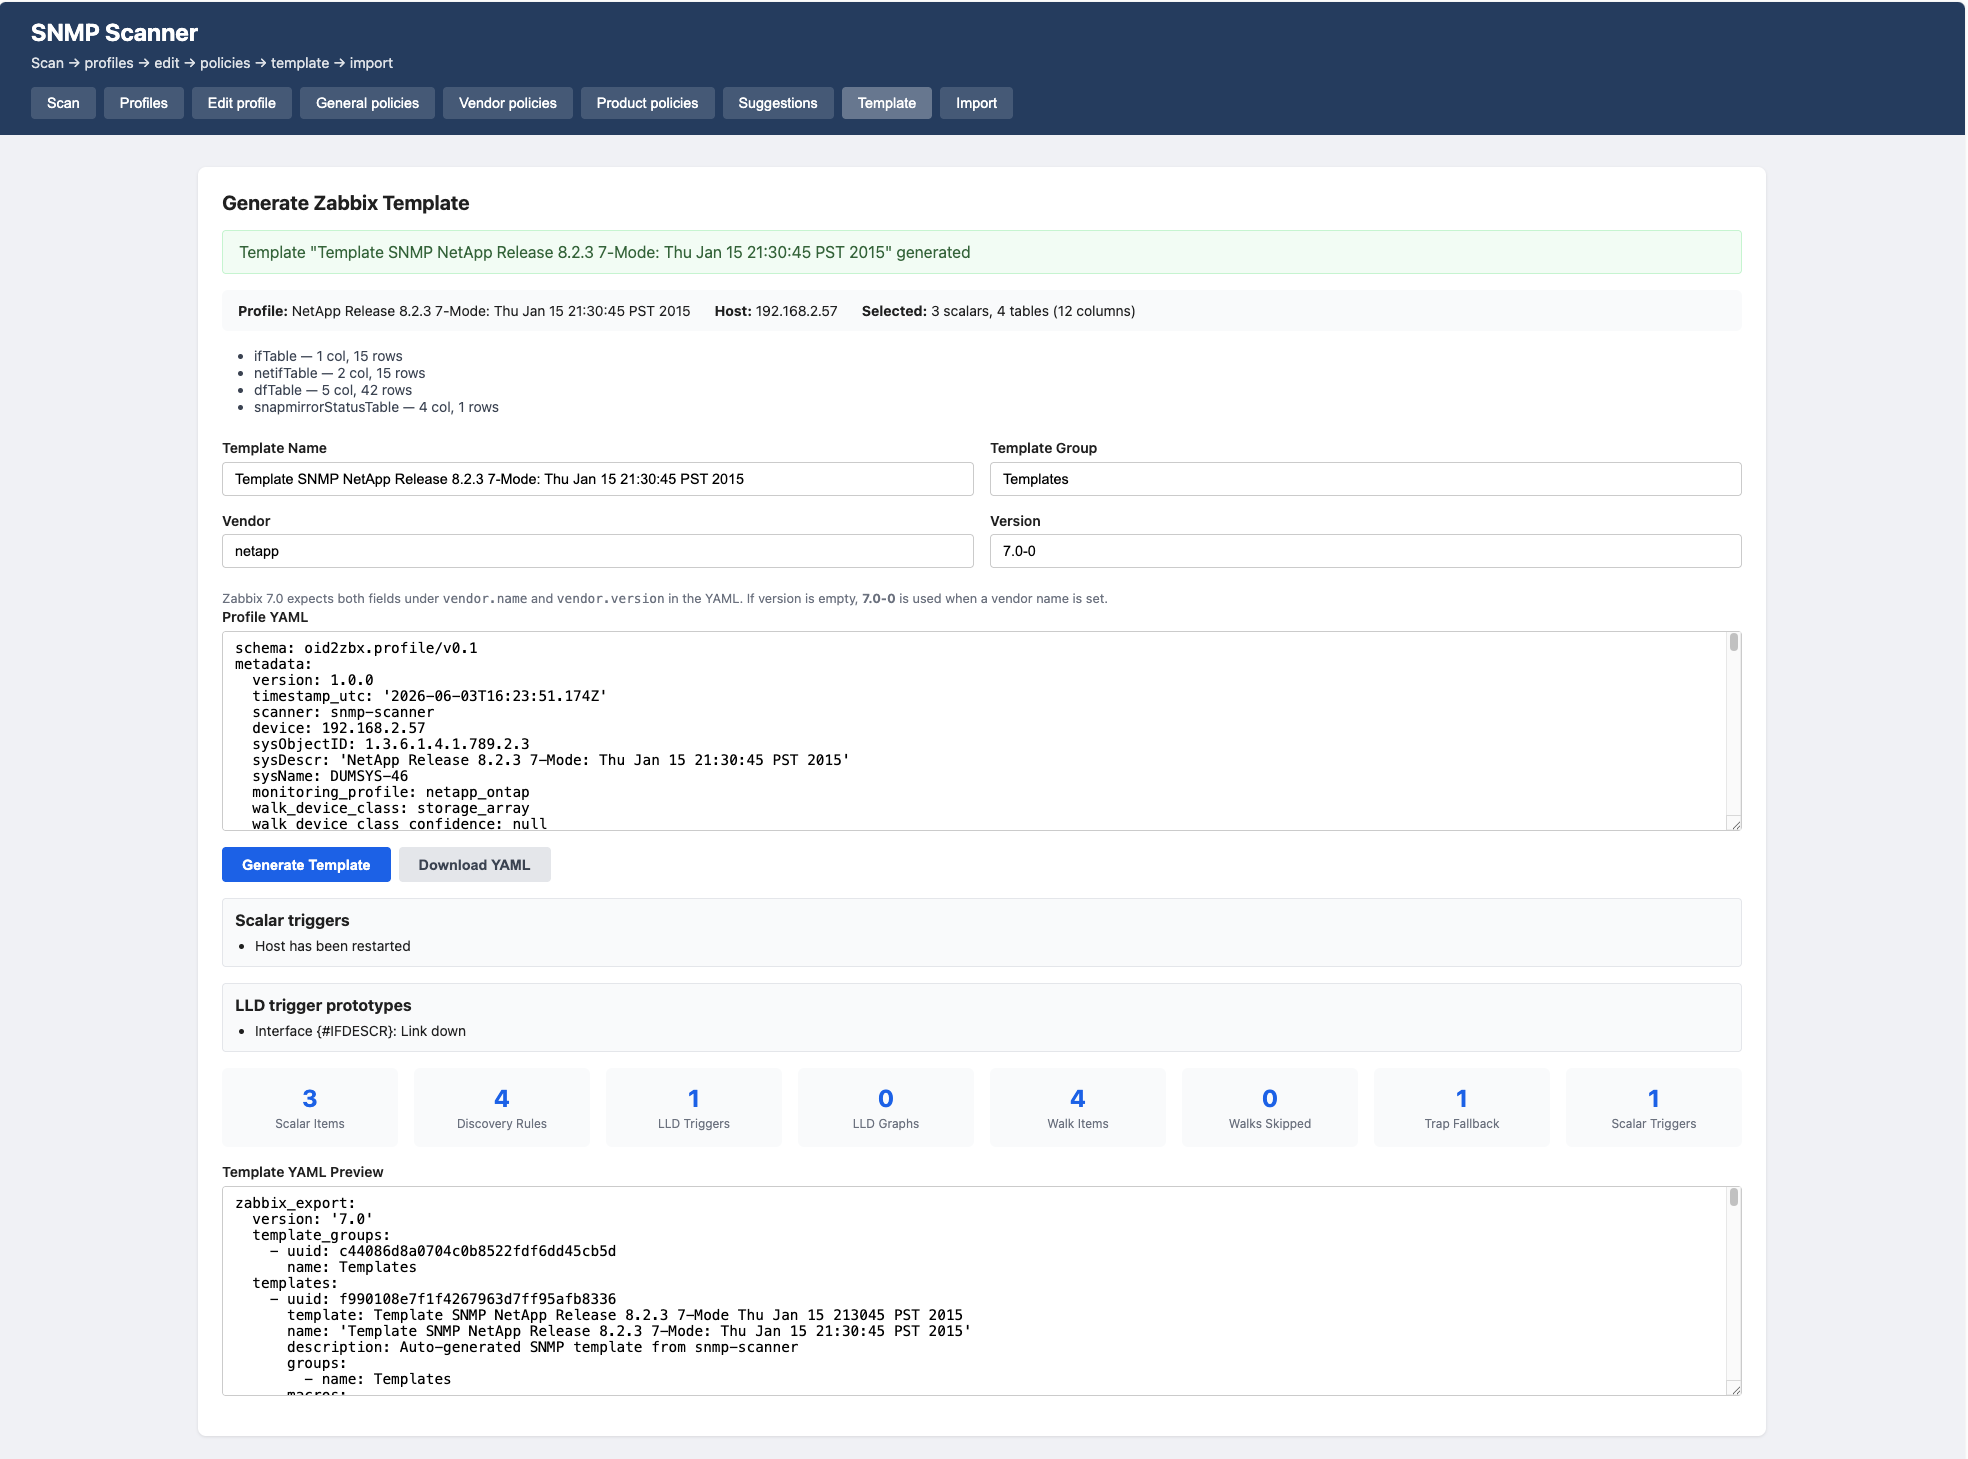
«Обнаружение — не то же самое, что пригодность для обхода».
Учимся у существующих систем мониторинга
Необработанные файлы MIB говорят, что производитель определил. Они не говорят, что операторы ставят на мониторинг.
Поэтому мы стали искать в другом месте — не зависимости времени выполнения, а предметные знания.
Официальные шаблоны Zabbix и шаблоны сообщества стали нашим основным источником для обогащения данных. На этапе разработки мы разбираем YAML шаблонов и объединяем метаданные по OID в пакеты устройств: ключи элементов данных, шаги предобработки, прототипы триггеров, преобразования значений. Во время сканирования из Zabbix ничего не загружается: знания версионируются в git и поставляются вместе с инструментом.
На основе информации других производителей из открытых источников мы построили собственную модель определения ОС — большую, проверенную в боях карту префиксов sysObjectID, паттернов sysDescr и отпечатков устройств, которая служит слоем подсказок для сопоставления с каталогом. Можно представить это так: «Тысячи развертываний уже классифицировали устройства такого вида».
Тот же принцип применяется к загрузке исторических данных из профилей других инструментов мониторинга: происхождение данных и согласованность между источниками важнее любого отдельного дерева производителя.
Вот вывод, который стоит взять на вооружение: существующие проекты мониторинга — это база знаний о том, что люди уже сочли достойным наблюдения.
Импорт MIB отвечает на вопрос «что существует». Шаблоны мониторинга отвечают на вопрос «что люди реально используют».
Наши сегодняшние приоритеты загрузки это отражают:
- Шаблоны Zabbix → отбор + ключи + триггеры
- Обходы SNMP → подтверждение того, что привязка работает на этом устройстве
- Каталог OID → идентификация (символ, метка, модуль MIB)
- Разбор MIB → только кандидаты!! никогда не рекомендуются автоматически сами по себе!!
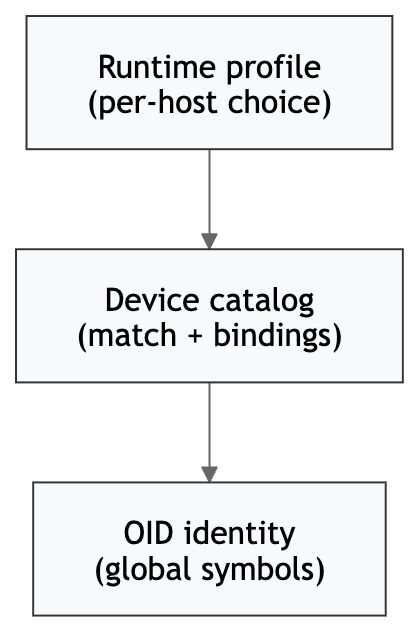
Наши слои знаний
От OID к метрикам: более масштабная переработка
Следующее узкое место оказалось семантическим, а не техническим.
Один и тот же смысл для мониторинга (загрузка CPU, SMART дисков, трафик интерфейсов) встречался под разными OID у разных производителей, в разных шаблонах и модулях MIB.
У нас были параллельные структуры: пресеты интеграций, каталоги OID, профили мониторинга, категории подсказок и оценка с привязкой к OID. Не было единой идентификации для понятия «что это измеряет».
Поэтому сейчас мы переходим к модели знаний, ориентированной на устройства:
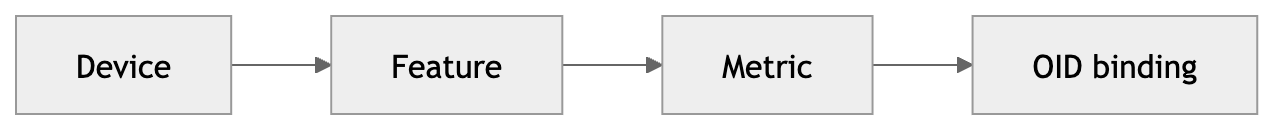
- Метрика — это смысл для мониторинга (cpu_utilization, disk_smart, if_in_octets).
- Привязка — это то, как эта метрика представлена в конкретном продукте.
- Идентификация OID остается глобальной, и файлы устройств ссылаются на нее.
Оценка намеренно разделена на три слоя:
| Слой | Вопрос | Хранится в git? |
| monitoring_value | Насколько важна эта метрика? | Да |
| binding_confidence | Работает ли эта привязка на этом устройстве? | Нет — данные сканирования |
| effective_score | Что выделить или выбрать автоматически сейчас? | Нет — только во время выполнения |
Оценку совпадения устройства и ранг метрики нельзя объединять. Выбор правильной модели коммутатора Cisco — это другая задача, нежели ранжирование метрик, которые должны войти в шаблон.
Мы также объединили примерно 830 устаревших пресетов интеграций в пакеты устройств в разрезе enterprise. Нативные отобранные пакеты там, где это возможно, объединенные черновики там, где нет. При этом обратная совместимость сохраняется через виртуальный слой адаптеров.
Панель Feature → Metric с ценностью для мониторинга, уровнем и итоговой оценкой.
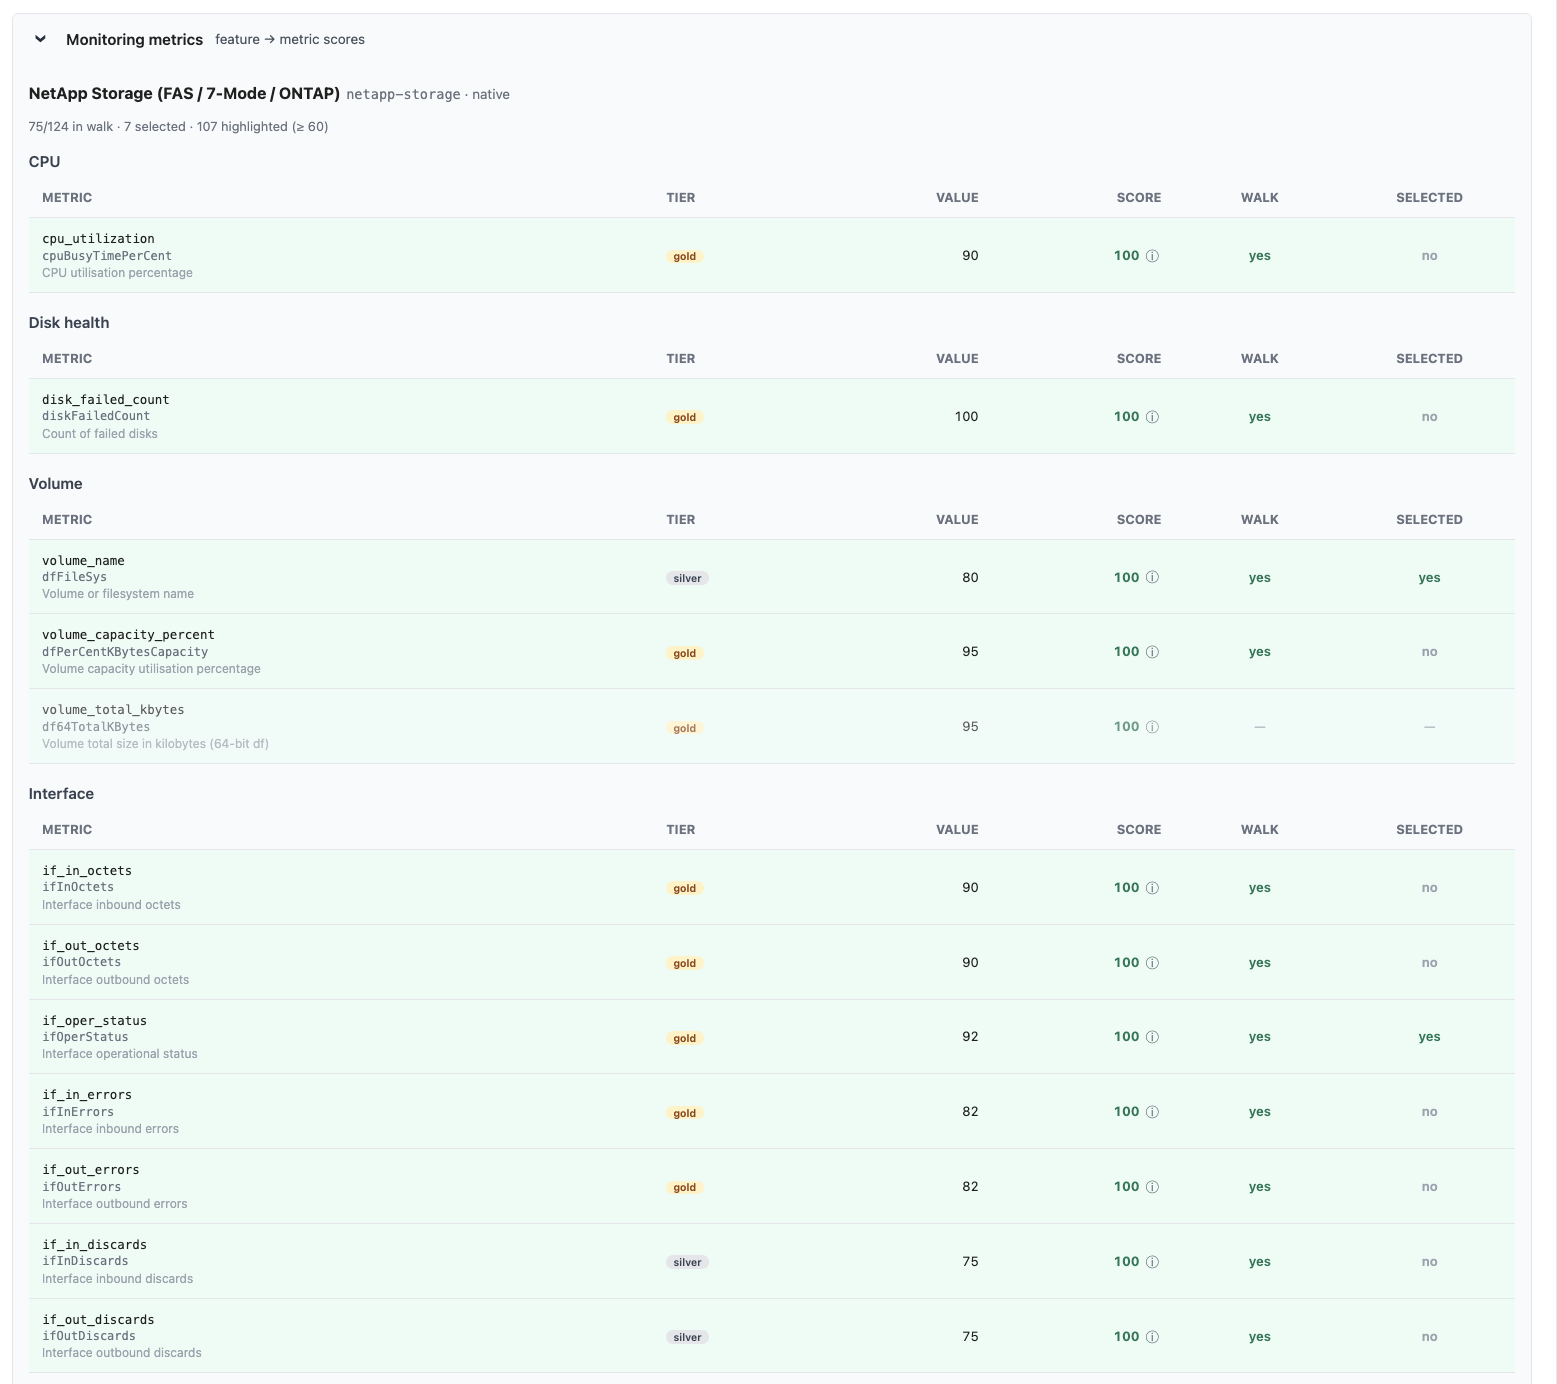
«Единица отбора — метрика, а не OID».
Извлеченные уроки
Вот уроки, которые нам стоило бы повесить на стену в первый же день.
Урок 1: большая часть данных SNMP — это не полезные данные мониторинга
Полный обход — это полный перечень того, что предоставляет агент. Хороший шаблон — это подмножество, выбранное для удобства эксплуатации. Если путать одно с другим, получаются шаблоны на 500 элементов данных, которые никто не поддерживает.
Урок 2: классификация устройств важнее обнаружения OID
Знание того, что перед вами устройство QNAP QTS 5, коммутатор Cisco IOS-XE или файловое хранилище NetApp FAS, сужает набор кандидатов сильнее, чем любая универсальная эвристика «интересных OID». Правила сопоставления по sysObjectID, sysDescr и enterprise ID работают лучше, чем одно лишь сопоставление по паттернам символов.
Урок 3: таблицы часто ценнее скалярных объектов
Скаляры дают имя узла сети и время работы. Таблицы дают интерфейсы, диски, датчики, вентиляторы и блоки питания — те самые структуры, для которых и было придумано LLD. Определение корней таблиц, обработка индексов и рецепты обхода заслуживали больше инженерного времени, чем выбор скаляров.
Урок 4: генерация всего подряд дает непригодные шаблоны
Нашей первой метрикой «успеха» было количество элементов данных. Наша полезная метрика — количество поддерживаемых элементов данных. Теперь мы применяем безопасную для шаблонов политику автовыбора: жесткие ограничения на число автоматически выбранных элементов данных, черновики из MIB никогда не выбираются автоматически, а постепенное обучение начинается только после повторного выбора пользователем.
Урок 5: хорошая фильтрация важнее хорошего обнаружения
Обнаружение показывает, что есть. Фильтрация показывает, что должно попасть в продуктивную среду. Глобальные списки запретов, подсказки по классу устройств, уровни ценности для мониторинга и ограничения размера обхода — это не второстепенные доработки, это и есть продукт.
Урок 6: существующие проекты мониторинга содержат ценные предметные знания
MIB необходимы. Шаблоны субъективны. Сочетание — это опыт шаблонов плюс подтверждения из обходов плюс идентификация из MIB, …. и это лучше любого отдельного источника.
Что наш snmp-scanner умеет сегодня
Если нужна конкретная картина, вот текущий рабочий процесс:
- Сканирование устройства (SNMPv2c/v3) или импорт существующего файла обхода
- Анализ структуры OID — скаляры, таблицы, выборки строк
- Сопоставление с пакетом устройства из каталога (~830 линеек устройств, которые объединяются в нативные пакеты)
- Предварительный выбор метрик через три слоя: универсальные значения по умолчанию, пресет устройства, эвристические подсказки
- Редактирование профиля обнаружения в интерфейсе — переключение выбора, настройка макросов, проверка ограничений обхода
- Экспорт шаблона Zabbix 7 в YAML и его импорт через API
Ключевые свойства:
- Полный обход, осознанный отбор: ничего не скрыто
- Знания в JSON в git: никакой базы данных во время выполнения, никакой загрузки на лету из внешних репозиториев
- LLD на основе обхода: для Zabbix 7
- Импорт MIB: для идентификации OID; черновики устройств на основе MIB для пакетов-кандидатов (проверяются куратором до повышения статуса)
- Обучение с привязкой к метрикам: повторный выбор пользователей влияет на ранжирование во время выполнения, но не на git, пока сопровождающий не повысит их статус
- Регрессионные фикстуры: изменения конвейера тестируются на анонимизированных обходах (NetApp, Palo Alto, Cisco и другие) без реального SNMP
Инструмент рассчитан сразу на две аудитории: на инженеров, которым нужно исследовать и отлаживать обход, и на инженеров, которым нужно быстрее выпустить шаблон для известного класса устройств.
Предпросмотр сгенерированного шаблона Zabbix + успешный импорт через API.
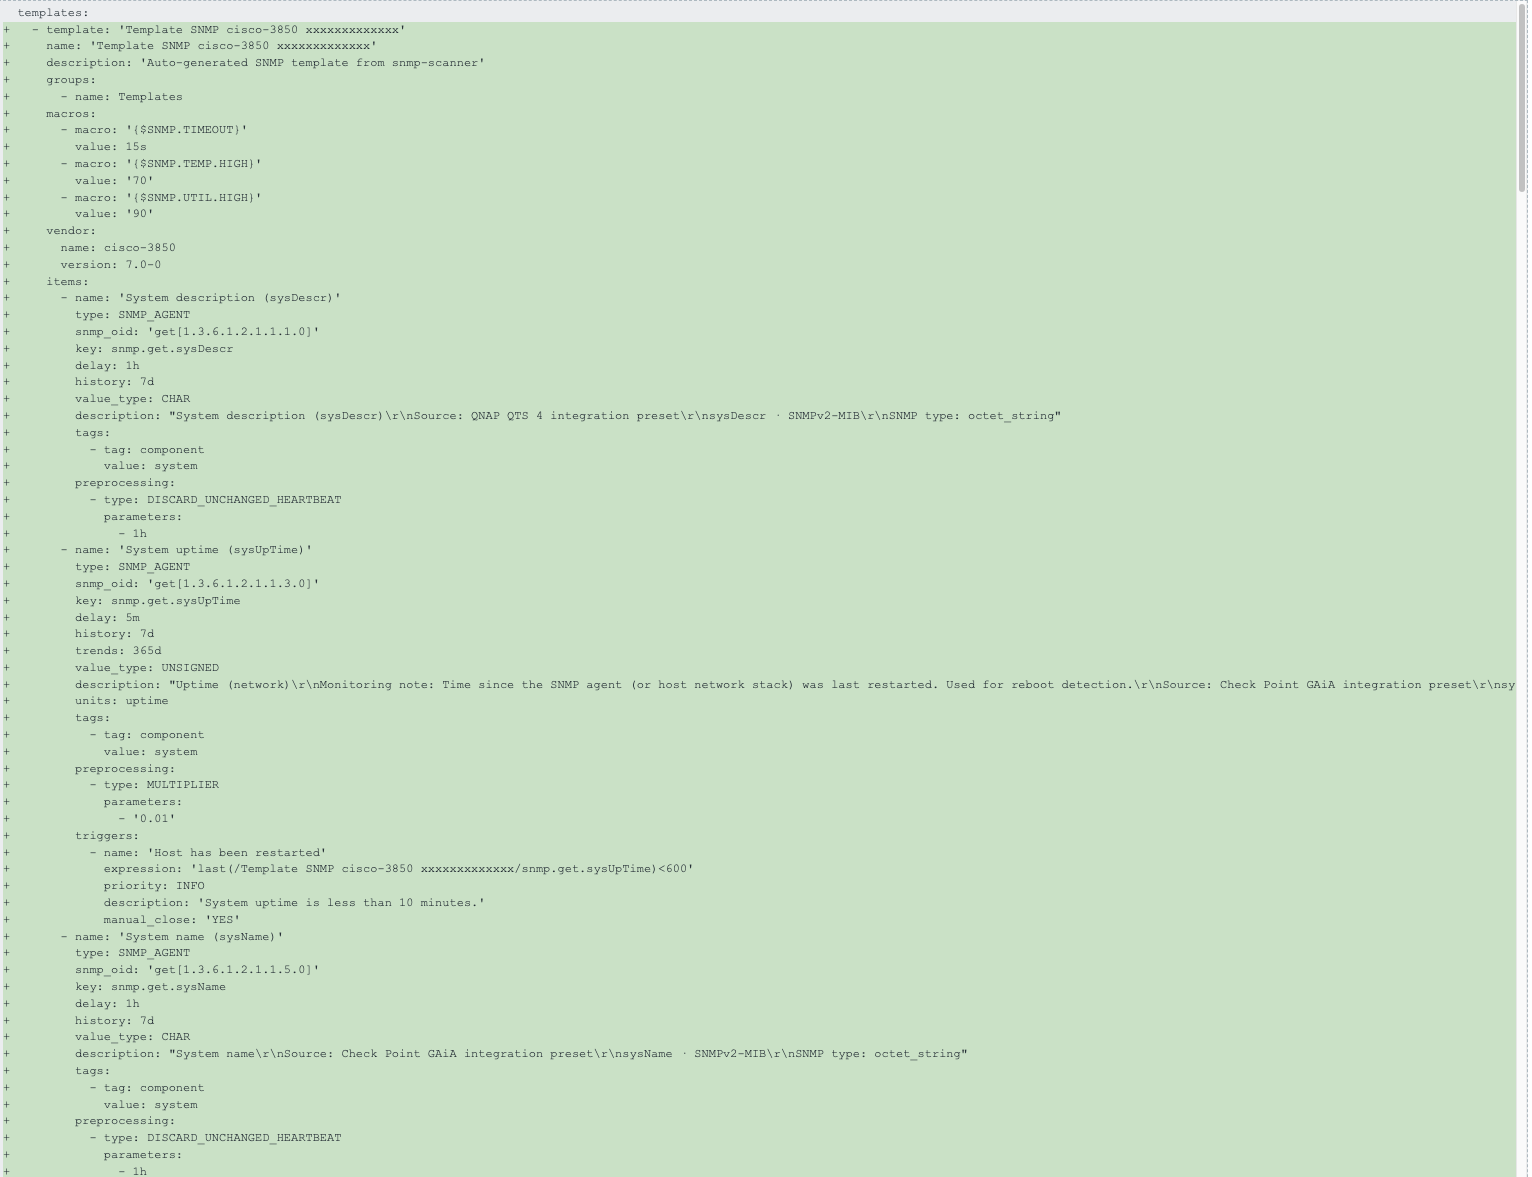
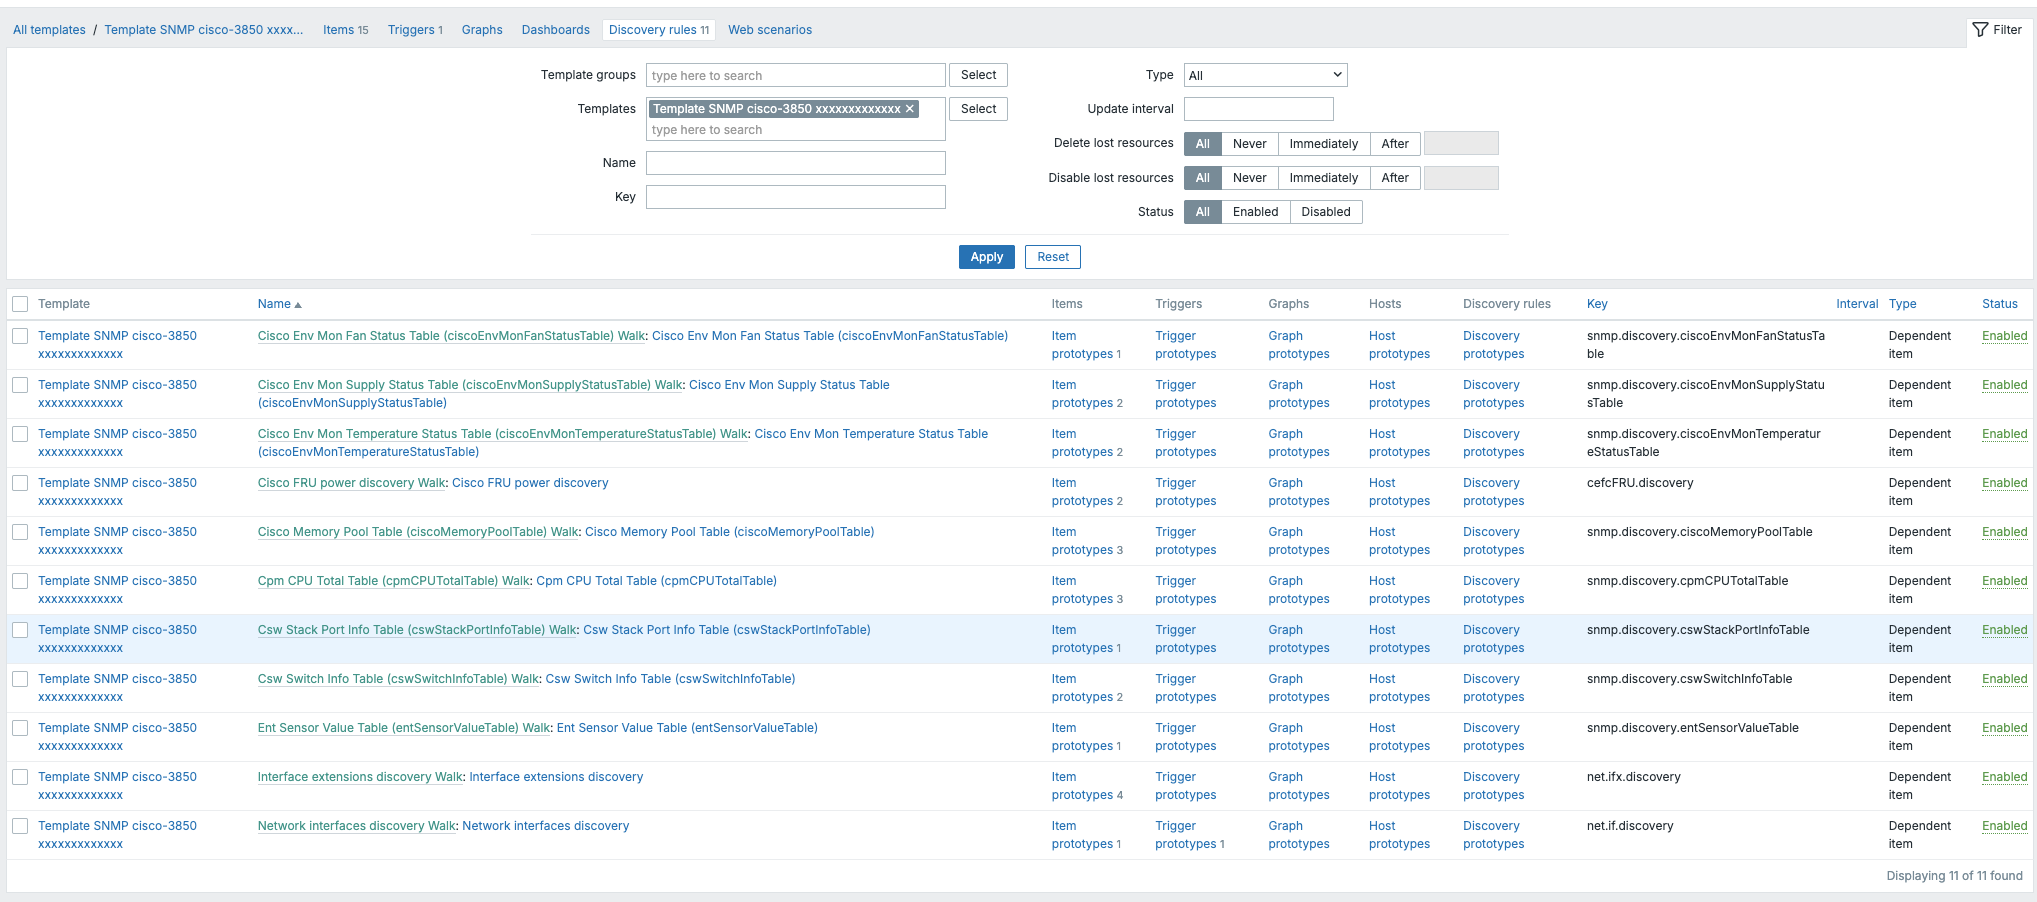
«От обхода до импортированного шаблона за один сеанс».
Где мы сейчас
Мы прошли фазу «найти OID» и глубоко погрузились в фазу «управлять автоматизацией».
Последние доработки сосредоточены на контролируемом автовыборе: первое сканирование учитывает только привязки default_selected, отобранные в git; повторные сканирования могут выполнять мягкий автовыбор, когда обучение на данных сообщества и итоговая оценка превышают пороги, всегда в пределах безопасных для шаблонов ограничений. Черновики из MIB остаются в статусе кандидатов, пока человек не повысит их статус.
Каталог находится в середине миграции: устаревшие JSON интеграций выводятся из использования в пользу канонических пакетов devices/*.json, с синтезом для обратной совместимости. Данные каталога OID шардированы для масштабирования. Определение ОС и обогащение из Zabbix работают наряду с нативными пакетами для производителей, по которым мы полностью выполнили обход и отбор, таких как Cisco, QNAP, NetApp, Palo Alto, Eaton, F5 и другие.
Мы честно признаем, чего автоматизация не делает: она не заменяет экспертного суждения при проектировании шаблонов. Она сокращает утомительную середину работы — разбор обхода, именование, определение таблиц, сопоставление пресетов и структуру элементов данных первого черновика.
Что дальше
Дорожная карта следует тому же принципу: больше интеллекта, больше защитных ограничений.
Улучшенная генерация триггеров: перенимать больше семантики прототипов триггеров из исходных шаблонов Zabbix; улучшить экспорт триггеров для скаляров и на уровне таблиц, выйдя за рамки стандартных триггеров вроде контроля времени работы.
Более интеллектуальная классификация метрик: расширить реестр метрик и таксономию функций (cpu, memory, disk_health, interface, psu, …). Выводить уровни из monitoring_value вместо параллельных систем оценки. Формализовать жизненный цикл привязки: candidate → known_good → recommended → blocked.
Рекомендации по мониторингу с помощью ИИ: идея в том, что ИИ, скорее всего, может служить ускорителем ранжирования и проверки, а не автономным автором шаблонов. Жесткие ограничения — размер обхода, адекватность триггеров, класс устройства, обнаружение дубликатов — носят структурный характер. ИИ может помочь классифицировать неоднозначные символы или предложить сопоставления метрик для проверки куратором; он не должен миновать лестницу подтверждений обход → шаблон → рекомендовано.
Доработка для эксплуатации: ограничения обхода для каждого типа таблиц (отдельно для интерфейсов, маршрутизации и ARP), поддержка SNMP trap / уведомлений и более понятный путь «перенести выбор из этого сканирования в каталог» в интерфейсе.
В заключение
Автоматическое обнаружение SNMP звучит как задача поиска. На практике это задача отбора, обернутая в задачу классификации, обернутую в задачу эргономики шаблонов.
Мы начали с попыток найти интересные OID. Инструмент остался полезным, потому что мы признали, что интересное ≠ пригодное для мониторинга, и построили систему, которая уважает и полноту обхода, и дисциплину шаблона.
Если перед вами свежий вывод snmpwalk, а подходящего шаблона Zabbix нет, это не значит, что вы не справляетесь с SNMP. Вы находитесь ровно на том шаге, где предметные знания важнее всего.
Автоматическое обнаружение SNMP — это не задача обнаружения. Это задача отбора, построенная на классификации и предметных знаниях.
Именно здесь нам помогает наш инструмент: обход на виду, кандидаты ранжированы, а путь к шаблону Zabbix 7 короче, чем полдня ручной археологии OID.
Если вам нужна помощь с миграцией или вы хотите применить лучшие практики масштабирования и оптимизации Zabbix, обращайтесь в OICTS. Мы — премиум-партнер Zabbix, работающий по всему миру, с офисами в США, Великобритании, в Нидерландах и Бельгии, и мы готовы помогать вам на каждом этапе.
 Prev Post