在生产环境中运行 Zabbix 这样的监控平台,需要具备可靠性和弹性。一旦监控解决方案宕机,您就等于在盲飞,而对于许多组织来说,这根本无法接受。本文介绍一种稳健的 Zabbix 高可用性(HA)架构,它使用 PostgreSQL、Patroni、etcd、HAProxy、keepalived 和 PgBackRest。该方案基于 RHEL 9 或其衍生版本构建,结合多种现代开源工具,提供自动故障切换、负载均衡和无缝监控,同时保持一致性和性能。
架构概览
该 HA 设计由多个协同工作的层组成,即使在节点或服务发生故障时也能保持连续性:
数据库集群层
2 个或更多节点组成 PostgreSQL 集群,由 Patroni 管理,并通过 etcd 进行协调。在任何时刻,都有一个节点是主节点(读/写),其他节点则是热备用节点,随时准备自动接管。
共识层
etcd 运行在相同的节点上,充当 Patroni 的分布式配置存储和协调层。它确保集群状态一致,并支持安全的故障切换决策。
负载均衡层
两个 HAProxy 节点为所有客户端(包括 Zabbix)提供单一入口,将请求路由到当前的 PostgreSQL 主节点。这些节点通过 Keepalived 进行监控和协调,以维护一个浮动虚拟 IP(VIP),确保在连接层实现无缝故障切换。
备份层
一台独立的备份服务器负责运行 PgBackRest,处理完整备份和增量备份、WAL 归档以及时间点恢复(PITR)。该服务器通过 SSH 与所有数据库节点进行安全通信。
监控层
两台 Zabbix server 以活动-备用模式运行,通过访问 PostgreSQL VIP 实现后端连接,持续监控该技术栈的所有层,包括 HAProxy 的健康状况、Patroni 集群角色和 etcd 状态。
这种多层架构确保任何单一故障,无论是数据库、负载均衡器还是监控服务器,都不会导致监控平台瘫痪。
为什么 HA 对 Zabbix 至关重要
Zabbix 高度依赖其 PostgreSQL 后端数据库。每个指标、触发器、事件和告警都存储在其中。如果 PostgreSQL 不可用,哪怕只是短暂中断,也可能导致数据丢失或出现监控盲区。因此,在为企业环境扩展 Zabbix 时,在数据库层引入 HA 是至关重要的一步。
虽然 Zabbix 本身支持应用层面的 HA,但该架构通过采用基于共识的现代集群技术和自动故障切换,确保后端数据库同样完全具备容错能力。
组件概览
为了实现 HA,我们整合了多个专用组件,每个组件都在系统中发挥着关键作用:
PostgreSQL
Zabbix 使用的关系型数据库引擎。在本示例部署中,它运行在三个节点上,组成一个由 Patroni 管理的集群。
Patroni
Patroni 是 PostgreSQL 集群的编排器。它监控节点健康状况、管理复制、在需要时提升备用节点,并确保任何时候都只存在一个可写的 leader。Patroni 借助分布式共识存储(本例中为 etcd,也可以使用其他 DCS)在整个集群中协调决策。
etcd
etcd 是一个轻量级、高可用的键值存储,Patroni 用它来维护集群状态。它存储 leader 选举数据、健康状态和锁。为方便起见,我们将其部署为三节点集群,与 PostgreSQL 节点部署在一起;不过,由于 etcd 对延迟非常敏感,必要时也可以独立扩展这一部署。
HAProxy
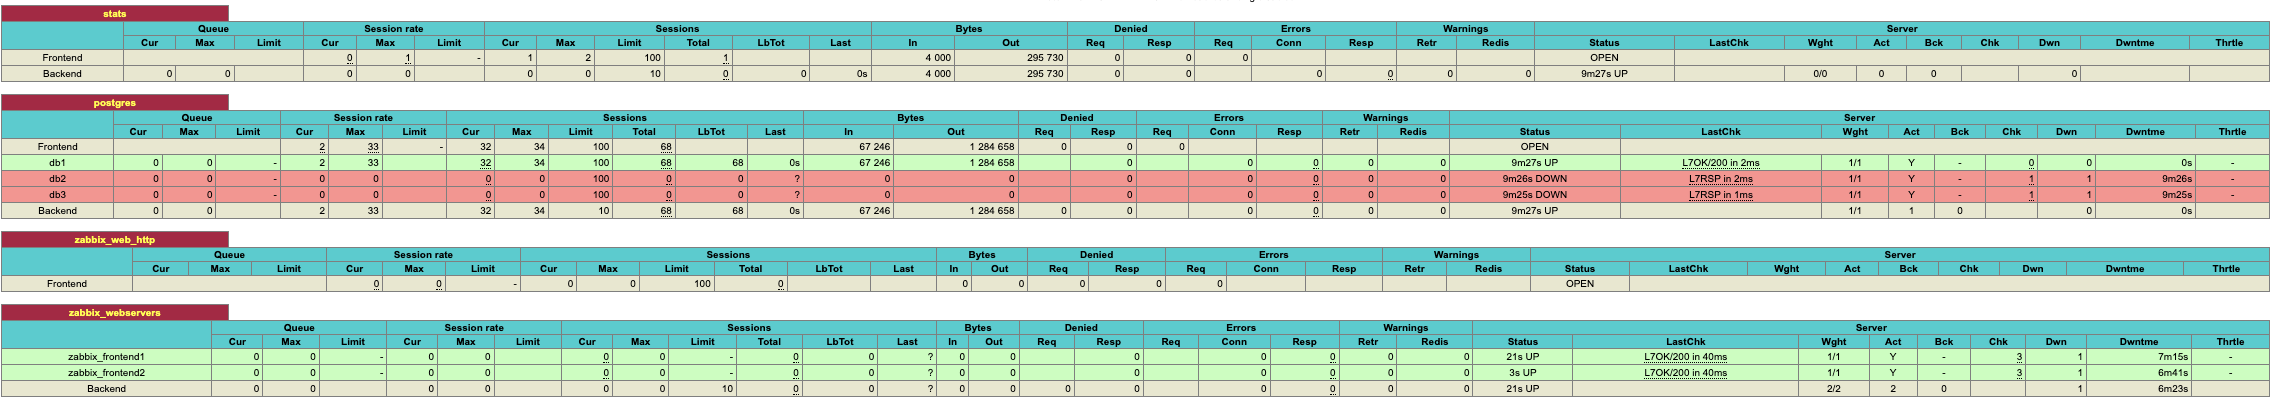
为了简化应用程序的连接,HAProxy 在数据库集群前端充当负载均衡器。它通过 Patroni 的 REST API 监控每个节点的角色,并将连接路由到当前活动的主服务器。如果 leader 发生故障,HAProxy 会自动将流量重新路由到新的主节点。
Keepalived
Keepalived 在各 HAProxy 节点之间提供一个浮动虚拟 IP 地址(VIP)。借助该 VIP,Zabbix 前端等客户端系统即使在某个 HAProxy 节点发生故障时,也能连接到一个稳定的 IP。
PgBackRest
为了保护数据本身,我们使用 PgBackRest 进行完整备份和增量备份,以及时间点恢复(PITR)。方案中还包含一台专用备份服务器,用于通过 SSH 安全地拉取并存储归档日志和备份。
Zabbix server
最后,我们以活动-备用模式运行两台 Zabbix server。两者都配置为通过 HAProxy 提供的 VIP 连接到 PostgreSQL 集群。Zabbix 前端也部署在这两个节点上,借助负载均衡的部署确保持续可访问。
拓扑概览
以下是该架构的简化视图:
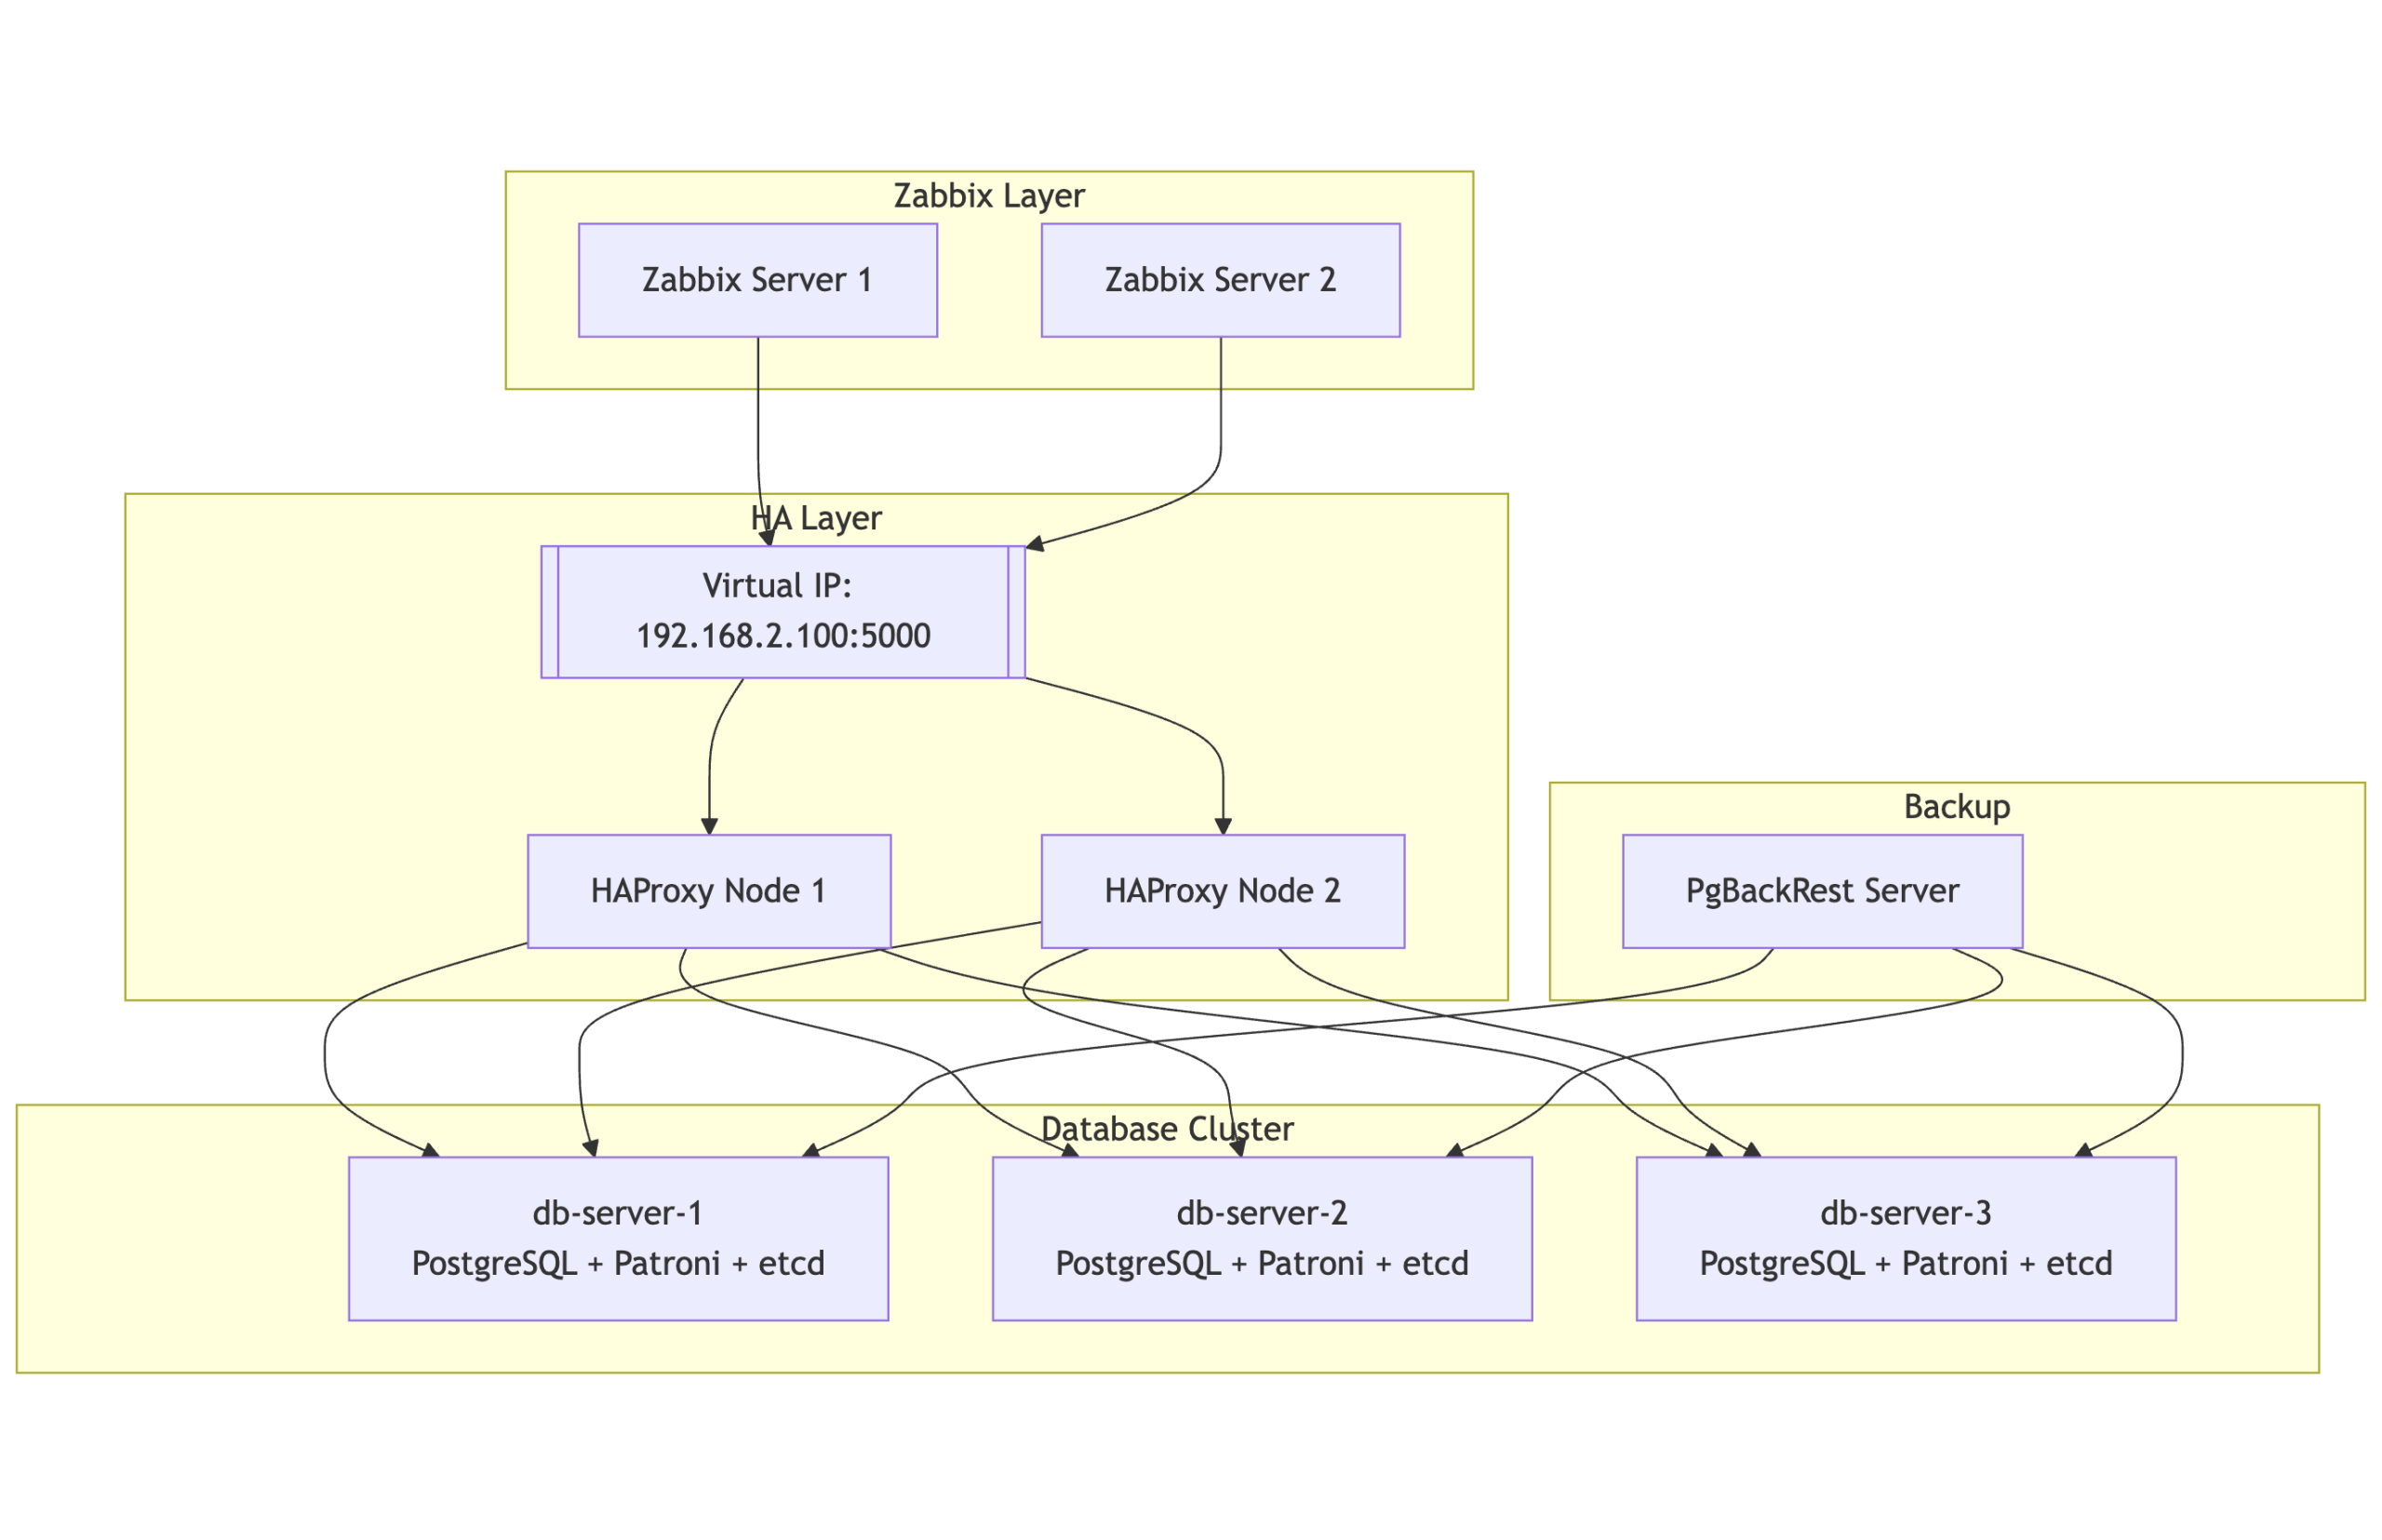
- 2 个或更多数据库节点(PostgreSQL + Patroni + etcd)
- 两个 HAProxy 节点,每个节点都配置了 Keepalived,用于管理浮动虚拟 IP
- 一个备份节点,用于 PgBackRest
- 两台 Zabbix server,指向 PostgreSQL VIP
所有系统通过一致的主机名映射、时间同步(Chrony)和服务监控联系在一起。
说明:
- PgBackRest 直接连接到全部三个 PostgreSQL 节点,因此无论哪个节点是主节点,它都能归档 WAL 段并拉取备份。
- 该设计支持从备用节点进行完整备份,并支持时间点恢复(PITR)。
- HAProxy 确保 Zabbix 始终与当前主节点通信,而 Patroni 和 etcd 负责自动故障切换和集群状态管理。
设计思路
该方案优先考虑弹性和自愈能力。即使任何单个组件(数据库节点、负载均衡器甚至监控服务器)发生故障,系统仍可继续运行。
将 Patroni 与 etcd 结合使用,可确保故障切换自动完成,无需人工干预。HAProxy 确保客户端流量始终被路由到当前主节点,而 Keepalived 则确保这一路由层本身也具备高可用性。
我们选择 PgBackRest,而不是简单的脚本或基础备份,因为它不仅提供高效的增量备份,还提供完整的 WAL 归档和时间点恢复,这对灾难恢复和调试都极为宝贵。
最后,我们选择将 Zabbix 本身集成到这一 HA 设计中,不仅将其视为一个应用程序,更将其视为一项完全具备弹性的服务,可以说,它能够监控自身。
实际部署考量
- 资源规划:虽然我们的节点运行得很顺畅,但要将该方案扩展到繁重的工作负载,需要仔细调优内存、I/O 和 PostgreSQL 参数。
- etcd 部署位置:虽然在本示例中 etcd 与数据库节点部署在一起,但对于大规模环境,最好将 etcd 分离到专用基础设施上。这样可以避免资源争用,并在极端故障场景下保持 quorum。
- 监控系统自身的监控:Zabbix 本身也必须受到监控。在我们的部署中,包括 etcd、Patroni 和 PostgreSQL 在内的每个组件都提供健康检查端点,Zabbix agent 或脚本可以利用这些端点,针对复制延迟、集群健康状况和故障切换事件生成告警。
结论
该架构为在容错、可用于生产的环境中运行 Zabbix 奠定了坚实基础。它不仅确保数据库层的高可用性,还提供了灵活性、可观测性和运维安全性。
无论您是在内部运行 infrastructure monitoring,还是以托管服务的形式提供 Zabbix,采用这种 HA 方案都可以消除单点故障,让您完全放心,而且所使用的全部是久经考验、获得广泛支持的开源技术。
如果您在迁移方面需要帮助,或希望确保在扩展和优化 Zabbix 时遵循最佳实践,请随时联系 OICTS。我们是一家业务遍及全球的 Zabbix 高级合作伙伴,在美国、英国、荷兰和比利时设有办事处,随时准备在每一步为您提供帮助。
 Prev Post