

En Zabbix, recolectar métricas es solo el primer paso del monitoreo. Al fin y al cabo, tener datos disponibles no significa, necesariamente, que estés protegiendo el entorno contra fallos. Lo que realmente marca la diferencia en la operación diaria son las alertas, ya que es a través de ellas como los problemas se perciben y se tratan a tiempo. En este escenario, quienes asumen el papel principal son los triggers.
Un trigger bien configurado logra identificar cuándo algo realmente se salió del comportamiento esperado y alerta solo cuando hay un riesgo real. Por otro lado, un trigger mal definido suele ser responsable de buena parte de los problemas en entornos de monitoreo, tales como alertas en exceso, falsos positivos y múltiples notificaciones para el mismo incidente.
En esta guía, vas a saber cómo funciona un trigger en Zabbix y aprenderás a crear expresiones más eficientes e inteligentes. El objetivo es reducir el ruido operacional, mejorar la calidad de las alertas y hacer que el monitoreo sea realmente útil en el día a día.
Qué es un trigger en Zabbix
De manera objetiva, un trigger es una regla lógica que evalúa los datos recolectados por un ítem y determina si existe o no un problema. Funciona como un filtro que analiza los valores y decide cuándo el comportamiento dejó de ser normal.
En Zabbix, este flujo sigue una secuencia bien definida:
Ítem → Trigger → Evento → Acción
El ítem es responsable de recolectar datos, como uso de CPU, memoria, disponibilidad de red o espacio en disco. El trigger evalúa estos datos de acuerdo con una expresión configurada. Cuando la condición del trigger se cumple, Zabbix genera un evento, que puede resultar en una acción — como el envío de email, mensaje en Teams o Slack, ejecución de scripts o apertura de un ticket.
Es importante destacar que un trigger no recolecta información por cuenta propia; solo analiza valores que ya fueron recolectados. Siempre que la condición configurada sea verdadera, el estado del trigger cambia a PROBLEM. Cuando esa condición deja de ser verdadera, el estado regresa a OK.
Una buena forma de entender este comportamiento es pensar en el trigger como la regla que responde constantemente a la pregunta: “¿Esto todavía está dentro de lo normal?”.
Expresiones de trigger
La expresión es el verdadero núcleo de un trigger. Es en ella donde defines exactamente en qué situación se disparará la alerta. Aunque pueda parecer compleja a primera vista, la lógica de las expresiones de trigger queda bastante clara cuando entendemos sus elementos básicos.
Funciones más usadas
Las funciones le dicen a Zabbix cómo analizar el valor del ítem. Las más comunes son:
last()– último valor recolectadoavg()– promedio en un períodomax()– mayor valor en un períodomin()– menor valor en un período
Ejemplo real – CPU alta
Trigger:
last(/Servidor Linux/system.cpu.util[,system]) > 90Lo que hace este trigger:
- Mira el último valor de CPU.
- Si es mayor que 90%, entra en PROBLEM.
Este tipo de trigger es simple, pero puede generar un falso positivo si la CPU se eleva por solo unos segundos.
Operadores lógicos
Los operadores funcionan como comparaciones comunes:
>mayor que<menor que=igual>=mayor o igual<=menor o igual<>diferente de
Ejemplo con promedio de 5 minutos:
avg(/Servidor Linux/system.cpu.util[,system],5m) > 85Aquí, el trigger solo se dispara si la CPU se mantiene alta por un período continuo, evitando alertas por picos momentáneos.
Uso de macros
Las macros hacen que los triggers sean más organizados y fáciles de mantener.
Ejemplo con macro de usuario:
avg(/Servidor Linux/system.cpu.util[,system],5m) > {$CPU_WARN}Ventajas:
- Cambias el valor de la macro sin la necesidad de editar varios triggers manualmente.
- La personalización se puede realizar por Host. Para realizar personalizaciones más robustas, es necesario aplicar el concepto de Macros de Contexto.
Severidad y estados
Todo trigger en Zabbix trabaja con dos conceptos fundamentales: estado y severidad.
El estado indica si el problema está activo o no. Cuando la condición configurada en el trigger se cumple, el estado cambia a PROBLEM. Cuando deja de cumplirse, el estado regresa a OK, generando un nuevo evento en el historial.
La severidad del trigger, por su parte, representa el impacto del problema en el entorno. No define a quién se le avisará ni la urgencia personal de la respuesta, pero ayuda en la priorización de los incidentes.
Por ejemplo, una CPU alta en un servidor de pruebas puede clasificarse como Warning, mientras que el mismo escenario en un servidor de producción crítico puede justificar una severidad High. Una clasificación correcta facilita el trabajo del equipo y evita que problemas menores reciban atención excesiva.
Recovery expression
Por defecto, el trigger vuelve a OK cuando la condición deja de ser verdadera. Sin embargo, puedes controlar esto a través de una recovery expression.
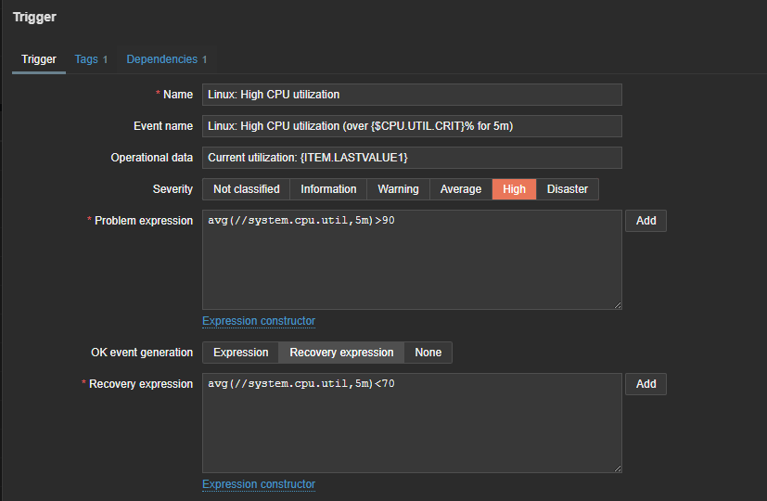
Así, el trigger solo se recupera cuando la CPU realmente se estabilice.
Combinando triggers en Zabbix
Combinar triggers es lo que realmente reduce los falsos positivos.
AND / OR en la práctica
Ejemplo real – CPU y memoria altas.
Trigger más inteligente:
(
  avg(/Servidor Linux/system.cpu.util[,system],5m) > 85
  AND
  avg(/Servidor Linux/vm.memory.utilization,5m) > 80
)
Lo que sucede:
- Si solo la CPU sube → no alerta.
- Si la CPU y la memoria suben → alerta.
Este tipo de trigger es mucho más confiable.
Dependencia entre triggers
La dependencia de triggers evita alertas en cascada.
Ejemplo – servidor no disponible.
Trigger de indisponibilidad:
max(/Servidor Linux/icmpping,3m) = 0Después de eso, defines que:
- Trigger de CPU
- Trigger de disco
- Trigger de memoria
dependen de esta trigger de ping.
Resultado:
- Si el servidor se cae, solo una trigger alerta.
- Evita decenas de notificaciones inútiles.
Triggers con múltiples ítems
Un trigger puede evaluar más de un ítem para validar el contexto.
Ejemplo:
(
  avg(/Servidor Linux/system.cpu.util[,system],5m) > 85
  AND
  last(/Servidor Linux/system.cpu.load[percpu,avg1]) > 5
)
Aquí, el trigger confirma:
- CPU alta en porcentaje.
- Load alto al mismo tiempo.
Esto reduce mucho los falsos positivos.
Ejemplos prácticos de uso de triggers en Zabbix
Ejemplo 1 – CPU + memoria
Escenario: la CPU sube rápido, pero pronto se normaliza.
Trigger simple (mala):
last(/Servidor Linux/system.cpu.util[,system]) > 90Trigger mejor:
(
  avg(/Servidor Linux/system.cpu.util[,system],5m) > 85
  AND
  avg(/Servidor Linux/vm.memory.utilization,5m) > 80
)
Resultado:
- Menos alertas innecesarias.
- Más confianza en la alerta.
Ejemplo 2 – Servicio no disponible con fallback
Trigger del servicio:
last(/Servidor Linux/service.httpd.status) <> 0Trigger de conectividad:
max(/Servidor Linux/icmpping,3m) = 0Puedes dejar el trigger del servicio dependiente del trigger de ping, evitando una falsa alerta cuando el host esté offline.
Ejemplo 3 – Evitando alertas en cascada
Trigger raíz:
max(/Servidor Linux/icmpping,3m) = 0Todas los demás triggers del host dependen de este trigger raíz.
Resultado:
- Una alerta clara.
- Diagnóstico rápido.
- Cero “spam” de notificaciones.
Buenas prácticas para el uso de triggers en Zabbix
Algunas prácticas simples mejoran mucho el monitoreo:
- Usa descripciones claras en los triggers.
- Evita
last()cuando los promedios tengan más sentido. - Usa dependencias siempre que sea posible.
- Prueba los triggers nuevas antes de enviarlas a producción.
- Revisa los triggers antiguas regularmente.
Recuerda: un trigger no es estático, debe evolucionar junto con el entorno.
Utiliza triggers para mejorar tu uso de Zabbix
Triggers bien configurados transforman a Zabbix en una herramienta estratégica. Ayudan a:
- Reducir el ruido;
- Evitar falsos positivos;
- Ganar confianza en las alertas.
Al aprender a combinar triggers, usar dependencias y evaluar múltiples ítems, sales del monitoreo reactivo y entras en un nivel mucho más maduro. Consulta siempre la documentación oficial de Zabbix para estar al tanto de las buenas prácticas en la herramienta.
¿Necesitas ayuda para llevar el monitoreo de tu empresa al siguiente nivel? Ponte en contacto con Zabbix, estamos a disposición para auxiliar con las mejores prácticas en monitoreo y observabilidad.
 Prev Post