En ambientes con operaciones 24×7, alertar no es suficiente. El punto crítico es alertar a la persona adecuada, en el canal adecuado y en el momento adecuado. Cuando esto no sucede, el equipo incluso recibe eventos, pero no necesariamente toma decisiones con rapidez. Aquí es donde los webhooks en Zabbix dejan de ser un recurso “extra” y pasan a ser parte de la arquitectura operacional.
Permiten transformar señales técnicas en comunicación útil para cada público, manteniendo el mismo evento con mensajes diferentes para quien ejecuta, para quien coordina y para quien responde por el negocio.
Veremos cómo estructurar notificaciones personalizadas para diferentes públicos (NOC, soporte, SRE, gestión y directiva), con ejemplos prácticos de envío vía correo electrónico, Microsoft Teams y Telegram. La propuesta es salir del modelo genérico y construir un flujo de notificación con claridad de responsabilidad, contexto y escalación.
Por qué salir del modelo estándar de notificación
Cuando todas las alertas van para todos, el resultado tiende a ser predecible: exceso de mensajes, baja atención a lo que realmente importa y pérdida de confianza en el canal de alerta. El equipo comienza a ignorar notificaciones repetitivas y los eventos relevantes pasan a competir con alertas de bajo impacto.
En el día a día, esto se traduce en:
- Ruido operacional;
- Baja prioridad percibida;
- Respuesta lenta en incidentes críticos;
- Desgaste entre operación y negocio.
La personalización resuelve este problema con reglas explícitas de enrutamiento y contexto: severidad, servicio impactado, ventana de notificación, equipo responsable y etapa de escalación. En lugar de un “broadcast”, creas una comunicación dirigida y con intención, reduciendo la fatiga de alertas y mejorando la calidad de la respuesta.
Cómo funcionan los webhooks en Zabbix
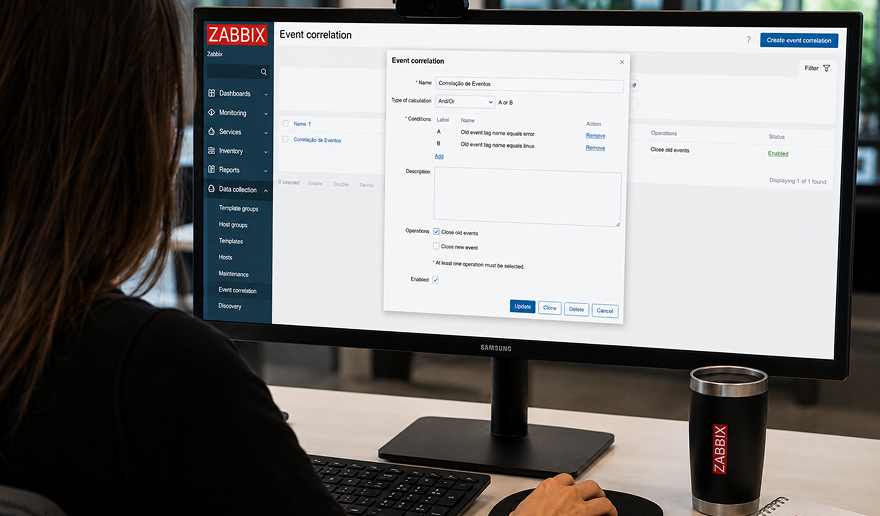
En Zabbix, un webhook es un Media Type que ejecuta una llamada HTTP a un endpoint externo (Teams, Telegram, sistema interno, ITSM, etc.). En la práctica, es el puente entre el evento técnico y el canal donde ocurre la acción.
El flujo básico es:
- Un trigger genera un evento;
- La Action evalúa condiciones (severidad, tags, horario, host group, servicio);
- La Action selecciona el Media Type (Webhook, Email, etc.);
- El payload se monta con macros del evento;
- El destino recibe la notificación y retorna un status.
Este diseño permite crear canales especializados sin acoplar toda la lógica dentro del trigger. El trigger sigue siendo responsable de detectar el problema técnico; la Action pasa a ser responsable de decidir “quién necesita saberlo, cuándo y con qué nivel de detalle”.
Paso a paso de la implementación en Zabbix
Un flujo práctico suele seguir este orden:
- Crear Media Types: Alerts > Media types para Email (SMTP), Teams (Webhook) y Telegram (Webhook/Bot API).
- Definir grupos de usuarios: Users > User groups (NOC, SRE, Soporte, Gestión, Directiva).
- Asociar medios a los usuarios: en cada usuario/grupo, definir qué canal recibe qué severidad.
- Estandarizar tags en los hosts/templates: garantizar team, service, env, criticality, notify.
- Configurar Actions: Alerts > Actions > Trigger actions con condiciones por severidad + tags + ventana.
- Definir escalación: operaciones en etapas (ej.: paso 1 Teams, paso 2 Telegram, paso 3 correo electrónico ejecutivo).
- Probar de extremo a extremo: simular trigger por severidad y validar entrega, formato y tiempo de respuesta.
Punto crítico: mantén las reglas de enrutamiento en las Actions y no dispersas en múltiples triggers. Esto facilita la gobernanza, simplifica la auditoría y reduce el retrabajo cuando la estructura de la empresa cambia.
También vale la pena tratar la capa de notificación como un producto interno: versionado de configuración, revisión por pares y criterios mínimos de calidad (tiempo de entrega, claridad del mensaje y cobertura de fallback).
Modelo de enrutamiento recomendado por público
Antes de configurar scripts, define tu matriz de comunicación. Este paso parece simple, pero suele ser lo que más reduce el ruido a lo largo del tiempo. El mismo incidente no necesita generar el mismo mensaje para todos los niveles de la organización.
Una segmentación objetiva suele funcionar así:
- NOC/SRE: alerta técnica completa, inmediata, con contexto de troubleshooting;
- Equipos de aplicación/soporte: alerta con impacto funcional y próximos pasos;
- Gestores: resumen ejecutivo del incidente, status y ETA;
- Directiva: comunicación corta, solo para eventos críticos confirmados.
Ejemplo de regla práctica:
- Warning y Average: Teams del equipo responsable;
- High: Teams + Telegram de la guardia;
- Disaster: Teams + Telegram + correo electrónico para gestión; directiva solo tras la confirmación del incidente.
Este modelo ayuda a mantener el equilibrio entre agilidad técnica y calidad de comunicación ejecutiva. El equipo operacional recibe profundidad; la gestión recibe objetividad; la directiva recibe contexto de decisión, sin ruido.
Estructurando tags para la personalización
La mejor forma de mantener la escala es usar tags de evento para el enrutamiento. Cuando la estrategia depende solo del host o template, cualquier crecimiento del ambiente se convierte en un costo operacional. Con tags, desacoplas la notificación de la infraestructura y acercas la alerta a la lógica de negocio.
Una base útil de tags incluye:
- team=infra|app|db
- service=checkout|billing|core-db
- env=prod|stg
- criticality=high|medium|low
- notify=ops|mgmt|board
Con esto, las Actions dejan de depender de reglas rígidas por host y pasan a usar el contexto del servicio. La ganancia es grande en escenarios híbridos, multiambiente y con equipos distribuidos.
Como práctica de gobernanza, define un “catálogo de tags” con nombres aceptados, valores válidos y responsables de su mantenimiento. Este catálogo evita variaciones de escritura (prod, production, prd) que rompen las reglas de forma silenciosa.
Personalización de mensajes con macros
Las macros permiten enriquecer notificaciones sin duplicar la configuración. El objetivo no es enviar mensajes largos, sino mensajes suficientes para la toma de decisiones en el primer contacto.
Un buen template debe responder rápidamente: qué sucedió, dónde sucedió, cuál es el impacto y cuál es el siguiente paso. Las macros a continuación cubren gran parte de este escenario:
{HOST.NAME}{TRIGGER.NAME}{TRIGGER.SEVERITY}{EVENT.DATE} {EVENT.TIME}{ITEM.LASTVALUE}{TRIGGER.URL}{EVENT.TAGS.<tag>}
Template técnico (NOC/SRE):
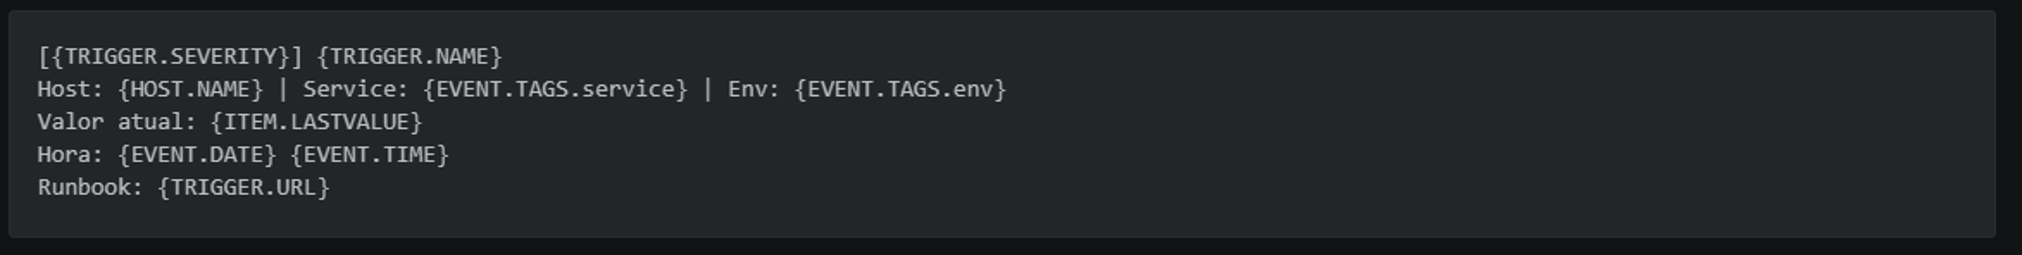
[{TRIGGER.SEVERITY}]
{TRIGGER.NAME}
Host: {HOST.NAME} | Service: {EVENT.TAGS.service} | Env: {EVENT.TAGS.env}
Valor actual: {ITEM.LASTVALUE}
Hora: {EVENT.DATE} {EVENT.TIME}
Runbook: {TRIGGER.URL}
Template ejecutivo (gestión/directiva):

Incidente {TRIGGER.SEVERITY} en el servicio {EVENT.TAGS.service} ({EVENT.TAGS.env})
Impacto: indisponibilidad/degradación confirmada
Status: equipo trabajando
Próxima actualización: en 15 min
2) Microsoft Teams (canal principal de operación)
1) Correo electrónico (comunicación formal y traza de auditoría)
Usa el Media Type SMTP para comunicación que requiera historial, trazabilidad y un formato más institucional. En muchas empresas, el correo electrónico sigue siendo el canal oficial para la gestión de crisis y el registro de decisiones.
Aplicaciones comunes:
- Notificaciones gerenciales;
- Resúmenes de incidentes;
- Cierres post-incidente.
Buenas prácticas:
- Asunto estandarizado con severidad y servicio;
- Cuerpo en HTML simple con bloques de “Impacto”, “Status”, “Próximos pasos”;
- Envío en lotes para grupos (noc@, gestao@, diretoria@) según la criticidad.
Ejemplo simple de correo electrónico HTML para gerencia/directiva:

Asunto sugerido: [High] Incidente en el servicio {EVENT.TAGS.service} ({EVENT.TAGS.env})
<html>
 <body style="margin:0;padding:0;background:#f4f6f8;font-family:Arial,sans-serif;color:#1f2937;">
   <table role="presentation" width="100%" cellpadding="0" cellspacing="0" style="padding:24px 0;">
     <tr>
       <td align="center">
         <table role="presentation" width="620" cellpadding="0" cellspacing="0" style="background:#ffffff;border:1px solid #e5e7eb;border-radius:8px;overflow:hidden;">
           <tr>
             <td style="background:#bb133e;color:#ffffff;padding:16px 20px;font-size:18px;font-weight:bold;">
               Incidente {TRIGGER.SEVERITY} - {EVENT.TAGS.service}
             </td>
           </tr>
           <tr>
             <td style="padding:20px;">
               <p style="margin:0 0 12px 0;font-size:14px;line-height:1.5;">
                  Se identificó un incidente en el ambiente <strong>{EVENT.TAGS.env}</strong>.
               </p>

               <table role="presentation" width="100%" cellpadding="8" cellspacing="0" style="border-collapse:collapse;font-size:13px;">
                 <tr>
                   <td style="border:1px solid #e5e7eb;background:#f9fafb;"><strong>Servicio</strong></td>
                   <td style="border:1px solid #e5e7eb;">{EVENT.TAGS.service}</td>
                 </tr>
                 <tr>
                   <td style="border:1px solid #e5e7eb;background:#f9fafb;"><strong>Host</strong></td>
                   <td style="border:1px solid #e5e7eb;">{HOST.NAME}</td>
                 </tr>
                 <tr>
                   <td style="border:1px solid #e5e7eb;background:#f9fafb;"><strong>Horario</strong></td>
                   <td style="border:1px solid #e5e7eb;">{EVENT.DATE} {EVENT.TIME}</td>
                 </tr>
                 <tr>
                   <td style="border:1px solid #e5e7eb;background:#f9fafb;"><strong>Status</strong></td>
                   <td style="border:1px solid #e5e7eb;">Equipo técnico trabajando. Próxima actualización en 15 minutos.</td>
                 </tr>
               </table>

               <p style="margin:16px 0 0 0;font-size:13px;line-height:1.5;">
                <strong>Impacto:</strong> degradación/indisponibilidad del servicio monitoreado.
               </p>
               <p style="margin:8px 0 0 0;font-size:13px;line-height:1.5;">
                <strong>Runbook:</strong> <a href="{TRIGGER.URL}" style="color:#0b57d0;">{TRIGGER.URL}</a>
               </p>
             </td>
           </tr>
           <tr>
             <td style="background:#f9fafb;padding:12px 20px;font-size:12px;color:#6b7280;">
               Mensaje automático enviado por Zabbix para seguimiento ejecutivo.
             </td>
           </tr>
         </table>
       </td>
     </tr>
   </table>
 </body>
</html>
2) Microsoft Teams (canal principal de operación)
Usa webhook de canal para una respuesta rápida de squads y personal de guardia. Teams funciona muy bien como canal de coordinación porque concentra conversación, actualización y enlace de recursos operacionales en el mismo lugar.
Estrategia recomendada:
- 1 canal por equipo operacional;
- 1 canal de incidentes críticos;
- Cards con campos cortos: severidad, servicio, ambiente, enlace de runbook;
- Threads para la actualización de incidentes en curso.
Payload típico (resumido):
{
 "text": "[High] API Checkout con latencia elevada en prod. Host: app-api-03. Runbook: https://..."
}
3) Telegram (guardia y contingencia móvil)
Ideal para el personal on-call cuando el equipo está fuera del escritorio. Telegram es particularmente útil en incidentes fuera del horario comercial, cuando la velocidad de activación pesa más que la riqueza de formato.
Buenas prácticas:
- Bots por dominio (infra/app/db) o por ambiente crítico;
- Mensajes objetivos para evitar la fatiga;
- Usar como canal de urgencia, no como log completo del incidente.
Payload típico para Bot API:
{
 "chat_id": "-1001234567890",
 "text": "[Disaster] Base de datos principal no disponible en prod. Equipo DB activado."
}
Ejemplo de diseño de Action en Zabbix
Estructura las Actions por etapas:
- Detección inicial: Teams del equipo dueño del servicio (condición por team + severidad).
- Escalación por tiempo: si no hay ACK en X minutos, incluir Telegram de la guardia (on-call).
- Escalación ejecutiva: solo para High/Disaster confirmados, enviar correo electrónico a la gestión.
- Comunicación a la directiva: habilitar solo con la tag notify=board o status de incidente mayor.
Este modelo reduce el ruido, mejora la previsibilidad y deja claro cuándo entra cada público en el flujo. Además, facilita la auditoría: puedes explicar por qué se envió una notificación, a quién y en qué etapa.
Una recomendación práctica es registrar las reglas de escalación en un documento único (runbook de comunicación), incluyendo a los responsables de su actualización. Así, un cambio de equipo o de estructura no rompe la política de alertas.
Caso práctico de operación
Escenario: evento High en service=checkout en el ambiente prod.
- Zabbix envía mensaje por Teams a #squad-checkout;
- Tras 10 min sin ACK, envía Telegram al personal de guardia;
- Si se confirma el impacto, dispara correo electrónico a la gestión con un resumen ejecutivo;
- La directiva recibe notificación solo en caso de indisponibilidad material del servicio.
Resultado esperado:
- Menor MTTA (tiempo de reconocimiento);
- Menor ruido para públicos no técnicos;
- Mejor calidad de la comunicación en incidentes críticos.
Cuando el flujo está bien implementado, la principal ganancia no es solo “avisar más rápido”, sino coordinar mejor. Cada audiencia recibe información en el nivel correcto, en el tiempo correcto, y eso reduce el retrabajo durante el incidente.
Buenas prácticas para mantener el modelo saludable
- Versionar scripts de webhook en un repositorio;
- Estandarizar la nomenclatura de tags y templates;
- Monitorear fallos de entrega de los propios webhooks;
- Definir fallback (ej.: falló Teams, activa correo electrónico);
- Revisar las reglas con cada cambio de estructura organizacional;
- Ejecutar pruebas periódicas de notificación por severidad y canal.
Además de la lista anterior, establece una rutina de revisión mensual con operación y gestión para validar si la política de notificación aún representa la realidad del ambiente. Los servicios cambian, las responsabilidades cambian, y las Actions deben acompañar ese movimiento.
Conclusión sobre el uso de webhooks en Zabbix
Los webhooks en Zabbix forman parte de la capa que transforma un evento técnico en un mensaje accionable para cada audiencia de la organización. No basta con detectar el problema rápido, es necesario comunicar con claridad para que la respuesta ocurra en el tiempo esperado.
Cuando los mensajes están bien estructurados con tags, macros y reglas de escalación, el equipo técnico recibe profundidad para actuar, mientras que la gestión y la directiva reciben contexto objetivo para la toma de decisiones. El resultado es una comunicación más útil, con menos ambigüedad y menor retrabajo durante el incidente.
La reducción de ruido también es una ganancia central. En lugar de notificar a todos sobre todo, el modelo dirige cada severidad al público correcto, en el canal correcto y en la etapa correcta. Esto reduce la fatiga de alertas, aumenta la atención a los eventos críticos y mejora indicadores como el tiempo de reconocimiento y el tiempo de respuesta.
Desde el punto de vista de la gobernanza, Zabbix también ofrece trazabilidad de las notificaciones enviadas: historial de eventos, acciones ejecutadas, destinatarios, contenido del mensaje y status de envío. Esta traza de auditoría fortalece el análisis post-incidente, facilita la rendición de cuentas ante la gestión y apoya los requisitos de compliance sin depender de controles paralelos.
En resumen, la personalización de notificaciones con webhooks coloca a Zabbix en un nivel más estratégico: además de monitorear, pasa a sostener un proceso de comunicación operacional maduro, medible y alineado con el negocio.
¿Quieres transformar el flujo de notificaciones de tu ambiente?
Si tu operación sufre por exceso de alertas, ruido en las comunicaciones o demora en la respuesta a incidentes críticos, nuestros especialistas pueden ayudarte a diseñar una arquitectura de monitoreo personalizada y eficiente para tu empresa.
Habla con nuestros especialistas y descubre cómo optimizar la comunicación entre NOC, equipos técnicos y gestión.
 Prev Post