

No Zabbix, coletar métricas é apenas o primeiro passo do monitoramento. Afinal, ter dados disponíveis não significa, necessariamente, que você está protegendo o ambiente contra falhas. O que realmente faz a diferença na operação diária são os alertas, pois é por meio deles que os problemas são percebidos e tratados a tempo. Nesse cenário, quem assume o papel principal são as triggers.
Uma trigger bem configurada consegue identificar quando algo realmente saiu do comportamento esperado e alerta apenas quando há um risco real. Por outro lado, uma trigger mal definida costuma ser responsável por boa parte dos problemas em ambientes de monitoramento, tais como alertas em excesso, falsos positivos e múltiplas notificações para o mesmo incidente.
Neste guia, você vai entender como uma trigger funciona no Zabbix e aprender a criar expressões mais eficientes e inteligentes. O objetivo é reduzir o ruído operacional, melhorar a qualidade dos alertas e tornar o monitoramento realmente útil no dia a dia.
O que é uma trigger no Zabbix
De maneira objetiva, uma trigger é uma regra lógica que avalia os dados coletados por um item e determina se existe ou não um problema. Ela funciona como um filtro que analisa os valores e decide quando o comportamento deixou de ser normal.
No Zabbix, esse fluxo segue uma sequência bem definida:
Item → Trigger → Evento → Ação
O item é responsável por coletar dados, como uso de CPU, memória, disponibilidade de rede ou espaço em disco. A trigger avalia esses dados de acordo com uma expressão configurada. Quando a condição da trigger é atendida, o Zabbix gera um evento, que pode resultar em uma ação — como o envio de e‑mail, mensagem no Teams ou Slack, acionamento de scripts ou abertura de um chamado.
É importante destacar que uma trigger não coleta informações por conta própria; ela apenas analisa valores que já foram coletados. Sempre que a condição configurada for verdadeira, o estado da trigger muda para PROBLEM. Quando essa condição deixa de ser verdadeira, o estado retorna para OK.
Uma boa forma de entender esse comportamento é pensar na trigger como a regra que responde constantemente à pergunta: “Isso ainda está dentro do normal?”.
Expressões de trigger
A expressão é o verdadeiro núcleo de uma trigger. É nela que você define exatamente em que situação o alerta será disparado. Embora possa parecer complexa à primeira vista, a lógica das expressões de trigger fica bastante clara quando entendemos seus elementos básicos.
Funções mais usadas
As funções dizem ao Zabbix como analisar o valor do item. As mais comuns são:
last()– último valor coletadoavg()– média em um períodomax()– maior valor em um períodomin()– menor valor em um período
Exemplo real – CPU alta
Trigger:
last(/Servidor Linux/system.cpu.util[,system]) > 90O que essa trigger faz:
- Olha o último valor de CPU.
- Se for maior que 90%, entra em PROBLEM.
Esse tipo de trigger é simples, mas pode gerar falso positivo se a CPU subir por apenas alguns segundos.
Operadores lógicos
Os operadores funcionam como comparações comuns:
>maior que<menor que=igual>=maior ou igual<=menor ou igual<>diferente de
Exemplo com média de 5 minutos:
avg(/Servidor Linux/system.cpu.util[,system],5m) > 85Aqui, a trigger só dispara se a CPU ficar alta por um período contínuo, evitando alertas por picos momentâneos.
Uso de macros
As macros deixam as triggers mais organizadas e fáceis de manter.
Exemplo com macro de usuário:
avg(/Servidor Linux/system.cpu.util[,system],5m) > {$CPU_WARN}Vantagens:
- Você altera o valor da macro sem a necessidade de editar várias triggers manualmente.
- A customização pode ser realizada por Host. Para realizar customizações mais robustas, é necessário aplicar o conceito de Macros de Contexto.
Severidade e estados
Toda trigger no Zabbix trabalha com dois conceitos fundamentais: estado e severidade.
O estado indica se o problema está ativo ou não. Quando a condição configurada na trigger é atendida, o estado muda para PROBLEM. Quando ela deixa de ser satisfeita, o estado retorna para OK, gerando um novo evento no histórico.
A severidade da trigger, por sua vez, representa o impacto do problema no ambiente. Ela não define quem será avisado ou a urgência pessoal da resposta, mas ajuda na priorização dos incidentes.
Por exemplo, uma CPU alta em um servidor de testes pode ser classificada como Warning, enquanto o mesmo cenário em um servidor de produção crítico pode justificar uma severidade High. Uma classificação correta facilita o trabalho da equipe e evita que problemas menores recebam atenção excessiva.
Recovery expression
Por padrão, a trigger volta para OK quando a condição deixa de ser verdadeira. No entanto, você pode controlar isso através de uma recovery expression.
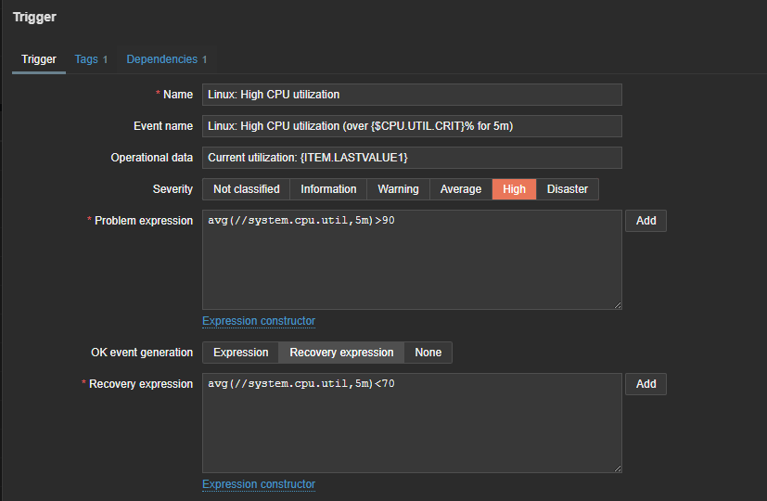
Assim, a trigger só se recupera quando a CPU realmente estabilizar.
Combinando triggers no Zabbix
Combinar triggers é o que realmente reduz os falsos positivos.
AND / OR na prática
Exemplo real – CPU e memória altas.
Trigger mais inteligente:
(
  avg(/Servidor Linux/system.cpu.util[,system],5m) > 85
  AND
  avg(/Servidor Linux/vm.memory.utilization,5m) > 80
)
O que acontece:
- Se só a CPU subir → não alerta.
- Se CPU e memória subirem → alerta.
Esse tipo de trigger é muito mais confiável.
Dependência entre triggers
A dependência de triggers evita alertas em cascata.
Exemplo – servidor indisponível.
Trigger de indisponibilidade:
max(/Servidor Linux/icmpping,3m) = 0Depois disso, você define que:
- Trigger de CPU
- Trigger de disco
- Trigger de memória
dependem dessa trigger de ping.
Resultado:
- Se o servidor cair, apenas uma trigger alerta.
- Evita dezenas de notificações inúteis.
Triggers com múltiplos itens
Uma trigger pode avaliar mais de um item para validar o contexto.
Exemplo:
(
  avg(/Servidor Linux/system.cpu.util[,system],5m) > 85
  AND
  last(/Servidor Linux/system.cpu.load[percpu,avg1]) > 5
)
Aqui, a trigger confirma:
- CPU alta em percentual.
- Load alto ao mesmo tempo.
Isso reduz muito os falsos positivos.
Exemplos práticos de uso de triggers no Zabbix
Exemplo 1 – CPU + memória
Cenário: CPU sobe rápido, mas logo normaliza.
Trigger simples (ruim):
last(/Servidor Linux/system.cpu.util[,system]) > 90Trigger melhor:
(
  avg(/Servidor Linux/system.cpu.util[,system],5m) > 85
  AND
  avg(/Servidor Linux/vm.memory.utilization,5m) > 80
)
Resultado:
- Menos alertas desnecessários.
- Mais confiança no alerta.
Exemplo 2 – Serviço indisponível com fallback
Trigger do serviço:
last(/Servidor Linux/service.httpd.status) <> 0Trigger de conectividade:
max(/Servidor Linux/icmpping,3m) = 0Você pode deixar a trigger do serviço dependente da trigger de ping, evitando um falso alerta quando o host estiver offline.
Exemplo 3 – Evitando alertas em cascata
Trigger raiz:
max(/Servidor Linux/icmpping,3m) = 0Todas as outras triggers do host dependem dessa trigger raiz.
Resultado:
- Um alerta claro.
- Diagnóstico rápido.
- Zero “spam” de notificação.
Boas práticas para o uso de triggers no Zabbix
Algumas práticas simples melhoram muito o monitoramento:
- Use descrições claras nas triggers.
- Evite
last()quando médias fizerem mais sentido. - Use dependências sempre que possível.
- Teste triggers novas antes de enviar para a produção.
- Revise triggers antigas regularmente.
Lembre-se: uma trigger não é estática, ela deve evoluir junto com o ambiente.
Utilize triggers para aprimorar o seu uso de Zabbix
Triggers bem configuradas transformam o Zabbix em uma ferramenta estratégica. Elas ajudam a:
- Reduzir o ruído;
- Evitar falsos positivos;
- Ganhar confiança nos alertas.
Ao aprender a combinar triggers, usar dependências e avaliar múltiplos itens, você sai do monitoramento reativo e entra em um nível muito mais maduro. Consulte sempre a documentação oficial do Zabbix para estar por dentro das boas práticas na ferramenta.
Precisa de ajuda para elevar o monitoramento da sua empresa ao próximo nível? Entre em contato com a Zabbix, estamos à disposição para auxiliar com as melhores práticas em monitoramento e observabilidade.
 Prev Post