Em ambientes com operação 24×7, alertar não é suficiente. O ponto crítico é alertar a pessoa certa, no canal certo e no momento certo. Quando isso não acontece, o time até recebe eventos, mas não necessariamente toma decisão com velocidade. É aqui que os webhooks no Zabbix deixam de ser um recurso “extra” e passam a ser parte da arquitetura operacional.
Eles permitem transformar sinais técnicos em comunicação útil para cada público, mantendo o mesmo evento com mensagens diferentes para quem executa, para quem coordena e para quem responde pelo negócio.
Veremos como estruturar notificações personalizadas para diferentes públicos (NOC, suporte, SRE, gestão e diretoria), com exemplos práticos de envio via e-mail, Microsoft Teams e Telegram. A proposta é sair do modelo genérico e construir um fluxo de notificação com clareza de responsabilidade, contexto e escalonamento.
Por que sair do modelo padrão de notificação
Quando todo alerta segue para todos, o resultado tende a ser previsível: excesso de mensagem, baixa atenção ao que realmente importa e perda de confiança no canal de alerta. O time começa a ignorar notificações repetitivas, e eventos relevantes passam a competir com alertas de baixo impacto.
No dia a dia, isso se traduz em:
- Ruído operacional;
- Baixa prioridade percebida;
- Resposta lenta em incidentes críticos;
- Desgaste entre operação e negócio.
A personalização resolve esse problema com regras explícitas de roteamento e contexto: severidade, serviço impactado, janela de notificação, time responsável e estágio de escalada. Em vez de “broadcast”, você cria comunicação direcionada e com intenção, reduzindo fadiga de alerta e melhorando a qualidade da resposta.
Como os webhooks funcionam no Zabbix
No Zabbix, um webhook é um Media Type que executa uma chamada HTTP para um endpoint externo (Teams, Telegram, sistema interno, ITSM etc.). Na prática, ele é a ponte entre o evento técnico e o canal onde a ação acontece.
O fluxo básico é:
- Uma trigger gera evento;
- A Action avalia condições (severidade, tags, horário, host group, serviço);
- A Action seleciona o Media Type (Webhook, Email, etc.);
- O payload é montado com macros do evento;
- O destino recebe a notificação e retorna status.
Esse desenho permite criar canais especializados sem acoplar toda a lógica dentro do trigger. O trigger continua responsável por detectar problema técnico; a Action passa a ser responsável por decidir “quem precisa saber, quando e com qual nível de detalhe”.
Passo a passo de implementação no Zabbix
Um fluxo prático de implantação costuma seguir esta ordem:
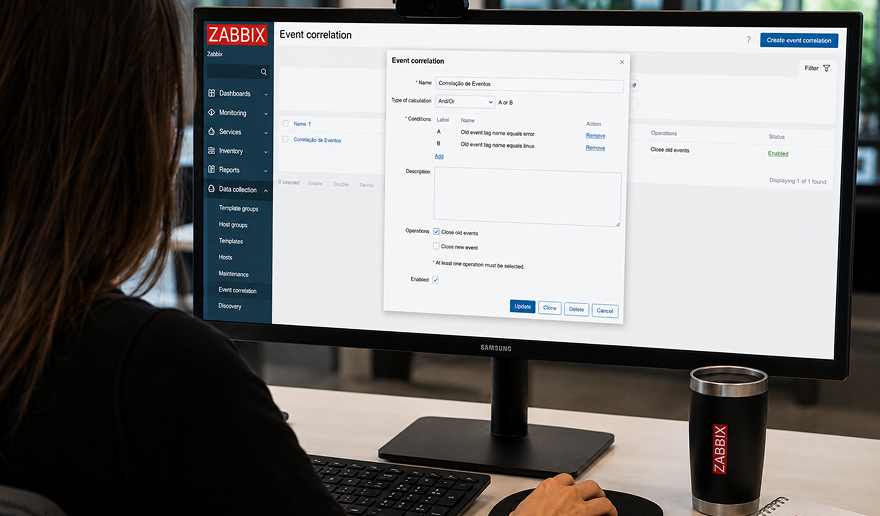
- Criar Media Types: Alerts > Media types para Email (SMTP), Teams (Webhook) e Telegram (Webhook/Bot API).
- Definir grupos de usuários: Users > User groups (NOC, SRE, Suporte, Gestão, Diretoria).
- Associar mídias aos usuários: em cada usuário/grupo, definir qual canal recebe qual severidade.
- Padronizar tags nos hosts/templates: garantir team, service, env, criticality, notify.
- Configurar Actions: Alerts > Actions > Trigger actions com condições por severidade + tags + janela.
- Definir escalonamento: operações em etapas (ex.: passo 1 Teams, passo 2 Telegram, passo 3 e-mail executivo).
- Testar ponta a ponta: simular trigger por severidade e validar entrega, formatação e tempo de resposta.
Ponto crítico: mantenha regras de roteamento nas Actions e não espalhadas em múltiplos triggers. Isso facilita governança, simplifica auditoria e reduz retrabalho quando a estrutura da empresa muda.
Também vale tratar a camada de notificação como produto interno: versionamento de configuração, revisão por pares e critérios mínimos de qualidade (tempo de entrega, clareza da mensagem e cobertura de fallback).
Modelo de roteamento recomendado por público
Antes de configurar scripts, defina sua matriz de comunicação. Esse passo parece simples, mas costuma ser o que mais reduz ruído ao longo do tempo. O mesmo incidente não precisa gerar a mesma mensagem para todos os níveis da organização.
Uma segmentação objetiva costuma funcionar assim:
- NOC/SRE: alerta técnico completo, imediato, com contexto de troubleshooting;
- Times de aplicação/suporte: alerta com impacto funcional e próximos passos;
- Gestores: resumo executivo do incidente, status e ETA;
- Diretoria: comunicação curta, apenas para eventos críticos confirmados.
Exemplo de regra prática:
- Warning e Average: Teams do time responsável;
- High: Teams + Telegram do plantão;
- Disaster: Teams + Telegram + e-mail para gestão; diretoria apenas após confirmação do incidente.
Esse modelo ajuda a manter equilíbrio entre agilidade técnica e qualidade de comunicação executiva. O time operacional recebe profundidade; a gestão recebe objetividade; a diretoria recebe contexto de decisão, sem ruído.
Estruturando tags para personalização
A melhor forma de manter escala é usar tags de evento para roteamento. Quando a estratégia depende apenas de host ou template, qualquer crescimento de ambiente vira custo operacional. Com tags, você desacopla notificação de infraestrutura e aproxima o alerta da lógica de negócio.
Uma base útil de tags inclui:
- team=infra|app|db
- service=checkout|billing|core-db
- env=prod|stg
- criticality=high|medium|low
- notify=ops|mgmt|board
Com isso, as Actions deixam de depender de regras rígidas por host e passam a usar contexto de serviço. O ganho é grande em cenários híbridos, multiambiente e com times distribuídos.
Como prática de governança, defina um “catálogo de tags” com nomes aceitos, valores válidos e responsáveis por manutenção. Esse catálogo evita variações de escrita (prod, production, prd) que quebram regras silenciosamente.
Personalização de mensagem com macros
As macros permitem enriquecer notificações sem duplicar configuração. O objetivo não é mandar mensagens longas, e sim mensagens suficientes para tomada de decisão no primeiro contato.
Um bom template precisa responder rapidamente: o que aconteceu, onde aconteceu, qual o impacto e qual o próximo passo. As macros abaixo cobrem boa parte desse cenário:
{HOST.NAME}{TRIGGER.NAME}{TRIGGER.SEVERITY}{EVENT.DATE} {EVENT.TIME}{ITEM.LASTVALUE}{TRIGGER.URL}{EVENT.TAGS.<tag>}
Template técnico (NOC/SRE):
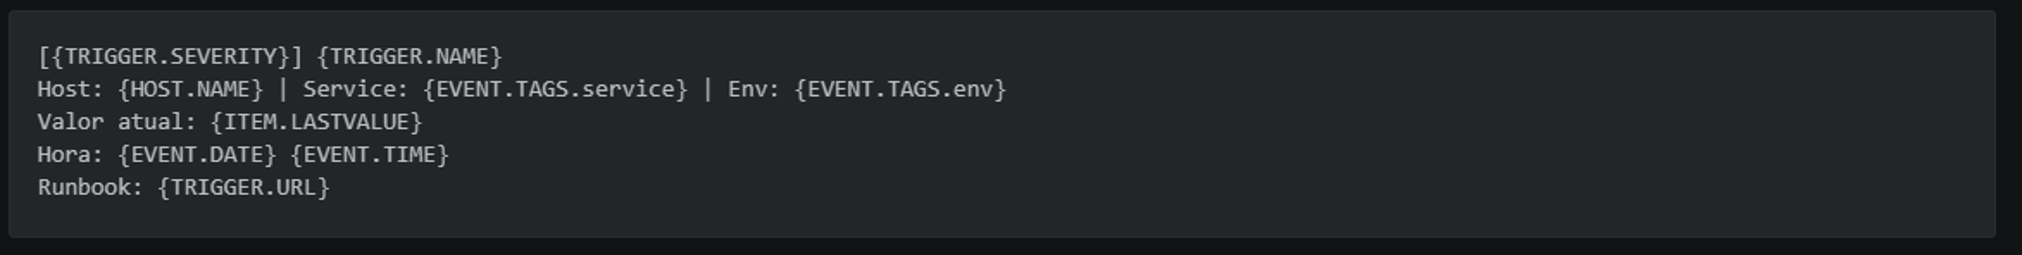
[{TRIGGER.SEVERITY}]
{TRIGGER.NAME}
Host: {HOST.NAME} | Service: {EVENT.TAGS.service} | Env: {EVENT.TAGS.env}
Valor atual: {ITEM.LASTVALUE}
Hora: {EVENT.DATE} {EVENT.TIME}
Runbook: {TRIGGER.URL}
Template executivo (gestão/diretoria):

Incidente {TRIGGER.SEVERITY} no serviço {EVENT.TAGS.service} ({EVENT.TAGS.env})
Impacto: indisponibilidade/degradação confirmada
Status: time atuando
Próxima atualização: em 15 min
2) Microsoft Teams (canal principal de operação)
1) E-mail (comunicação formal e trilha de auditoria)
Use o Media Type SMTP para comunicação que precisa de histórico, rastreabilidade e formato mais institucional. Em muitas empresas, o e-mail continua sendo o canal oficial para gestão de crise e registro de decisão.
Aplicações comuns:
- Notificações gerenciais;
- Sumários de incidente;
- Fechamentos pós-incidente.
Boas práticas:
- Assunto padronizado com severidade e serviço;
- Corpo em HTML simples com blocos “Impacto”, “Status”, “Próximos passos”;
- Envio em lotes para grupos (noc@, gestao@, diretoria@) conforme criticidade.
Exemplo simples de e-mail HTML para gerência/diretoria:

Assunto sugerido: [High] Incidente no serviço {EVENT.TAGS.service} ({EVENT.TAGS.env})
<html>
 <body style="margin:0;padding:0;background:#f4f6f8;font-family:Arial,sans-serif;color:#1f2937;">
   <table role="presentation" width="100%" cellpadding="0" cellspacing="0" style="padding:24px 0;">
     <tr>
       <td align="center">
         <table role="presentation" width="620" cellpadding="0" cellspacing="0" style="background:#ffffff;border:1px solid #e5e7eb;border-radius:8px;overflow:hidden;">
           <tr>
             <td style="background:#bb133e;color:#ffffff;padding:16px 20px;font-size:18px;font-weight:bold;">
               Incidente {TRIGGER.SEVERITY} - {EVENT.TAGS.service}
             </td>
           </tr>
           <tr>
             <td style="padding:20px;">
               <p style="margin:0 0 12px 0;font-size:14px;line-height:1.5;">
                  Foi identificado um incidente no ambiente <strong>{EVENT.TAGS.env}</strong>.
               </p>

               <table role="presentation" width="100%" cellpadding="8" cellspacing="0" style="border-collapse:collapse;font-size:13px;">
                 <tr>
                   <td style="border:1px solid #e5e7eb;background:#f9fafb;"><strong>Serviço</strong></td>
                   <td style="border:1px solid #e5e7eb;">{EVENT.TAGS.service}</td>
                 </tr>
                 <tr>
                   <td style="border:1px solid #e5e7eb;background:#f9fafb;"><strong>Host</strong></td>
                   <td style="border:1px solid #e5e7eb;">{HOST.NAME}</td>
                 </tr>
                 <tr>
                   <td style="border:1px solid #e5e7eb;background:#f9fafb;"><strong>Horário</strong></td>
                   <td style="border:1px solid #e5e7eb;">{EVENT.DATE} {EVENT.TIME}</td>
                 </tr>
                 <tr>
                   <td style="border:1px solid #e5e7eb;background:#f9fafb;"><strong>Status</strong></td>
                   <td style="border:1px solid #e5e7eb;">Time técnico atuando. Próxima atualização em 15 minutos.</td>
                 </tr>
               </table>

               <p style="margin:16px 0 0 0;font-size:13px;line-height:1.5;">
                <strong>Impacto:</strong> degradação/indisponibilidade do serviço monitorado.
               </p>
               <p style="margin:8px 0 0 0;font-size:13px;line-height:1.5;">
                <strong>Runbook:</strong> <a href="{TRIGGER.URL}" style="color:#0b57d0;">{TRIGGER.URL}</a>
               </p>
             </td>
           </tr>
           <tr>
             <td style="background:#f9fafb;padding:12px 20px;font-size:12px;color:#6b7280;">
               Mensagem automática enviada pelo Zabbix para acompanhamento executivo.
             </td>
           </tr>
         </table>
       </td>
     </tr>
   </table>
 </body>
</html>
2) Microsoft Teams (canal principal de operação)
Use webhook de canal para resposta rápida de squads e plantão. O Teams funciona muito bem como canal de coordenação porque concentra conversa, atualização e compartilhamento de links operacionais no mesmo lugar.
Estratégia recomendada:
- 1 canal por time operacional;
- 1 canal de incidentes críticos;
- cards com campos curtos: severidade, serviço, ambiente, link de runbook;
- threads para atualização de incidentes em andamento.
Payload típico (resumido):
{
 "text": "[High] API Checkout com latência elevada em prod. Host: app-api-03. Runbook: https://..."
}
3) Telegram (plantão e contingência móvel)
Ideal para on-call quando o time está fora do desktop. O Telegram é particularmente útil em incidentes fora do horário comercial, quando a velocidade de acionamento pesa mais que a riqueza de formatação.
Boas práticas:
- bots por domínio (infra/app/db) ou por ambiente crítico;
- mensagens objetivas para evitar fadiga;
- usar como canal de urgência, não como log completo do incidente.
Payload típico para Bot API:
{
 "chat_id": "-1001234567890",
 "text": "[Disaster] Banco principal indisponível em prod. Time DB acionado."
}
Exemplo de desenho de Action no Zabbix
Estruture Actions por estágio:
- Detecção inicial: Teams do time dono do serviço (condição por team + severidade).
- Escalada de tempo: se não houver ACK em X minutos, incluir Telegram do on-call.
- Escalada executiva: apenas para High/Disaster confirmados, enviar e-mail para gestão.
- Comunicação diretoria: habilitar somente com tag notify=board ou status de incidente maior.
Esse modelo reduz ruído, melhora previsibilidade e deixa claro quando cada público entra no fluxo. Além disso, facilita auditoria: você consegue explicar por que uma notificação foi enviada, para quem e em qual etapa.
Uma recomendação prática é registrar as regras de escalada em documento único (runbook de comunicação), incluindo responsáveis por atualização. Assim, mudança de equipe ou de estrutura não quebra a política de alerta.
Caso prático de operação
Cenário: evento High em service=checkout no ambiente prod.
- Zabbix envia Teams para #squad-checkout;
- Após 10 min sem ACK, envia Telegram para plantonista;
- Se o impacto é confirmado, dispara e-mail para gestão com resumo executivo;
- Diretoria recebe apenas em caso de indisponibilidade material do serviço.
Resultado esperado:
- Menor MTTA (tempo para reconhecimento);
- Menor ruído para públicos não técnicos;
- Melhor qualidade da comunicação em incidentes críticos.
Quando o fluxo é bem implementado, o principal ganho não é apenas “avisar mais rápido”, e sim coordenar melhor. Cada audiência recebe informação no nível certo, no tempo certo, e isso reduz retrabalho durante o incidente.
Boas práticas para manter o modelo saudável
- Versionar scripts de webhook em repositório;
- Padronizar nomenclatura de tags e templates;
- Monitorar falhas de entrega dos próprios webhooks;
- Definir fallback (ex.: falhou Teams, aciona e-mail);
- Revisar regras a cada mudança de estrutura organizacional;
- Executar testes periódicos de notificação por severidade e canal.
Além da lista acima, estabeleça uma rotina de revisão mensal com operação e gestão para validar se a política de notificação ainda representa a realidade do ambiente. Serviços mudam, responsabilidades mudam, e as Actions precisam acompanhar esse movimento.
Conclusão sobre o uso de webhooks no Zabbix
Os webhooks no Zabbix fazem parte da camada que transforma um evento técnico em mensagem acionável para cada audiência da organização. Não basta detectar o problema rápido, é preciso comunicar com clareza para que a resposta aconteça no tempo esperado.
Quando as mensagens são bem estruturadas com tags, macros e regras de escalonamento, o time técnico recebe profundidade para agir, enquanto gestão e diretoria recebem contexto objetivo para tomada de decisão. O resultado é uma comunicação mais útil, com menos ambiguidade e menor retrabalho durante o incidente.
A redução de ruído também é um ganho central. Em vez de notificar todos sobre tudo, o modelo direciona cada severidade para o público correto, no canal correto e na etapa correta. Isso reduz fadiga de alerta, aumenta a atenção aos eventos críticos e melhora indicadores como tempo de reconhecimento e tempo de resposta.
Do ponto de vista de governança, o Zabbix ainda oferece rastreabilidade das notificações enviadas: histórico de eventos, ações executadas, destinatários, conteúdo da mensagem e status de envio. Essa trilha de auditoria fortalece análise pós-incidente, facilita prestação de contas para gestão e apoia requisitos de compliance sem depender de controles paralelos.
Em resumo, a personalização de notificações com webhooks coloca o Zabbix em um patamar mais estratégico: além de monitorar, ele passa a sustentar um processo de comunicação operacional maduro, mensurável e alinhado ao negócio.
Quer transformar o fluxo de notificações do seu ambiente?
Se a sua operação sofre com excesso de alertas, ruído nas comunicações ou demora na resposta a incidentes críticos, nossos especialistas podem ajudar a desenhar uma arquitetura de monitoramento personalizada e eficiente para a sua empresa.
Fale com os nossos especialistas e descubra como otimizar a comunicação entre NOC, equipes técnicas e gestão.
 Prev Post