在这篇博客文章中,我将向您展示如何检测 Zabbix 实例中的性能问题,而且是提前检测!
您可能正在使用 Zabbix 监控您的基础设施、设备和应用程序,但您是否也在监控自己的实例?这似乎没有必要,毕竟,有什么好监控的呢,对吧?您的实例运行正常,所以一切都很好。还需要什么呢?
但请记住,如果 Zabbix 数据库系统的磁盘空间耗尽,数据采集就会停止。如果数据采集器不足,采集到的数据就会不一致,这也会影响问题检测。
如果 Zabbix server 上的缓存空间耗尽,根据受影响的缓存不同,Zabbix server 可能会立即崩溃,或者出现性能下降。可能出问题的地方有很多,您需要防患于未然!下面介绍具体做法。
调优数据库
如果您的数据库使用的是默认设置,那么您就错过了大量本可获得、却一直未被利用的性能提升!实例的实际性能与数据库性能息息相关。如果数据库性能低下,您的 Zabbix 监控体验也会随之变差。
至少要做一些最基本的微调,并且只修改您理解的设置:阅读文档,查看 Zabbix 官方博客文章和 Zabbix 社区论坛,并进行测试。当然,您可以借助手头的一切工具(例如 AI)来实现这一点,但务必先在测试环境中测试这些设置。
数据库调优是一项复杂的任务。可为 MySQL 数据库调优的初始参数如下:
innodb_flush_log_at_trx_commit = 0
innodb_flush_method = O_DIRECT
optimizer_switch=index_condition_pushdown=off
innodb_buffer_pool_size= ~75% of RAM if only DB engine running or less if shared with other applications
对于 PostgreSQL 数据库,可以使用在线调优工具 PGTUNE 进行初始配置:
https://pgtune.leopard.in.ua/
监控 Zabbix 数据库
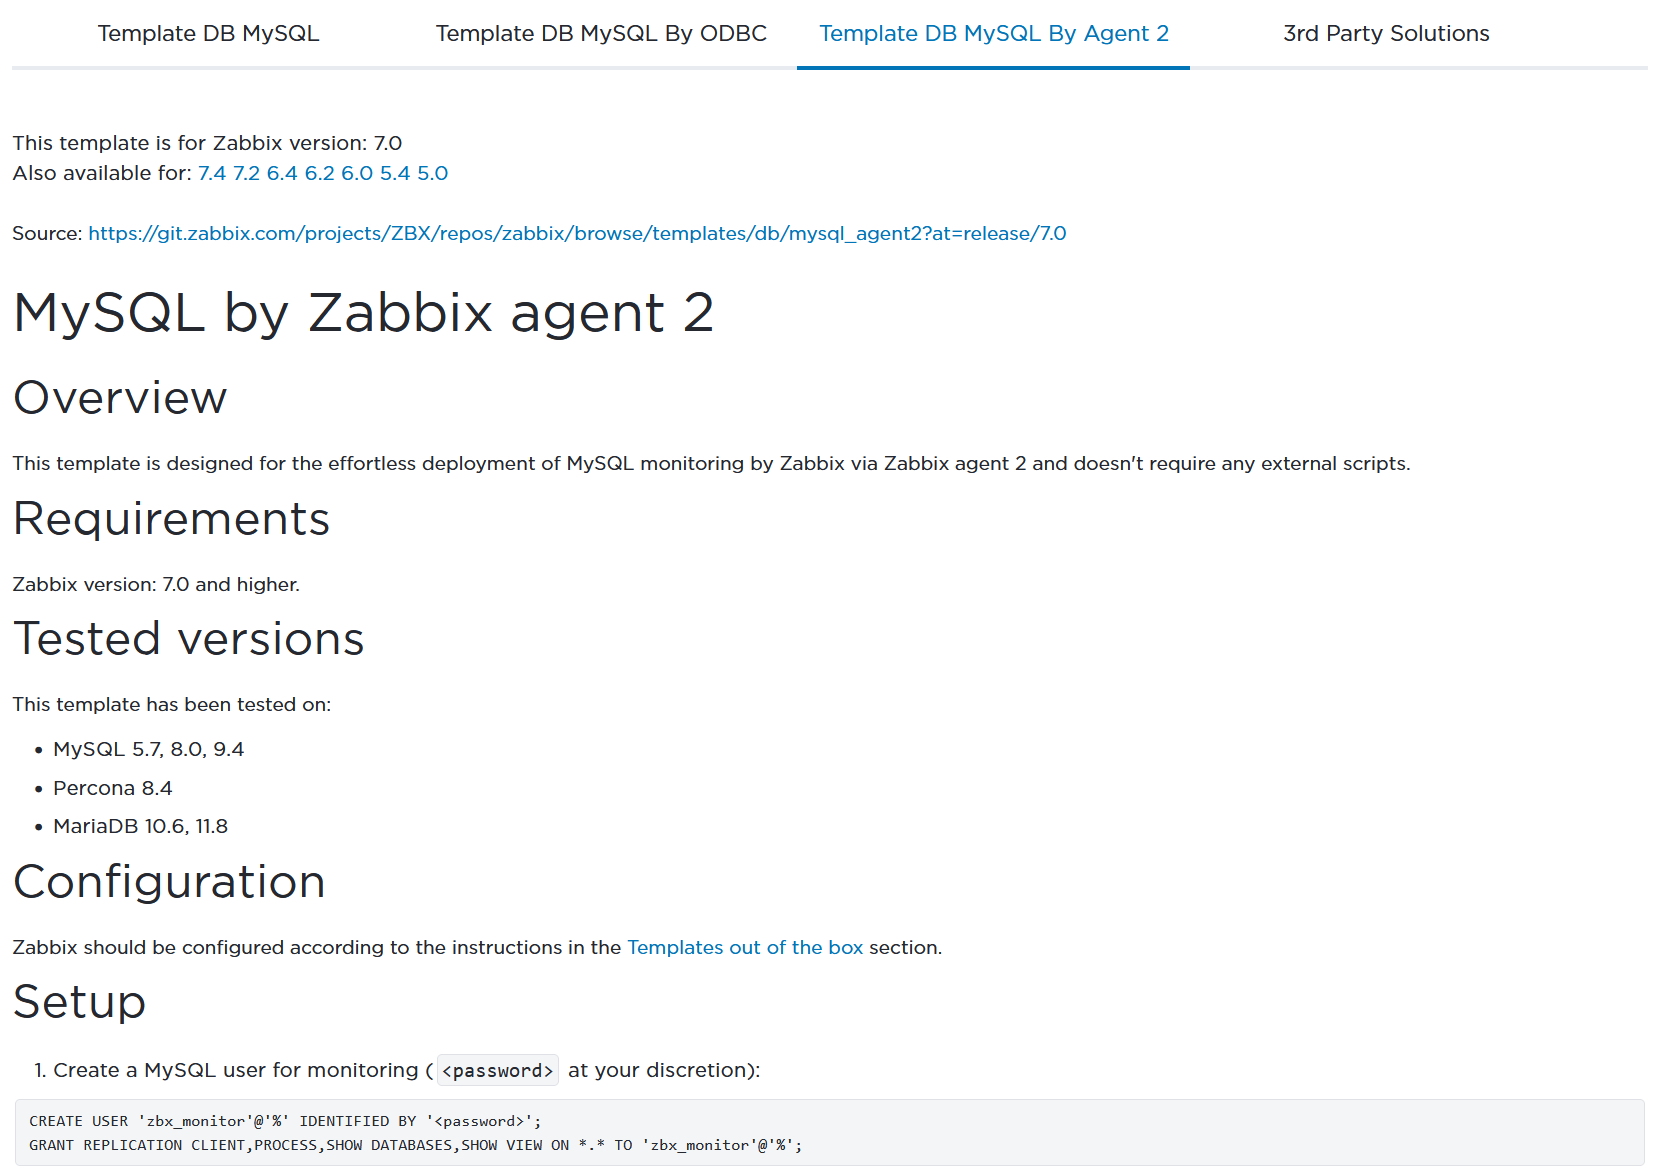
监控数据库非常重要。Zabbix 提供了多种开箱即用的方案,可以通过不同的方法监控最常用的数据库:使用 Zabbix agent 或 Zabbix agent2、使用 ODBC 检查、使用 Zabbix Java 网关,或使用 HTTP 检查。一旦检测到问题,您就会收到相应的问题事件。别忘了在 Zabbix server 升级后,手动将旧的 Zabbix 模板更新到当前版本。
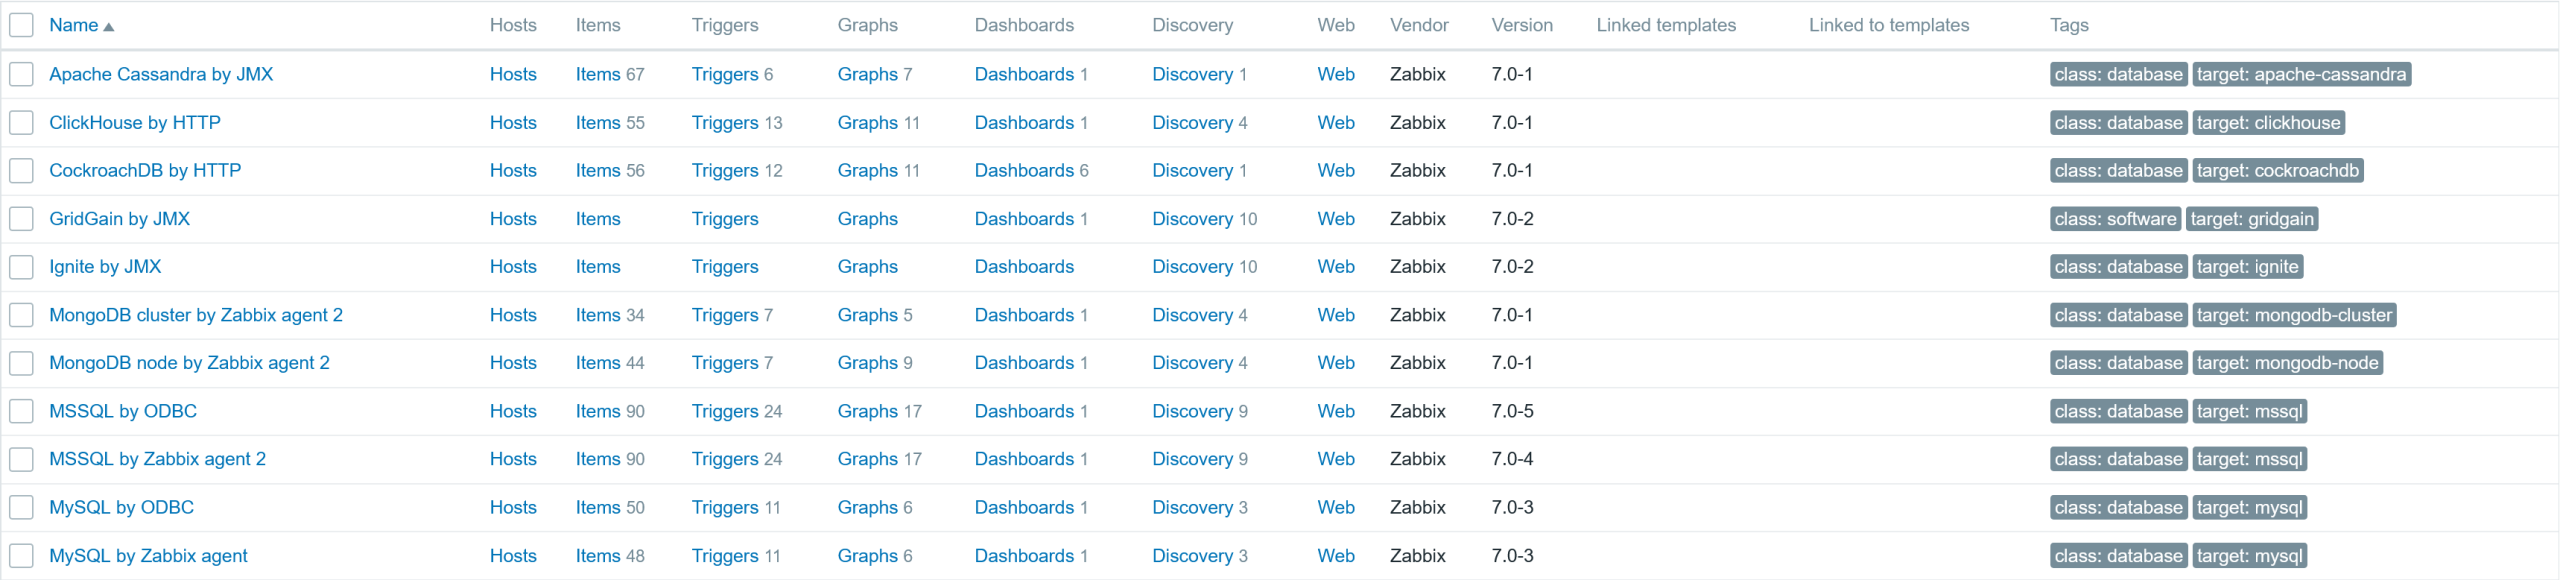
当然,根据您选择的数据库监控方式,还需要执行一些额外的步骤才能使其正常工作。有关如何配置的更多信息,请参阅 Zabbix 集成页面。
监控 Zabbix server
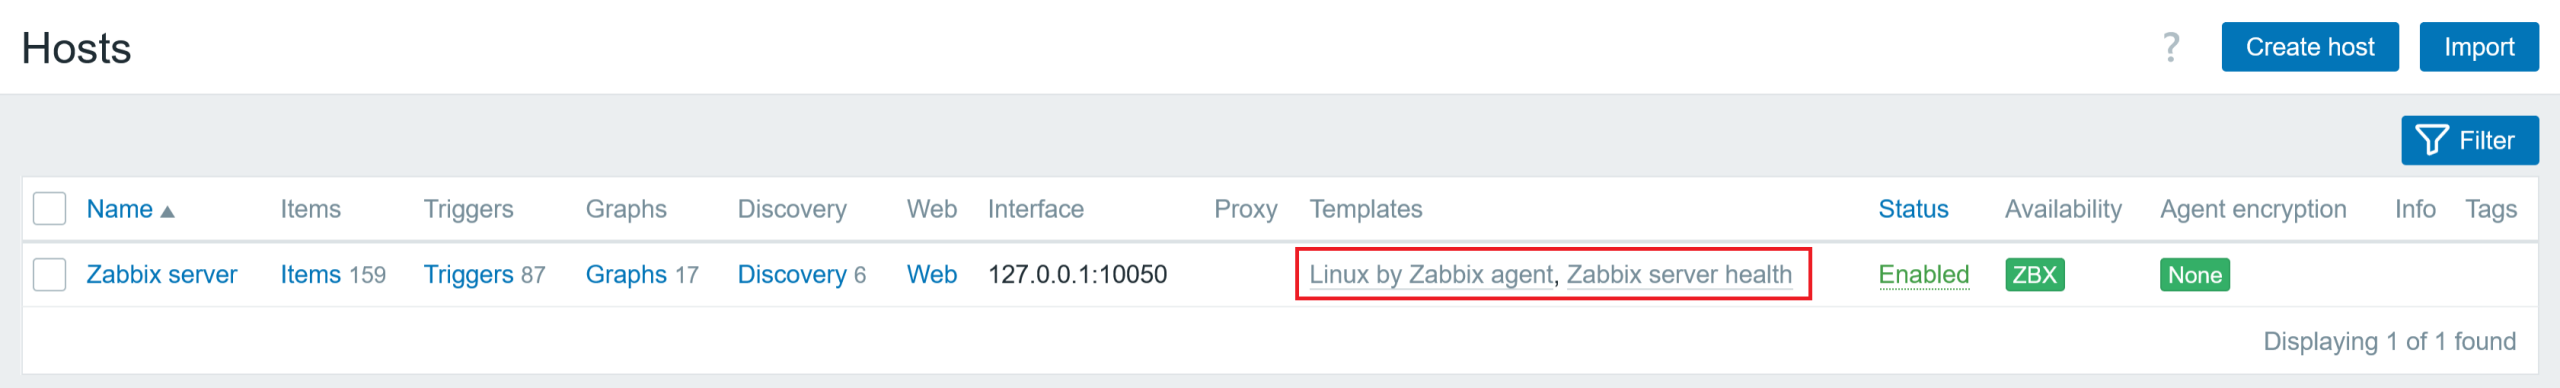
接下来应检查的是 Zabbix server 主机的主机仪表板。在新实例中,Zabbix server 主机已经开箱即用,并带有两个模板:Zabbix server health 和 Linux by Zabbix agent。如果由于某种原因没有保留该主机,现在就该创建它,并开始监控您的 Zabbix server 了。
Zabbix server health 模板使用 Zabbix 内部监控项,不需要任何接口。Linux by Zabbix agent 模板则需要在 Zabbix server 所在的系统上运行 Zabbix agent,才能采集操作系统相关的指标。
检查 Zabbix server 的当前状态
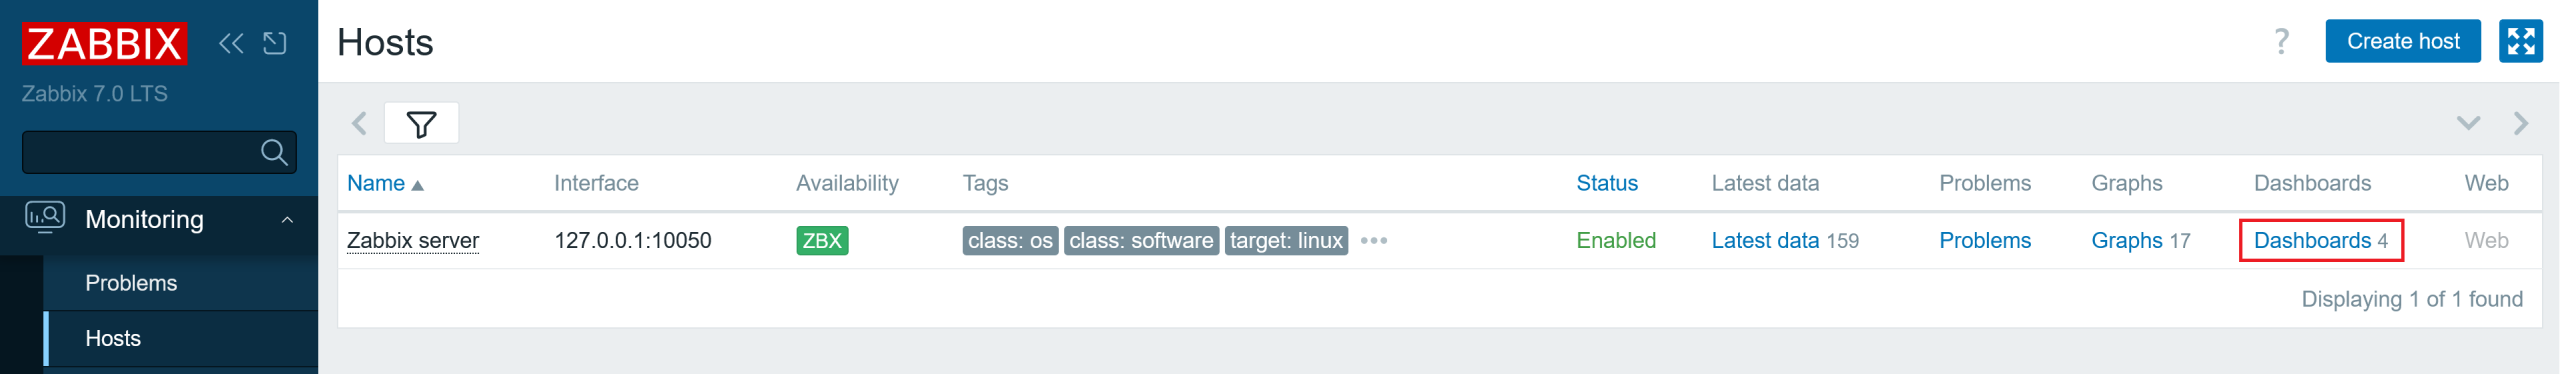
有了这样的主机后,进入菜单 Monitoring > Hosts,使用主过滤器找到 Zabbix server 主机,然后选择其主机仪表板。
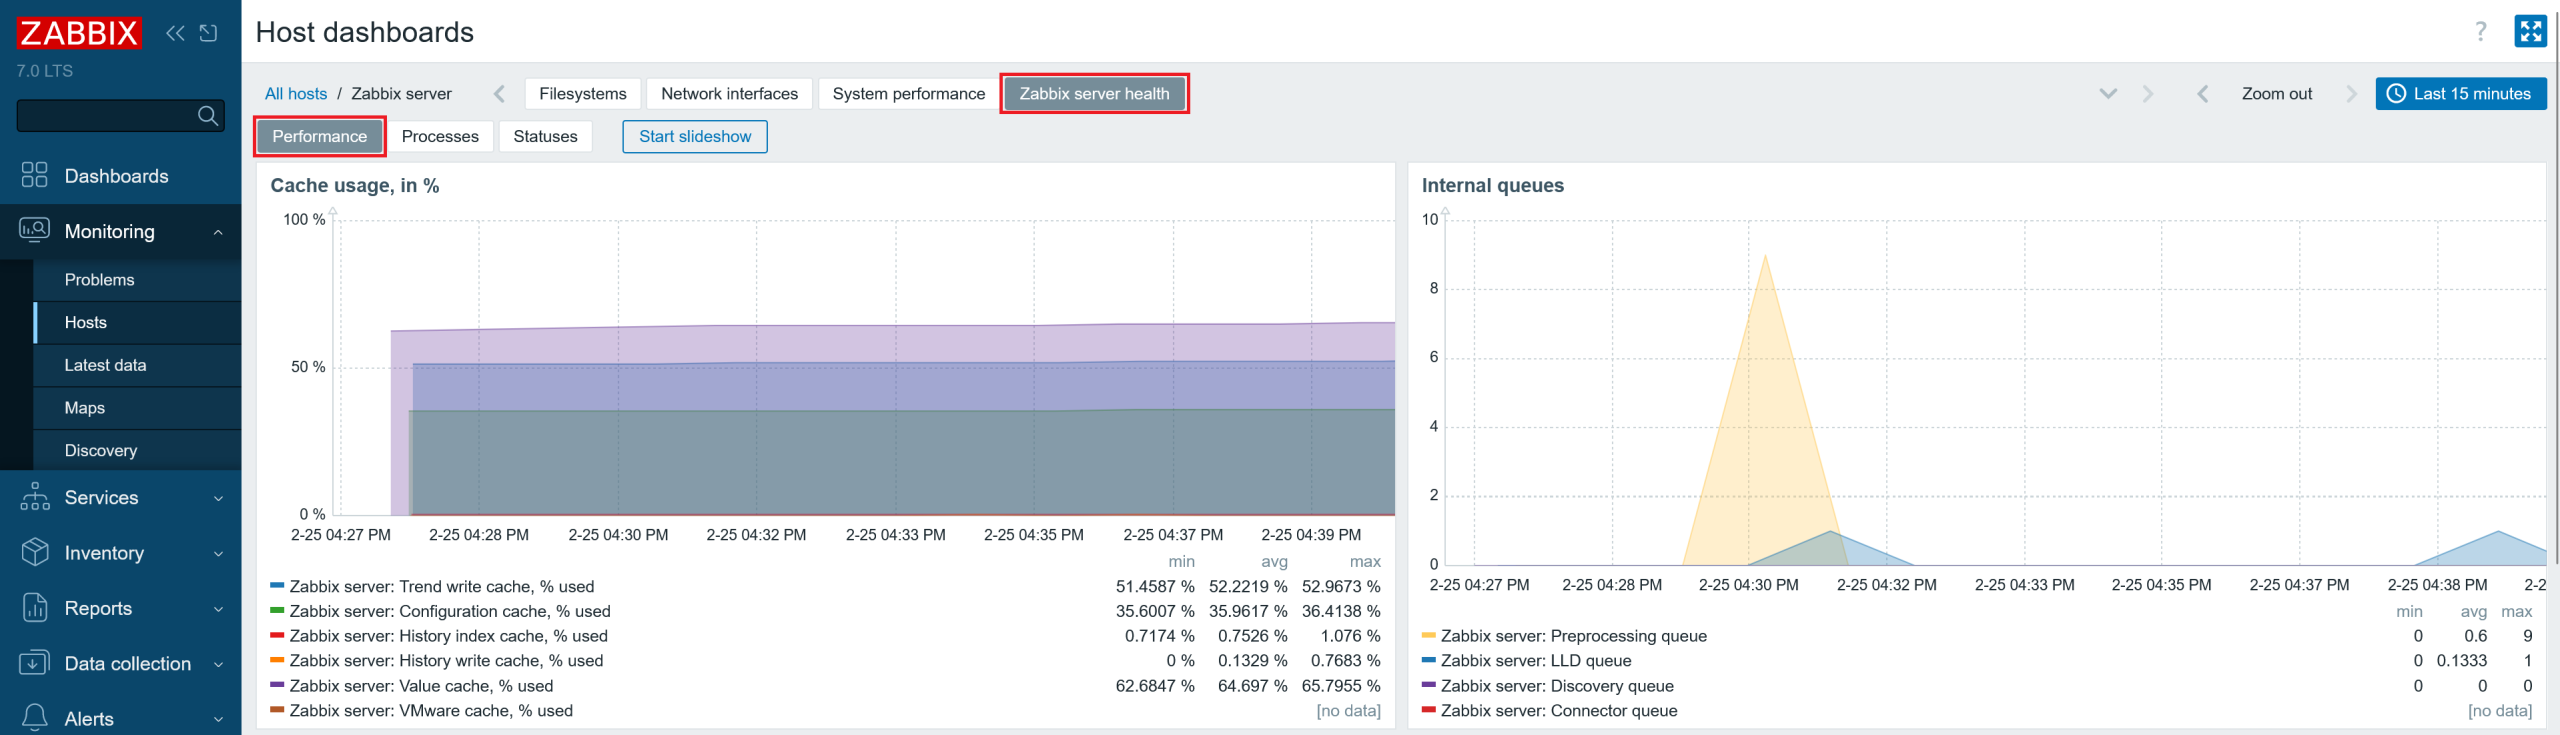
选择 Zabbix server health 仪表板。在它下方,您会看到以下页面:Performance、Processes 和 Statuses。
检查缓存利用率
在 Performance 页面中,您可以查看 Zabbix server 各个缓存的使用情况。应确保除历史缓存外,所有缓存都至少有 ~ 50 % 的空闲空间。从技术上讲,您可以把缓存设置得尽可能大;最坏的情况也只是利用率不足而已。因此,请相应地调整缓存大小。
配置缓存耗尽的后果
如果您以自动化方式添加了大量主机,而配置缓存大小 [configcache] 相对较小或仍为默认值,那么此缓存可能很快就会被填满。其后果是:
- Zabbix server 将崩溃
- Zabbix server 将无法启动
- Zabbix server 将不会采集任何数据
您还会在 Zabbix 前端看到一条警告消息:
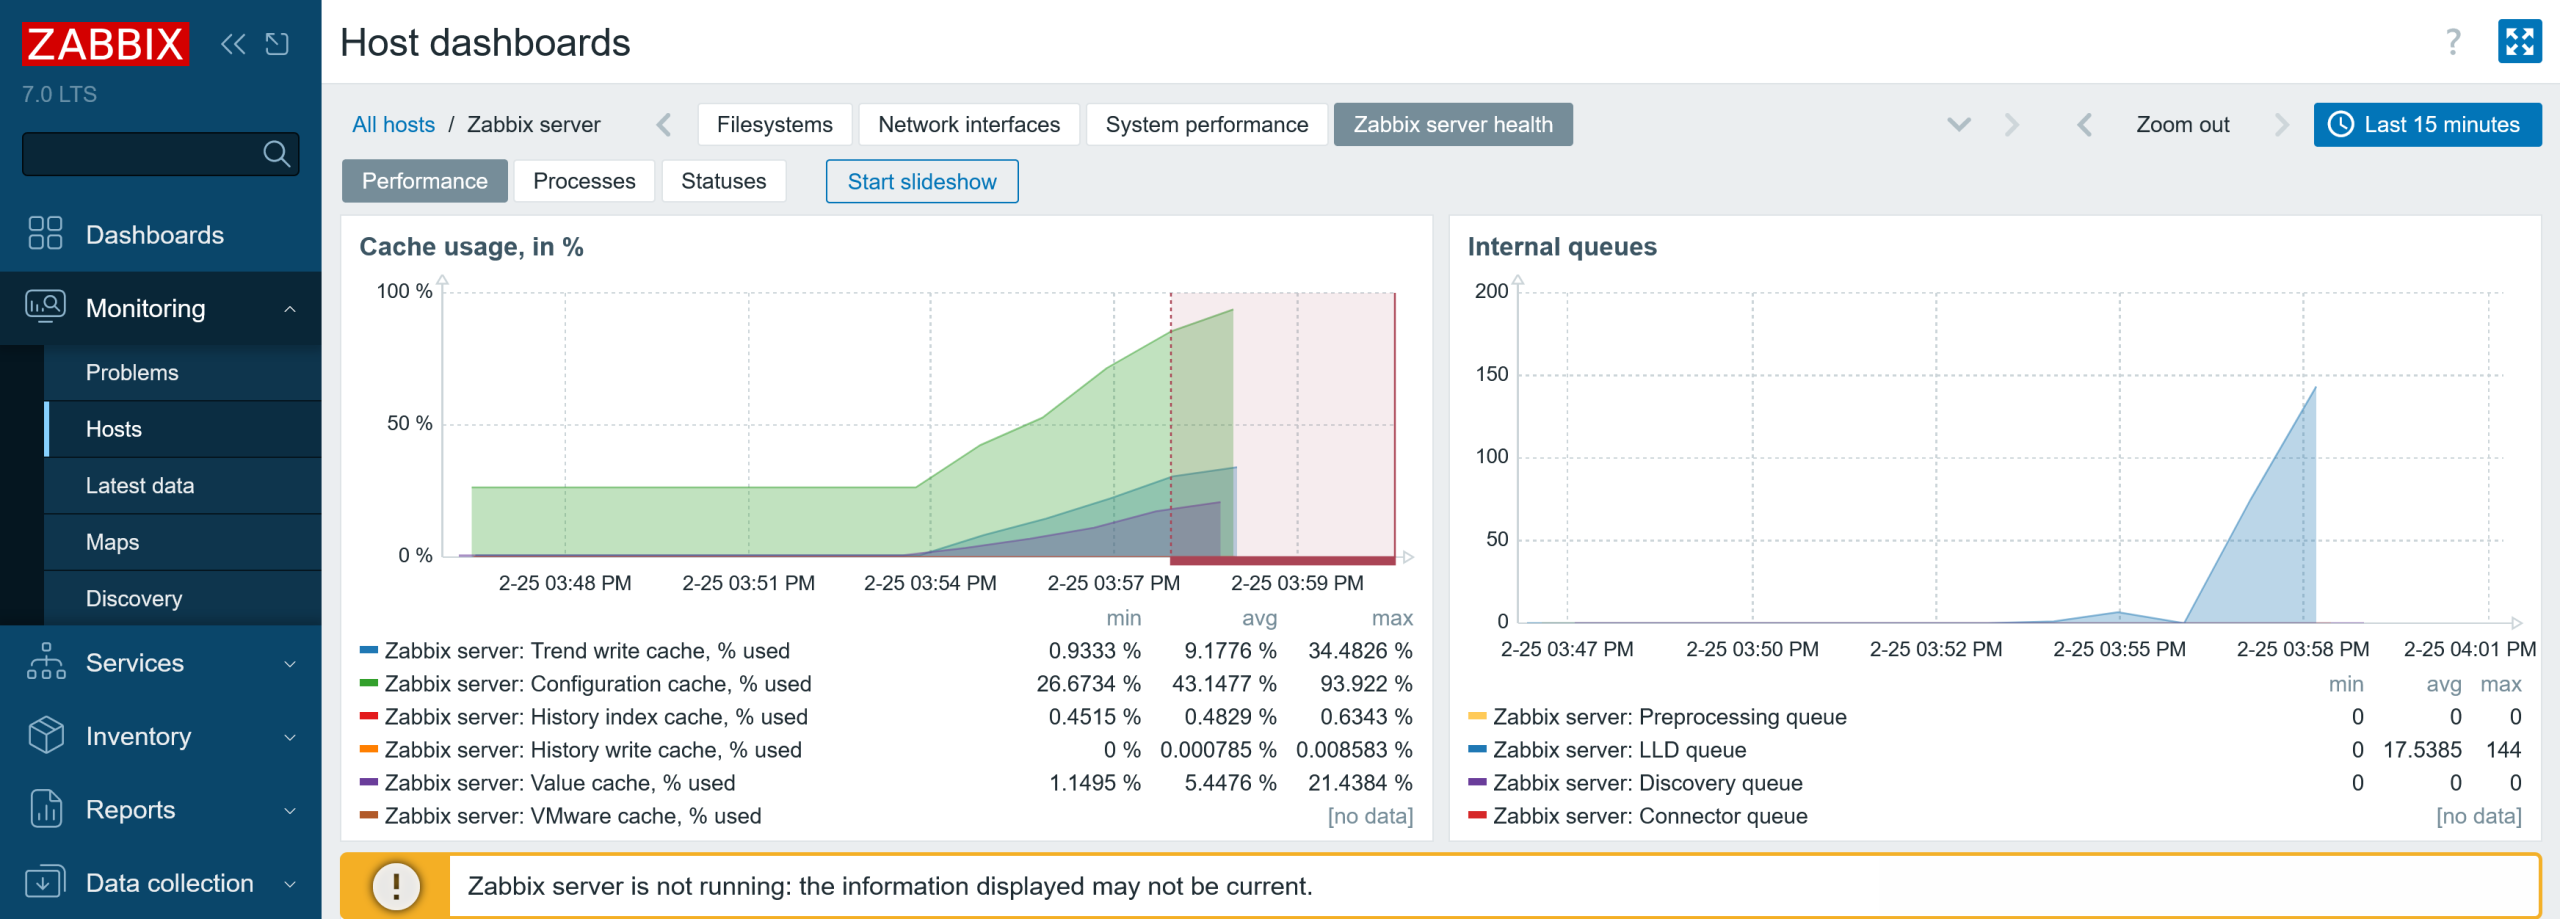
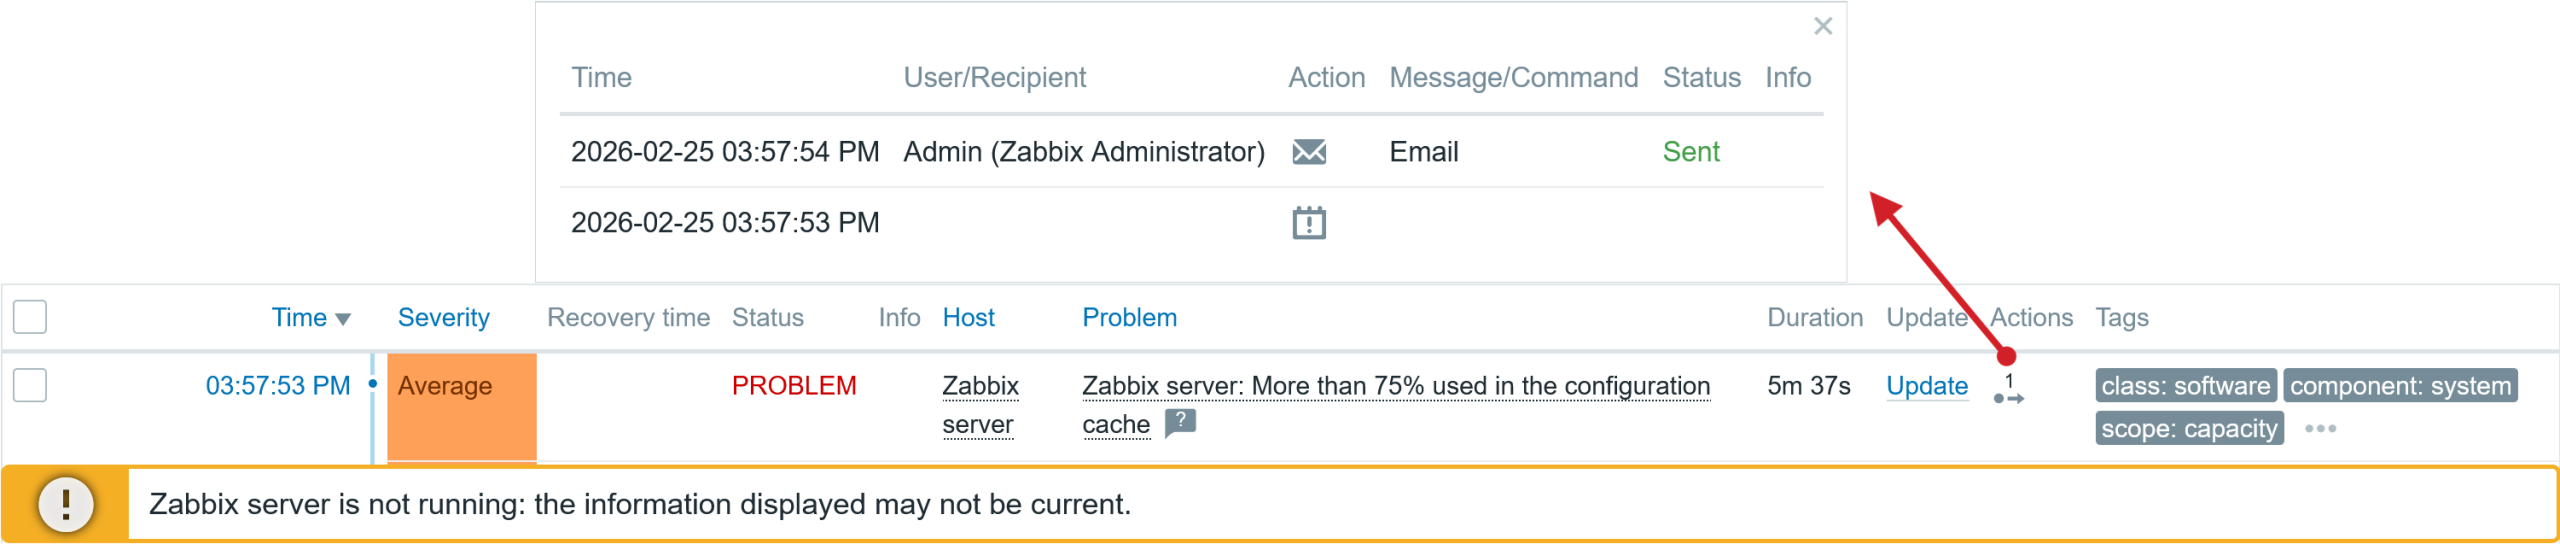
如果配置缓存不是瞬间被填满,那么很快就会生成问题事件,并且会在 Zabbix server 仍在运行时执行匹配的动作操作,例如通知管理员该问题。在下面的截图中可以看到,在服务器崩溃之前执行了一个动作操作步骤。
当某个 Zabbix 组件未按预期工作时,最好的信息来源是日志文件,因为它会告诉您出现了哪些问题。下面是 Zabbix Server 日志文件中的错误消息。
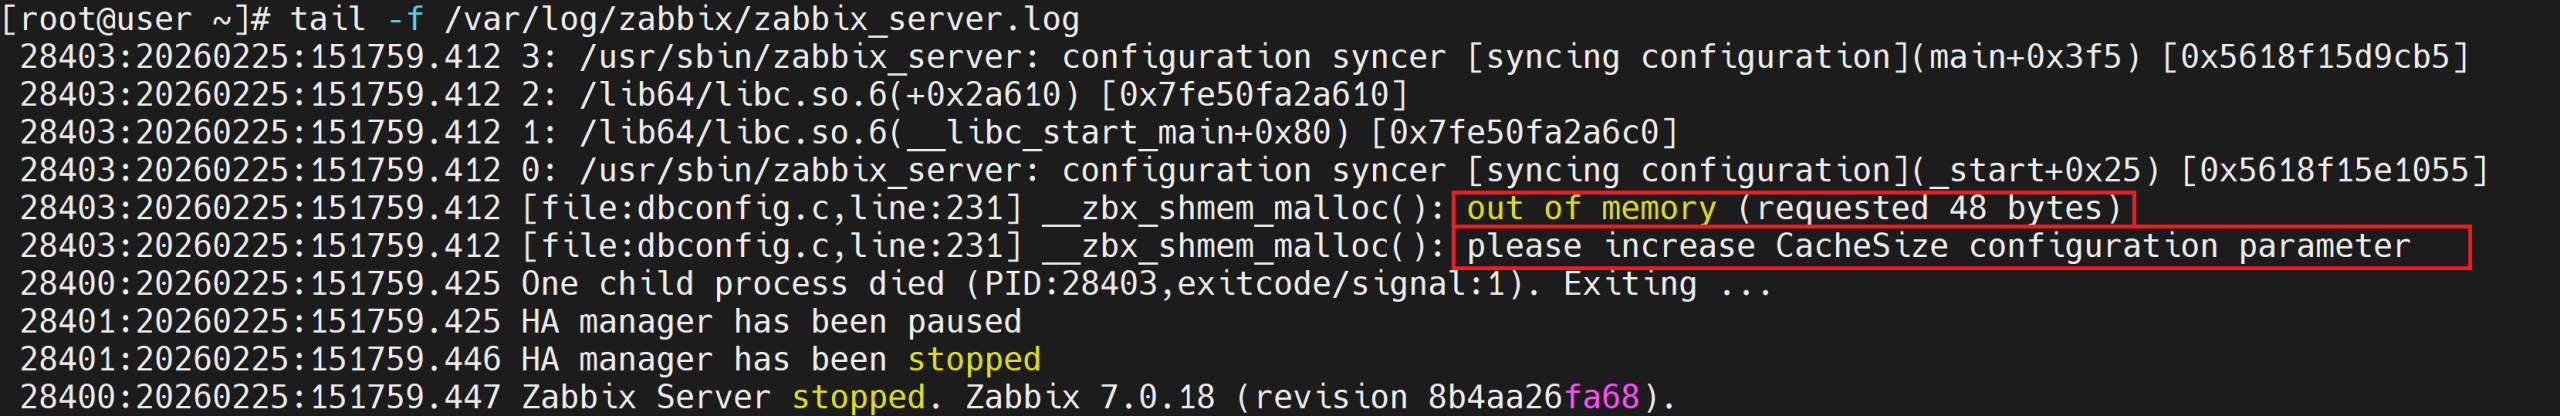
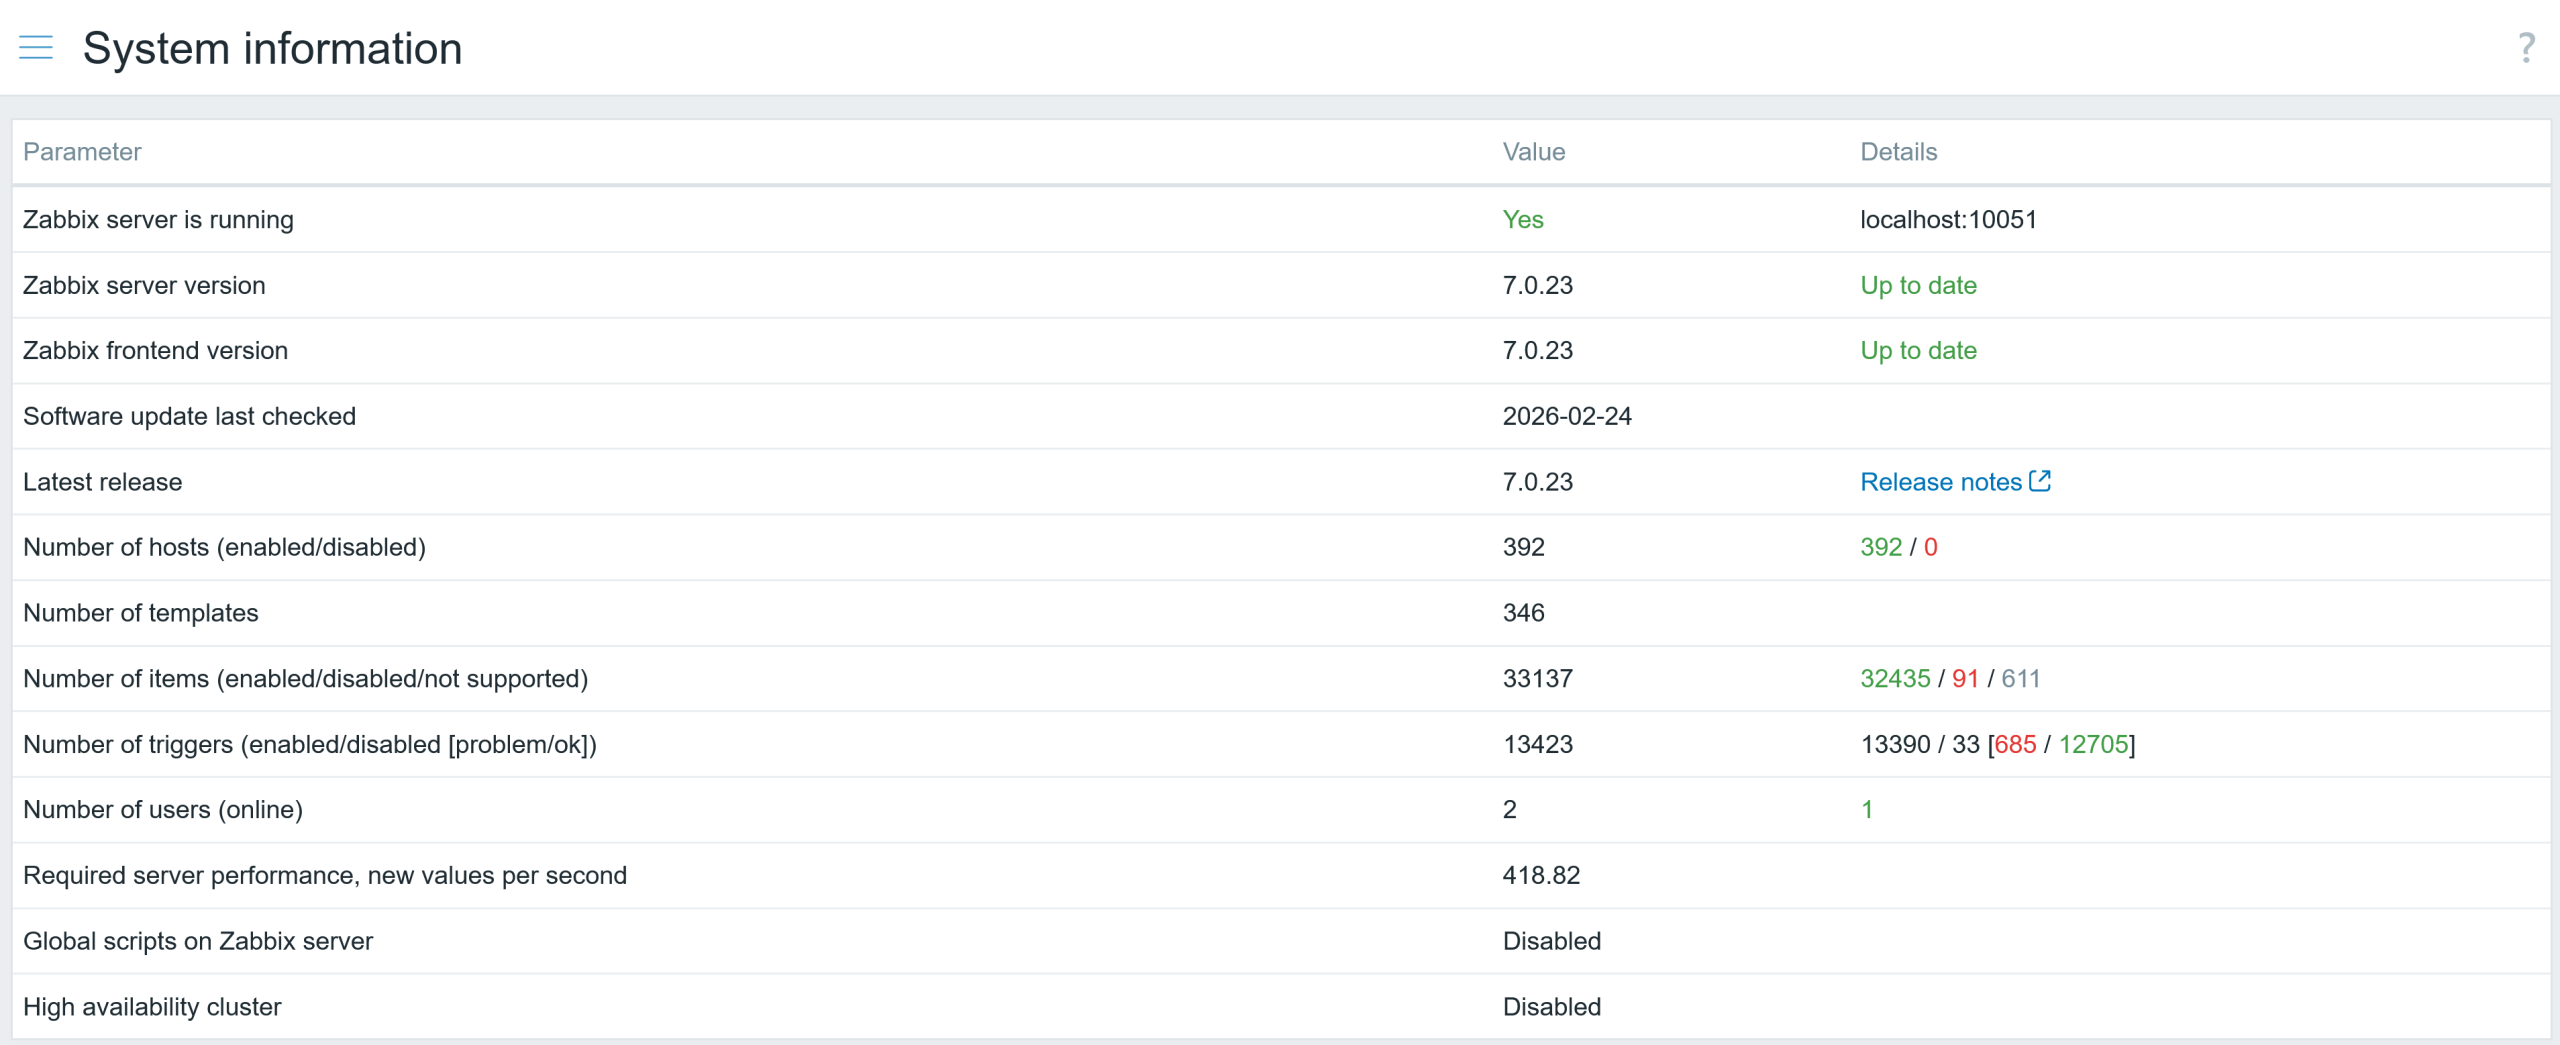
解决方法非常简单:只需将配置缓存大小增大(两倍或更多),然后重启 Zabbix server。如果您预计近期主机数量会大幅增加,可以更宽裕一些,分配更多内存。我目前的 Zabbix server 监控着大约 400 台主机。
值缓存和历史缓存耗尽的后果
那么,如果值缓存耗尽,会发生什么?Zabbix server 的性能会下降,前端的响应速度也会明显变慢。这是为什么呢?值缓存存储的是用于计算监控项和触发器评估的监控项值。此时,每次进行触发器计算时,凡是历史缓存中没有的监控项指标,都将直接从数据库中获取。
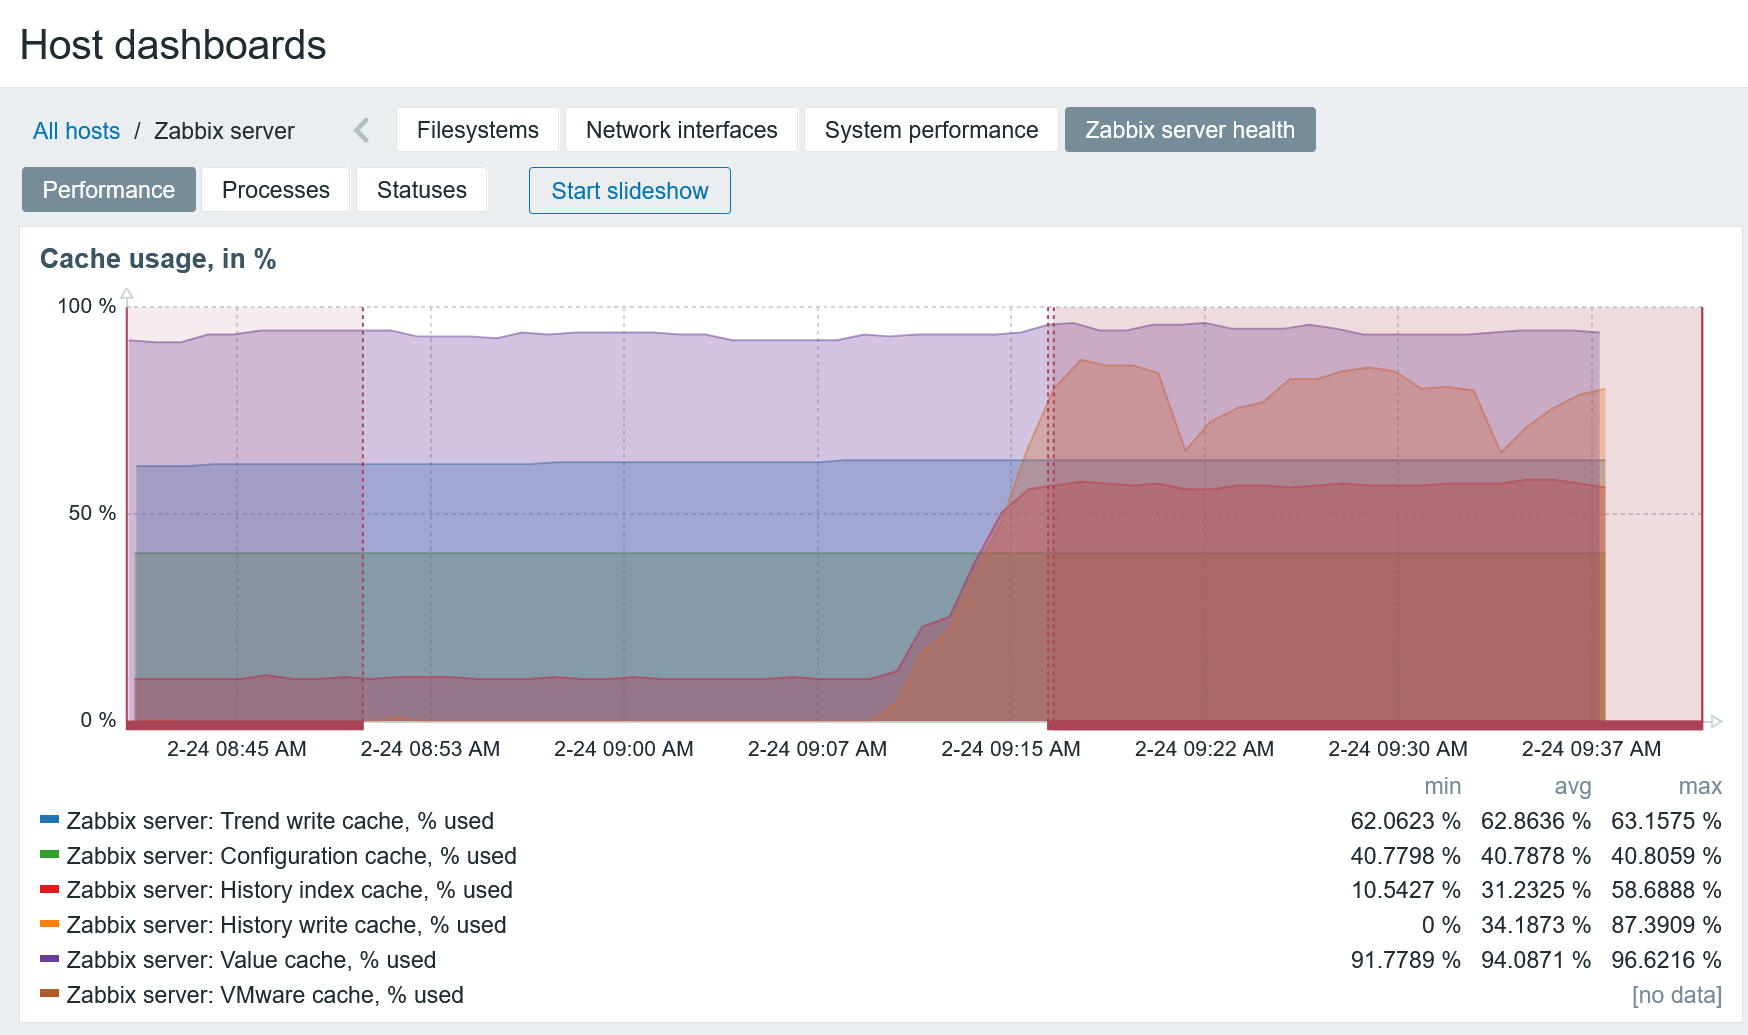
历史缓存存储的是将要写入数据库的历史数据。如果它几乎已满,就说明您的数据库性能可能存在问题:Zabbix server 无法足够快地将数据写入数据库。这可能引发连锁的性能下降,并形成恶性循环。在我的案例中:
- 值缓存已满,导致额外的数据库读取查询
- 数据库性能下降,导致历史数据写入数据库的速度变慢
- 历史缓存也开始被填满
- 由于历史缓存已满,数据采集出现延迟
- 随着采集的数据越来越多,数据库读取查询获取的数据也越来越多,使这一循环不断恶化
从技术上讲,值缓存并不需要 100% 填满才会出现这个问题:如果很多触发器使用较长的时间区间进行评估,就可能出现这样的情况:值缓存只有 85% 或 90% 满,但 Zabbix server 已无法将所需的监控项历史记录放入可用内存中。
值缓存耗尽的问题也会记录在 Zabbix server 的日志文件中。
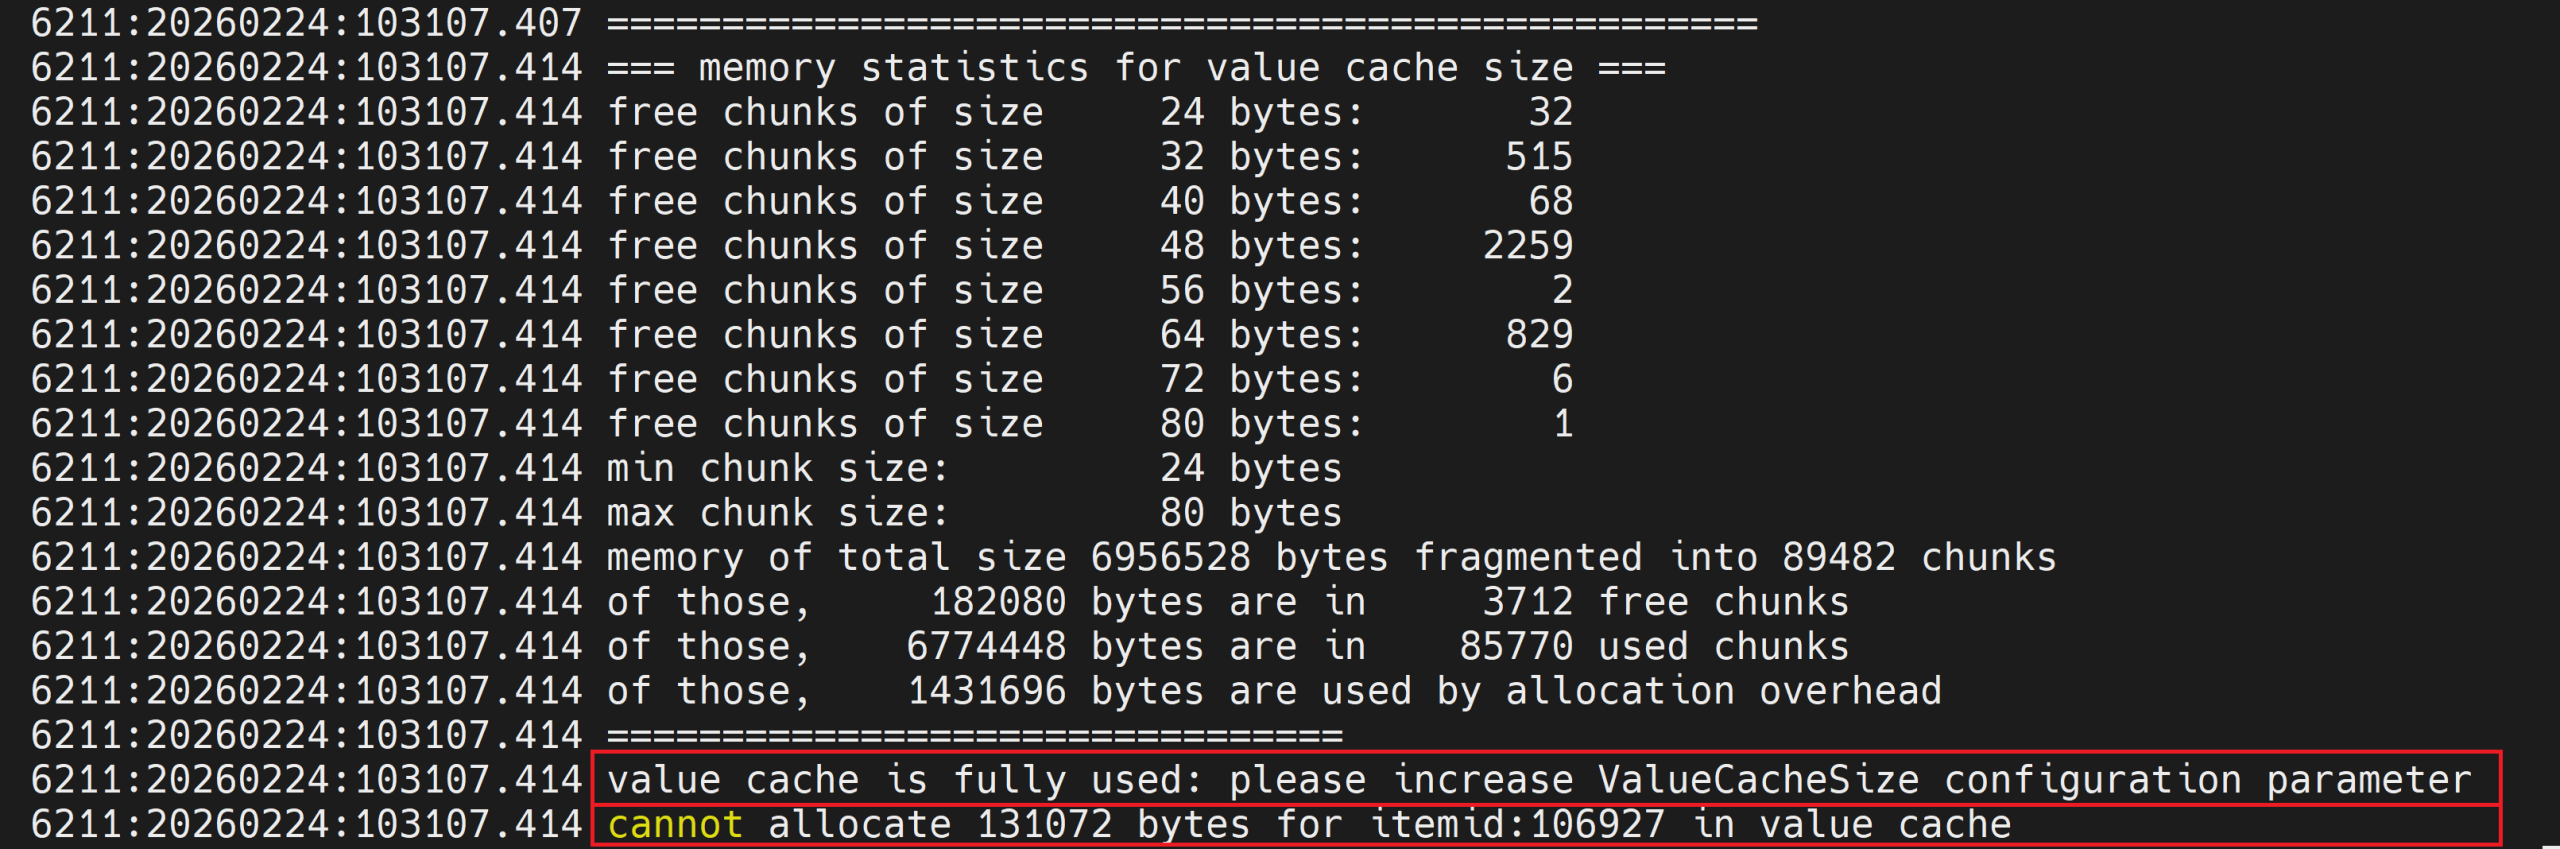
这个问题的解决方法很简单:增大值缓存大小,然后重启 Zabbix server。
如果您使用 health 模板监控 Zabbix server,则在以下情况下会自动生成问题事件:
- 值缓存在低内存模式下运行
- 历史缓存利用率超过 75 %

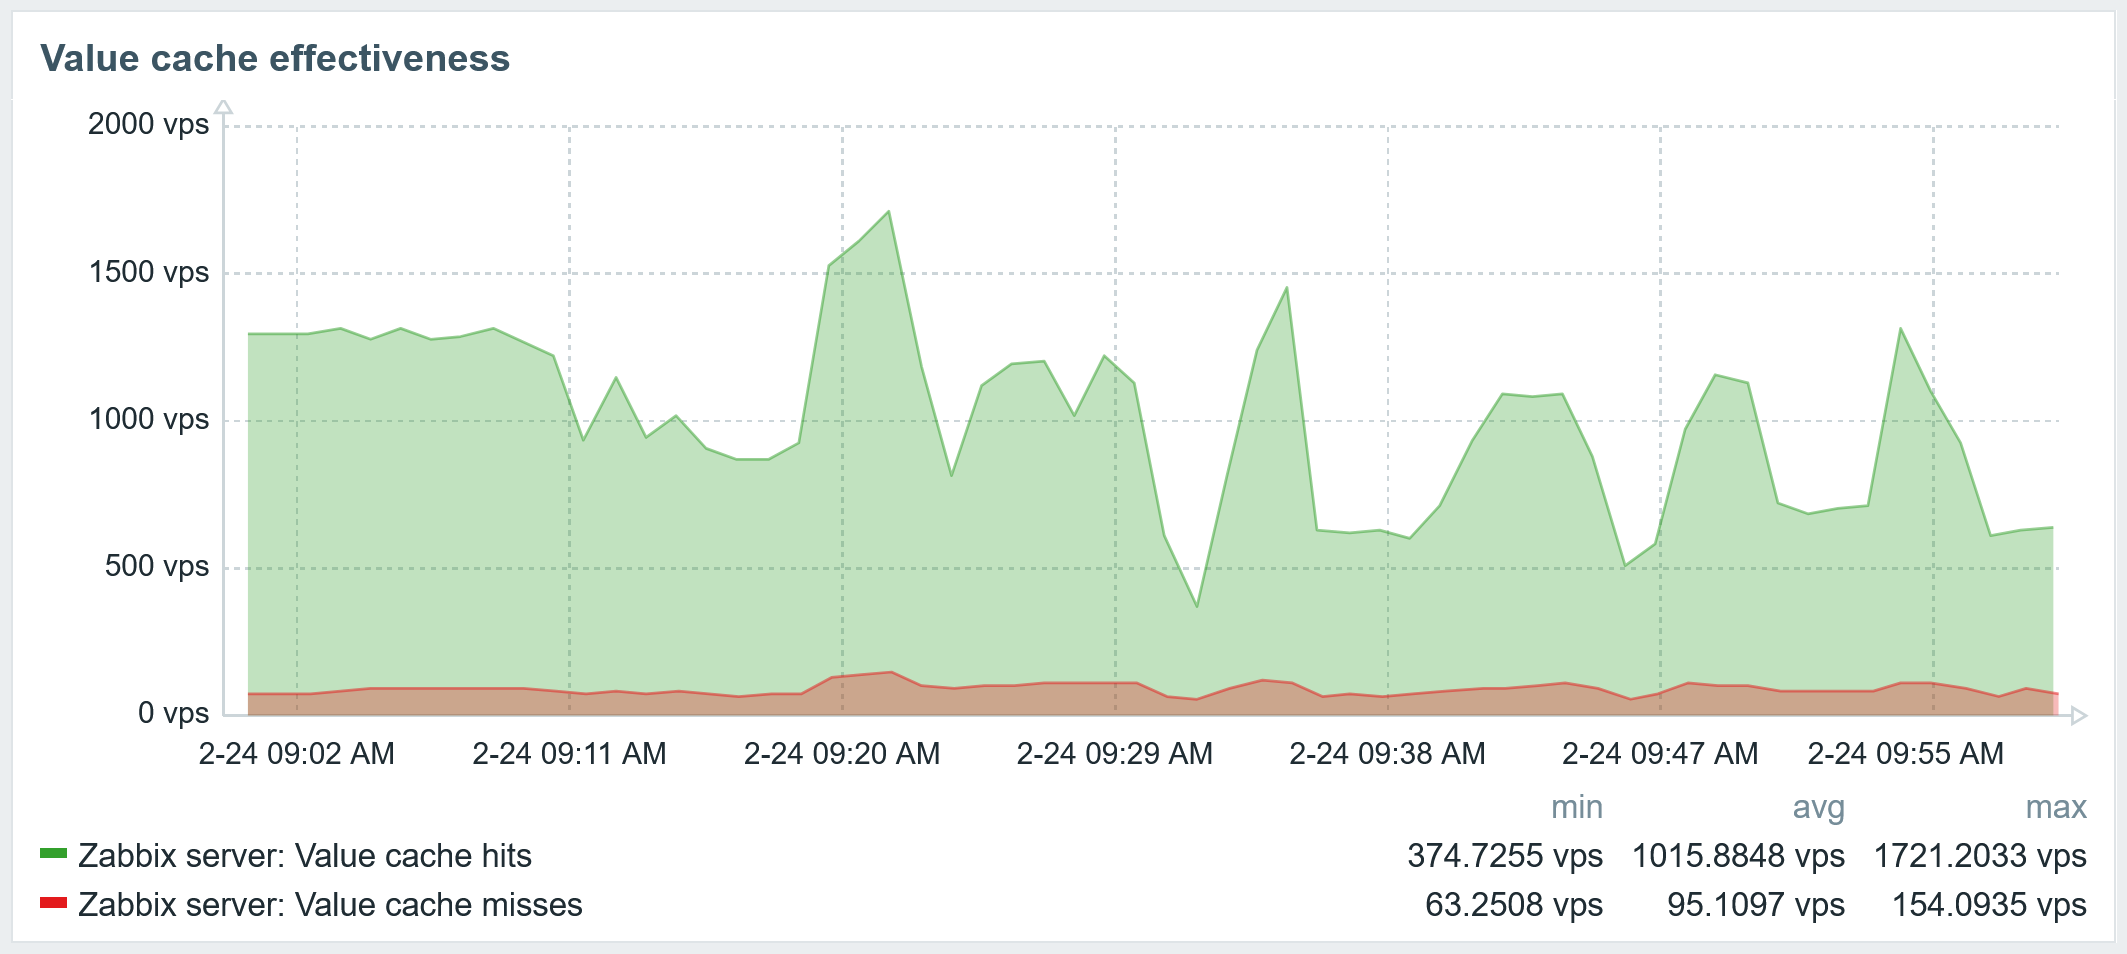
值缓存在低内存模式下运行的问题也可以从下面的图形中看出。在这里,您可以看到有多少监控项历史值存在于缓存中,又有多少必须直接从数据库中获取。
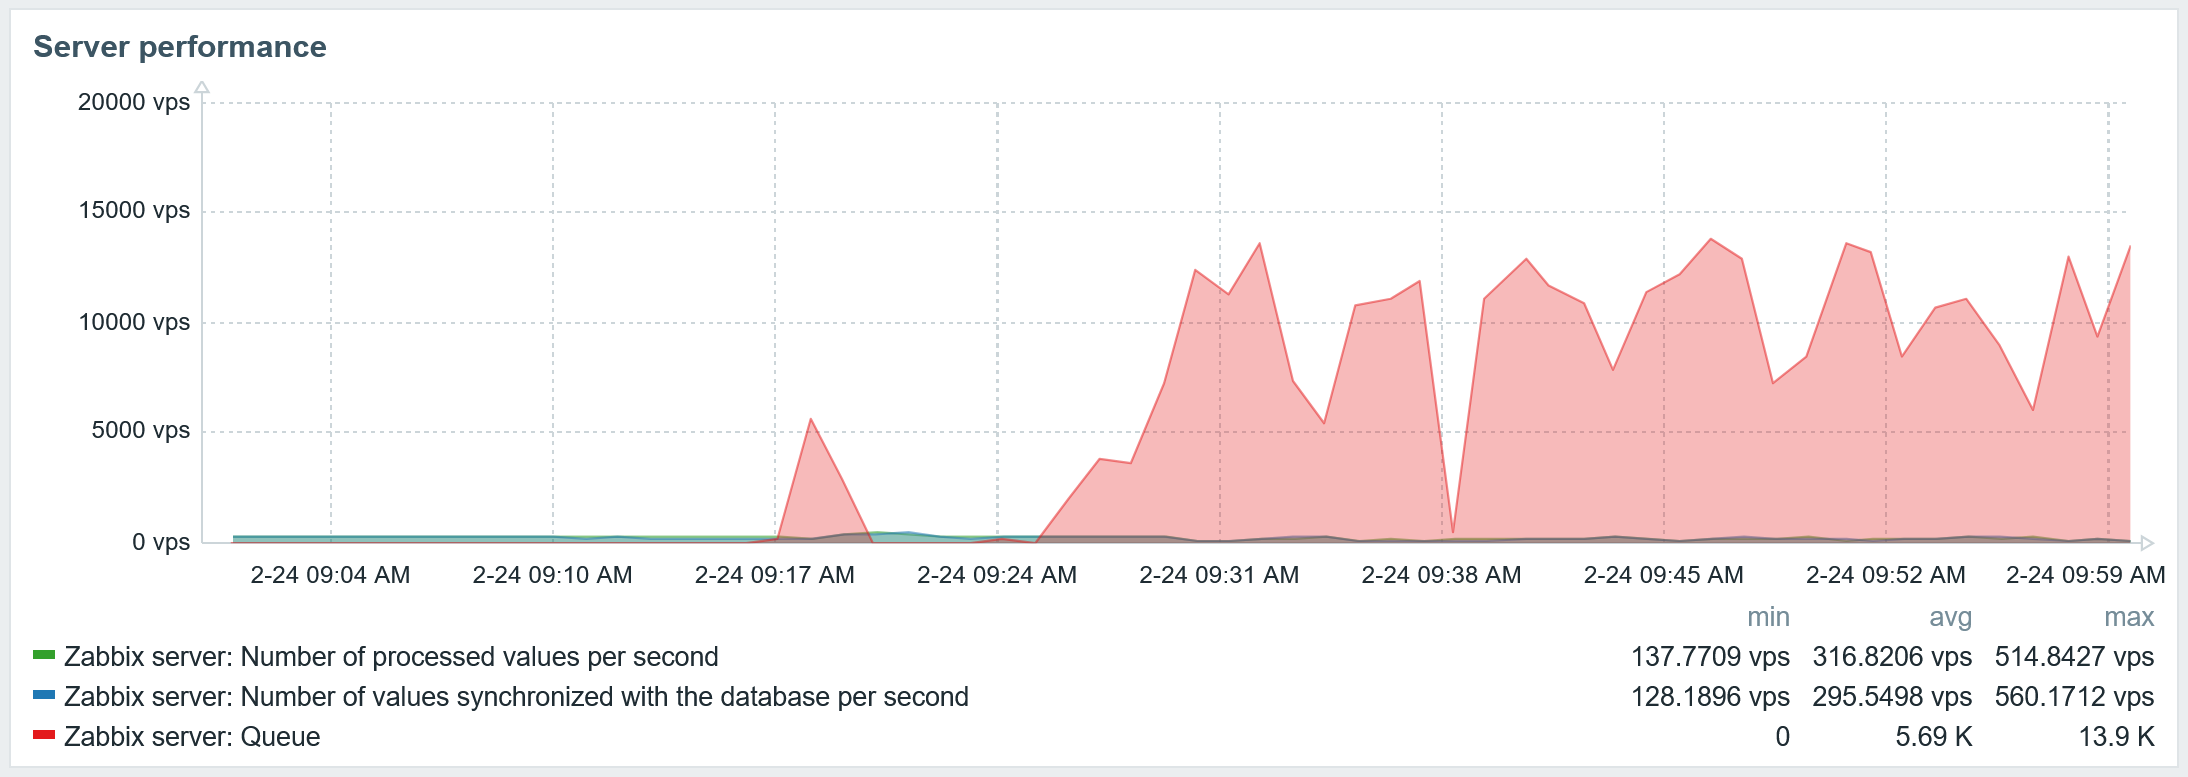
由于未经调优的数据库性能极差,当我的历史写缓存被填满时,数据采集器就会受到限制,导致延迟的监控项采集不断堆积。
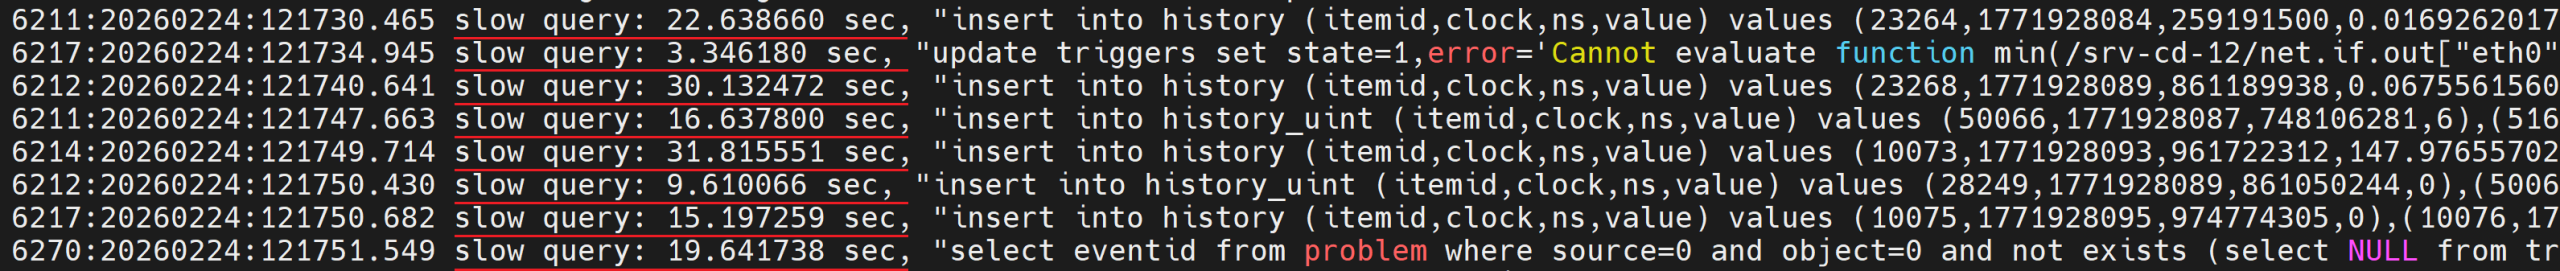
数据库慢查询会出现在 Zabbix server 日志文件中。
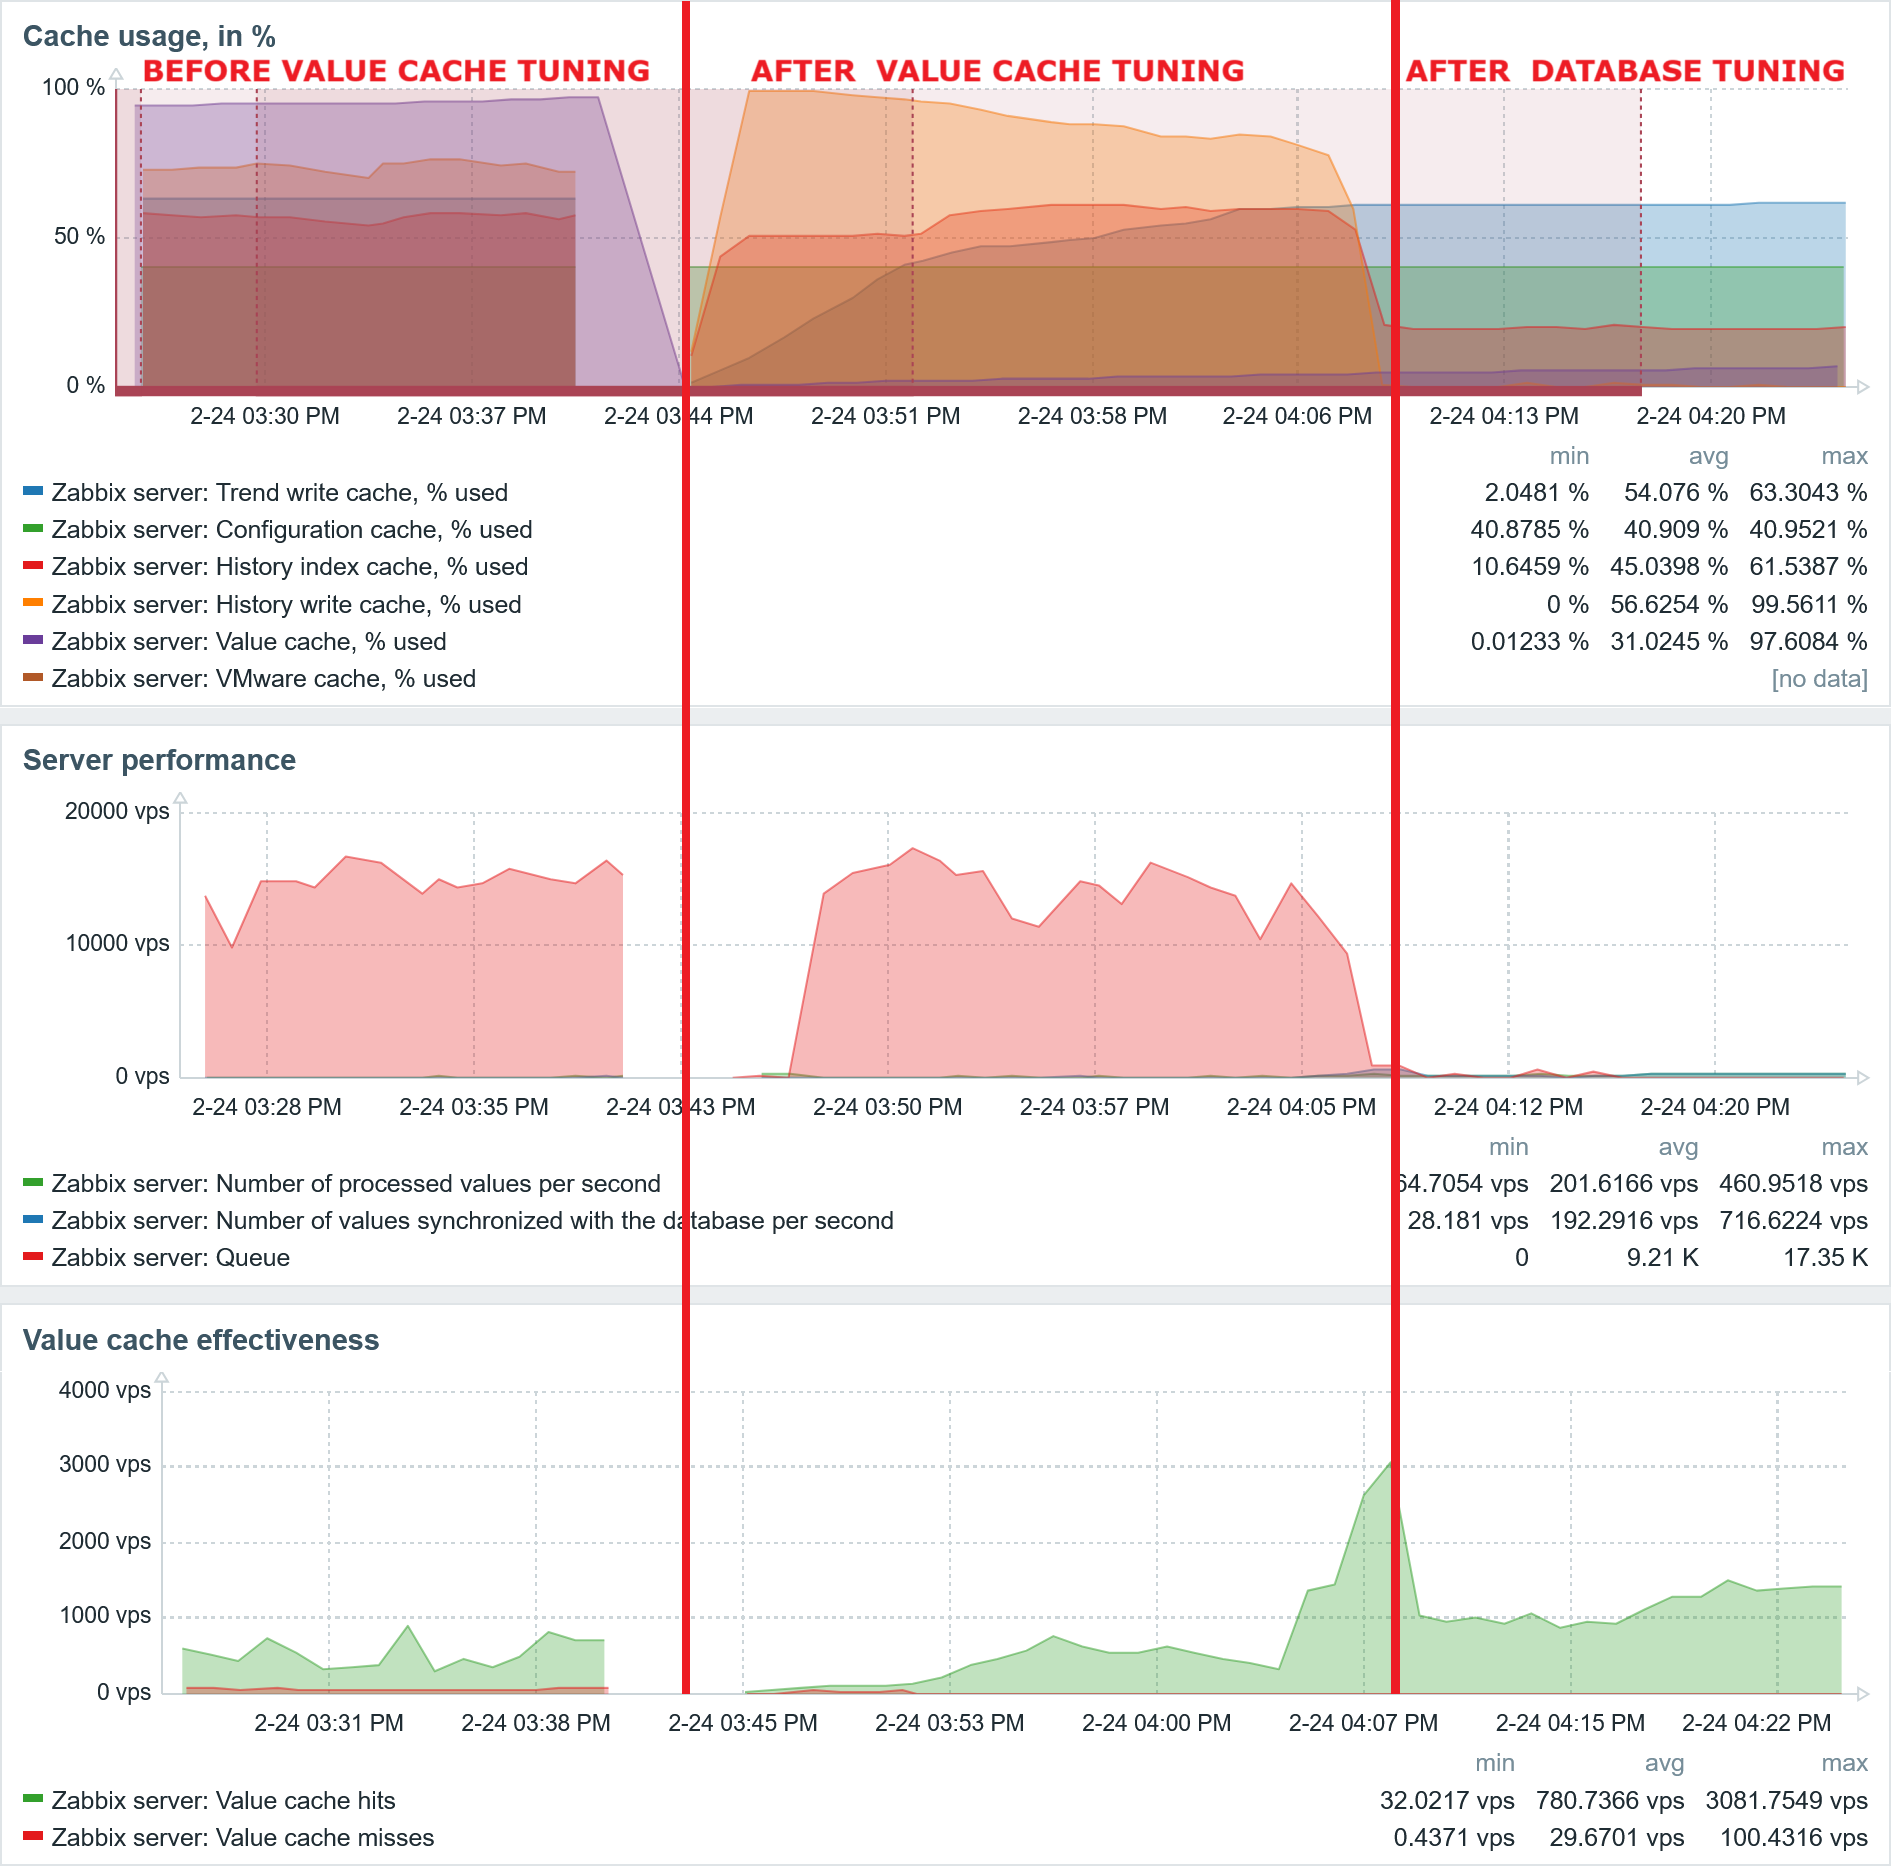
缓存调优和数据库调优的结果
增大值缓存只部分解决了其中一个问题。数据库调优之后,数据库性能显著提升:
- 历史缓存现在是空的
- 不再出现值缓存未命中
- 不再有延迟监控项
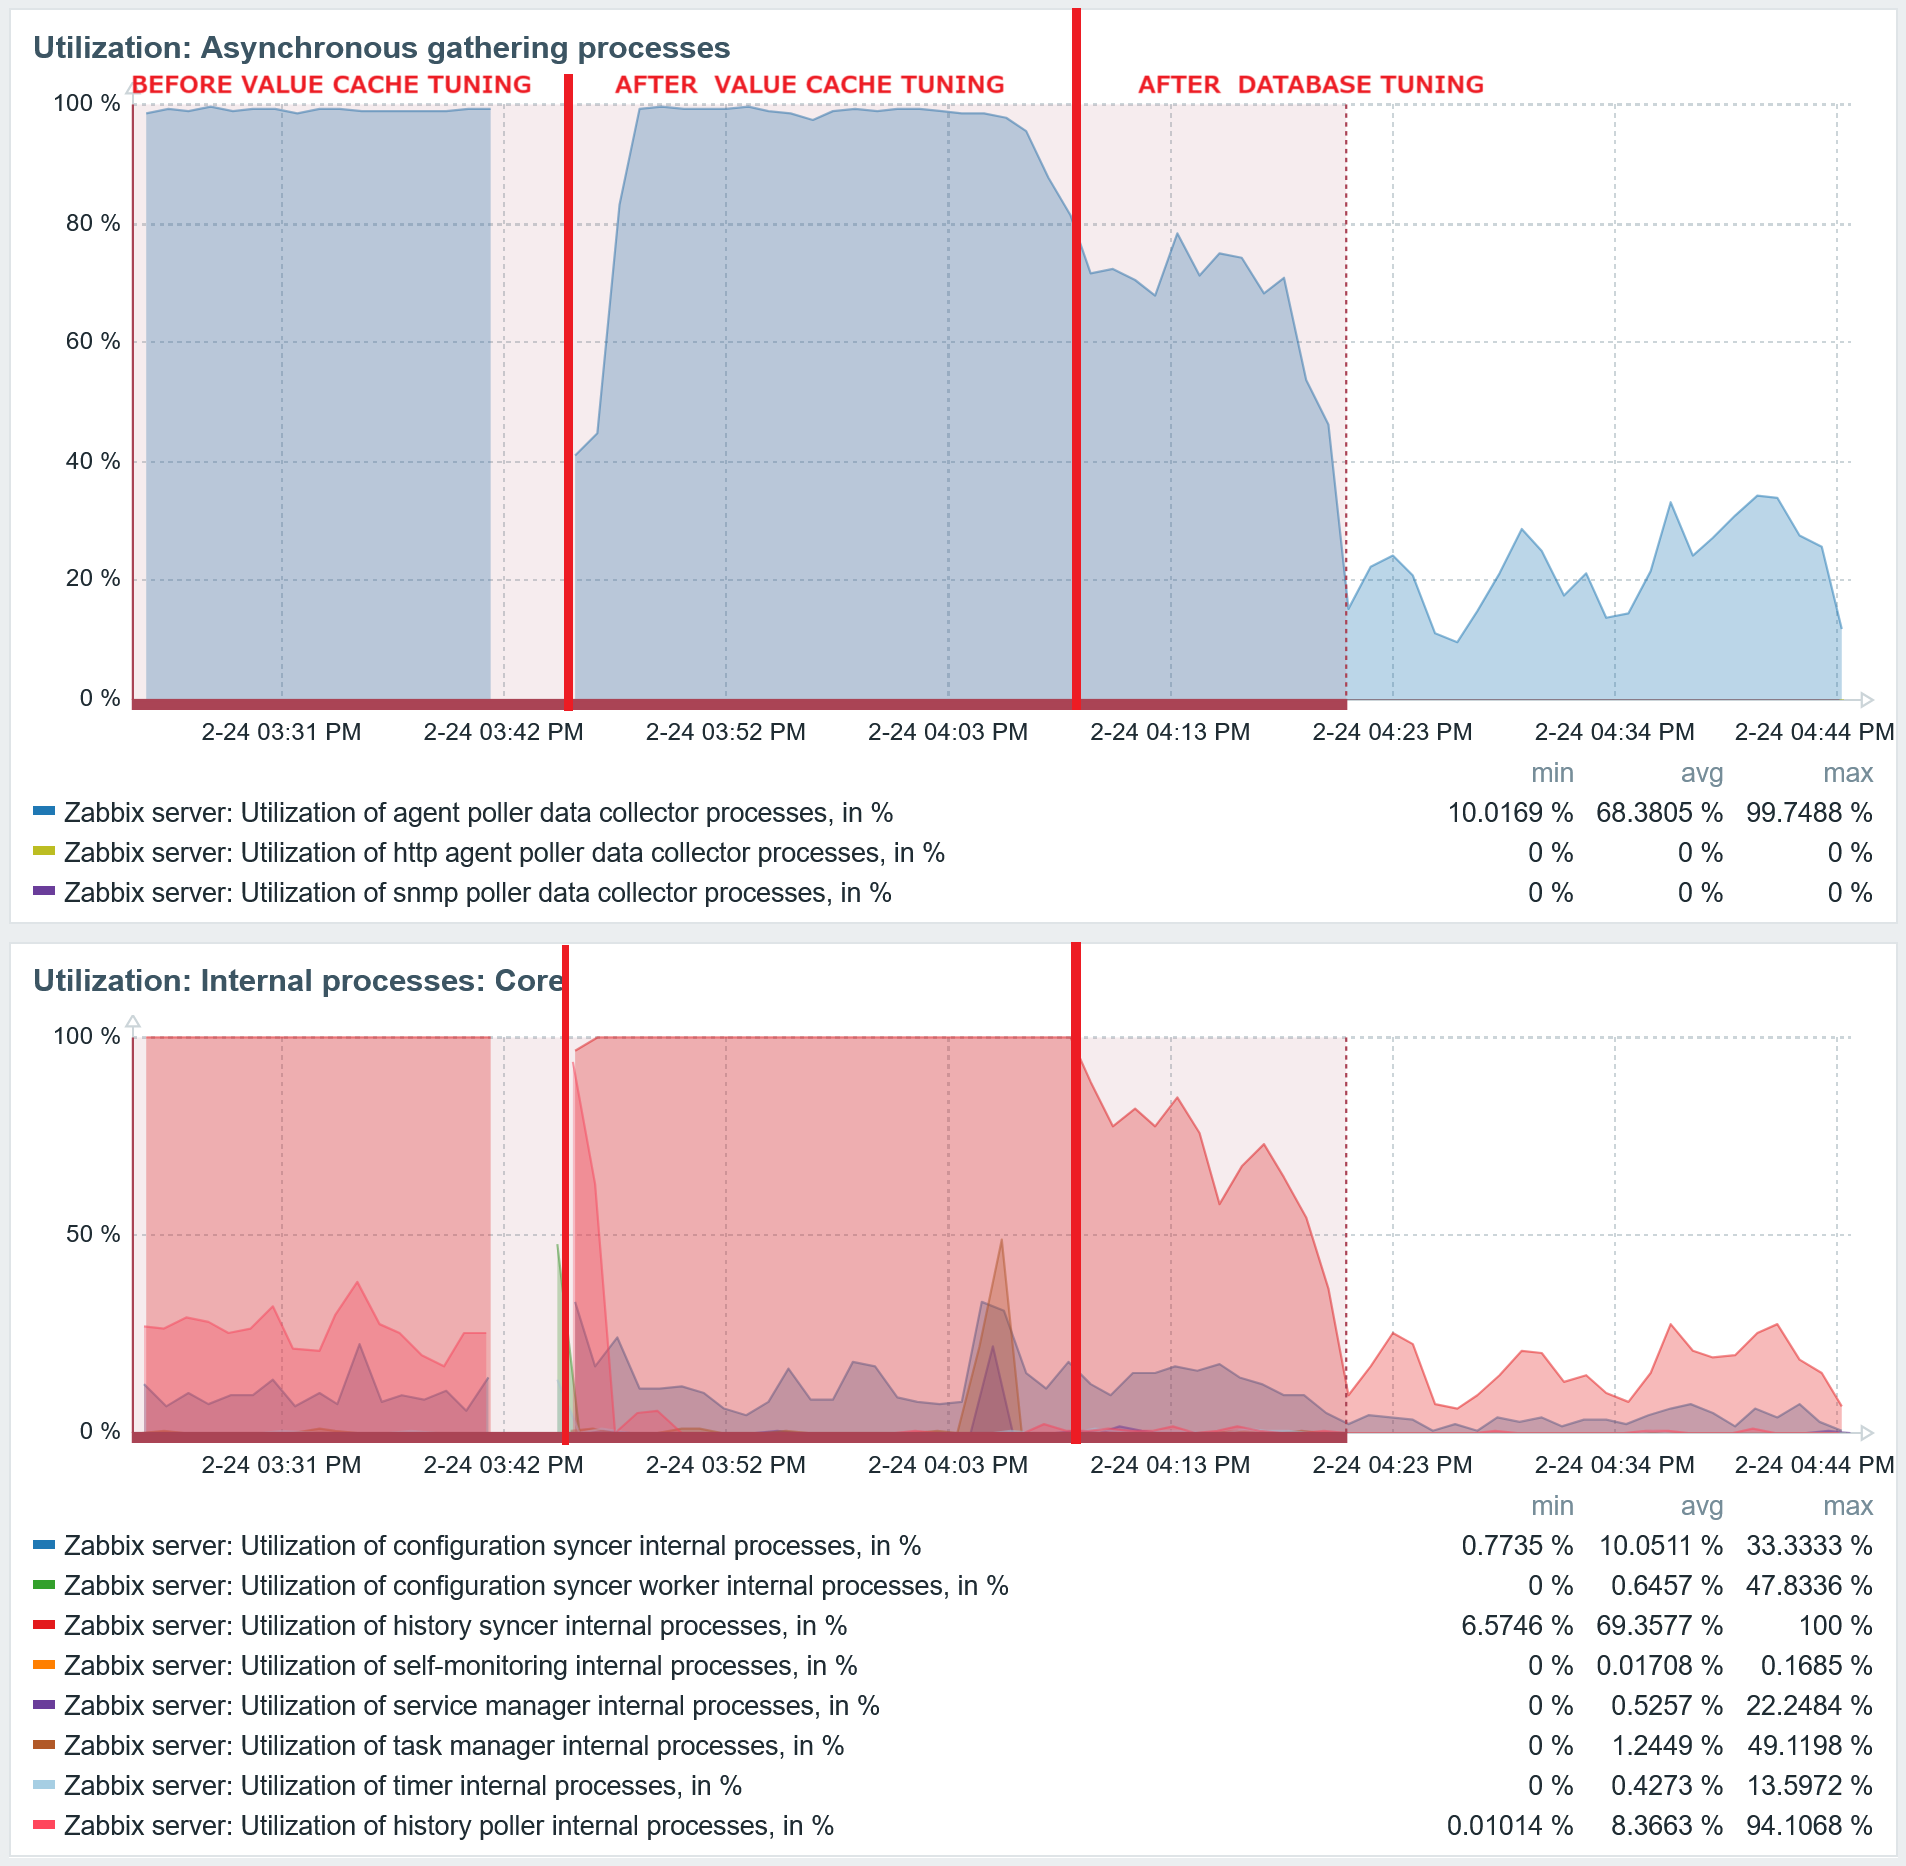
数据库调优之后,agent poller 进程和 history syncer 的利用率也降到了较低水平。
调优 Zabbix server 配置参数
查看 Zabbix Health 仪表板中的 Processes 页面,并相应地调整参数。只调整您理解的参数。随意更改参数可能导致以下后果:
- 浪费资源,却没有带来有效的性能提升
- Zabbix server 性能下降
- Zabbix server 崩溃
对于数据采集器,通常只需要相对较少的异步数据采集器,因为它们效率很高;同步数据采集器则需要相对较多。显示采集进程利用率的图形对于判断需要增加哪些进程极为有用:如果它们的利用率接近 100%,就该采取行动,增加其数量了。
错误配置的陷阱
现在来谈谈错误配置或缺乏调优所带来的陷阱。设想这样一个场景:安装了 Zabbix 组件和 MySQL 数据库,除了为避免 Zabbix server 立即崩溃而调整了配置缓存外,没有进行任何配置调优。Zabbix server 监控着大约 ~400 台主机。Zabbix agent poller 进程和 history syncer 的利用率接近 100%,与调优前的图 17 一样。
您可能会认为,增加这两类进程(例如将其数量加倍)就能改善状况:更多并行的 agent 进程应该能采集更多数据,更多的 history syncer 也应该能向数据库写入更多数据。
重启 Zabbix server 并查看图形后可以发现,这两类进程的繁忙程度都接近 100%,而且指标采集出现了严重延迟。情况变得糟糕得多。
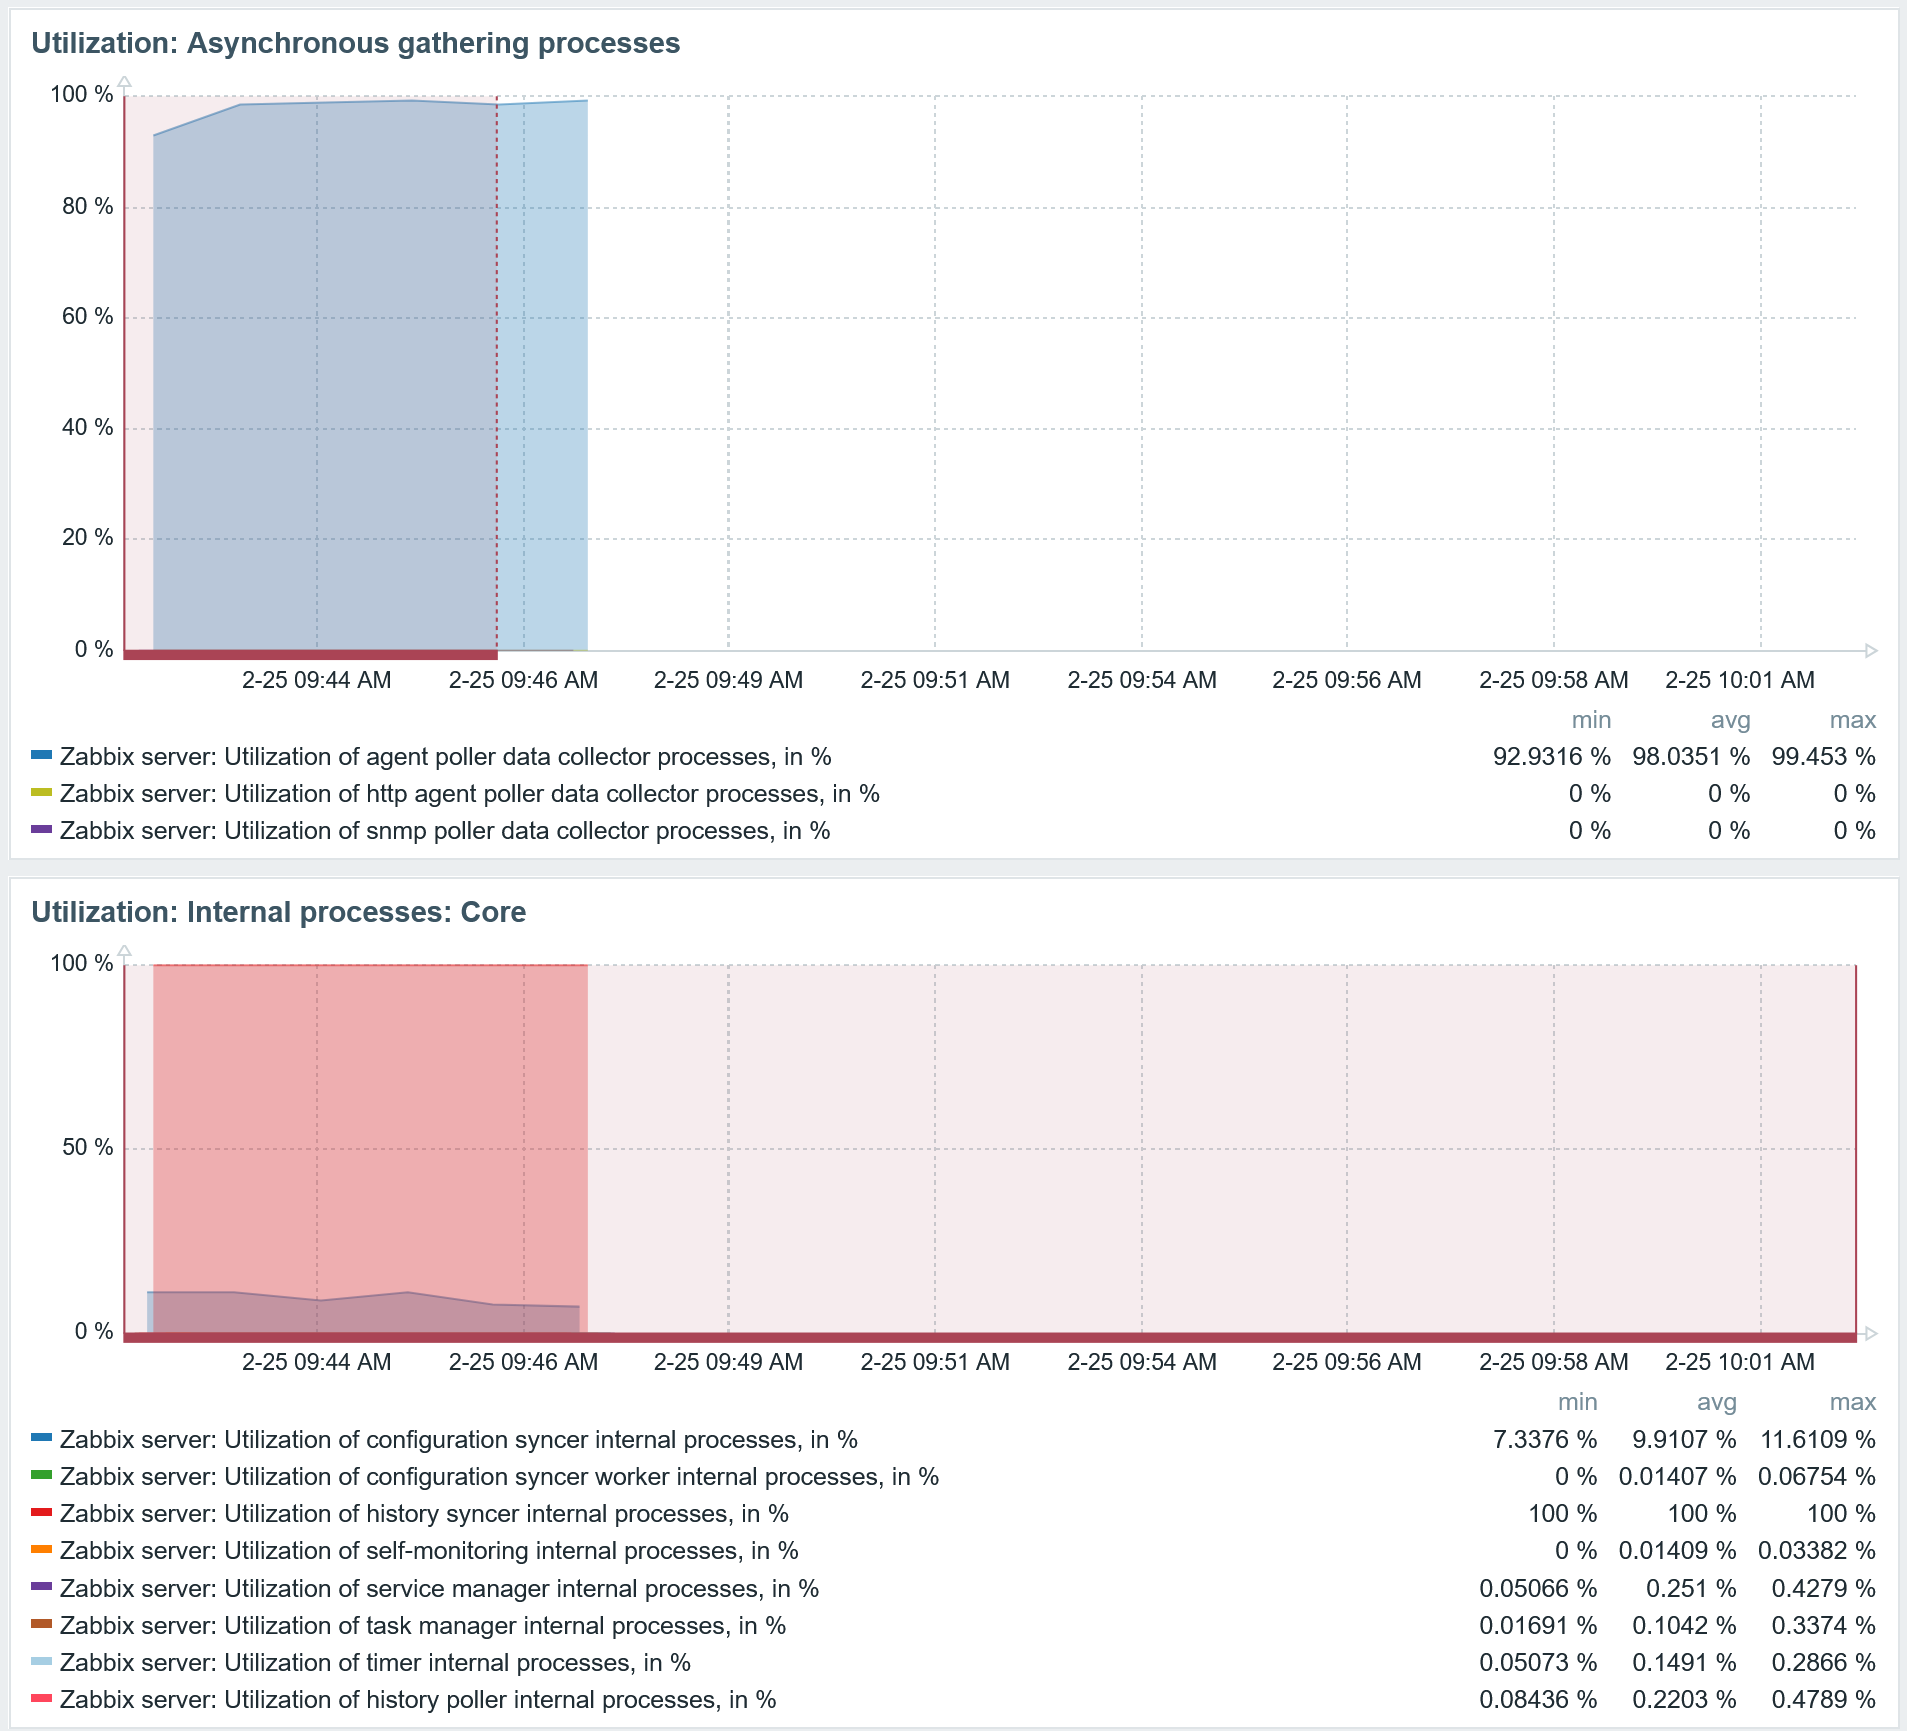
将这两类进程增加到四倍后,结果甚至更糟,监控项值的采集出现了严重延迟。
那么,前端背后究竟发生了什么?仅仅增加 agent poller 数据采集器和 history syncer 的数量,反而导致性能更差。这似乎有违直觉,对吧:更多的数据采集器应该意味着能采集更多数据,而更多的 history syncer 应该能够并行地向数据库写入更多数据。
然而,在这种特定情况下增加数据采集器的数量只会让情况变得更糟:您可以同时采集更多数据,但仍会面临同一个瓶颈:数据库。在这种情况下增加 history syncer 会让情况变得更糟,因为对数据库的并发查询越多,数据库的速度就会被进一步拖慢。所以再强调一次:调优您的数据库引擎,从中获得更多性能。
总结
您应该监控所有 Zabbix 组件,并在出现问题时及时做出反应。还要确保通过您首选的媒介类型接收通知,以便立即采取行动。需要监控的完整清单要广泛得多,但这篇博客文章应该能为您提供一些示例和启发。主动应对问题,总比在问题发生后再去处理要好。

 Prev Post