En entornos maduros de monitoreo, el desafío está en distinguir las señales relevantes del ruido operativo. Zabbix es extremadamente eficiente en la recopilación de métricas y la generación de triggers; sin embargo, cuando la infraestructura crece, las alertas simples basadas en una única condición comienzan a generar un exceso de notificaciones, especialmente en escenarios de fallas en cascada. Es aquí donde entra en juego el sistema de alertas combinadas de Zabbix.
Este problema es común en entornos con:
- Redes jerárquicas;
- Dependencias entre servicios;
- Clusters con componentes compartidos;
- Datacenters con múltiples capas de infraestructura;
- Sistemas distribuidos con alta interdependencia.
En estas situaciones, un único incidente raíz puede generar decenas de síntomas. Sin correlación, el equipo recibe múltiples alertas redundantes, lo que aumenta el tiempo de análisis y reduce la eficacia de la operación.
Las alertas combinadas en Zabbix resuelven este problema al permitir que la notificación se active en función de múltiples eventos, condiciones correlacionadas o dependencias entre triggers. El objetivo no es solo alertar, sino alertar con contexto.
Conceptos fundamentales
Trigger, problema y recuperación
Una trigger es una expresión lógica que evalúa un conjunto de elementos monitoreados. Cuando la expresión se vuelve verdadera, Zabbix genera un evento de problema. Cuando la condición deja de ser verdadera, se crea el evento de recuperación.
Ejemplo:
max(/Linux by Zabbix agent/agent.ping,{$AGENT.TIMEOUT})=0

Este tipo de trigger indica la indisponibilidad del agente Zabbix.
En entornos más complejos, las triggers pueden involucrar:
- Valores actuales;
- Ventanas históricas;
- Funciones de tendencia;
- Comparación entre múltiples elementos;
- Agregación por tiempo;
- Dependencia de otros objetos monitoreados.
Un evento no es necesariamente el incidente raíz
Un evento en Zabbix representa un cambio de estado, pero eso no significa que sea la causa raíz del problema. Un mismo incidente puede generar varios eventos diferentes.
Ejemplo:
- Falla de energía;
- Host fuera de servicio;
- Agente no disponible;
- Servicio HTTP no disponible;
- Base de datos sin respuesta.
Todos estos eventos pueden ser consecuencia de una única falla física. Sin embargo, se recomienda utilizar funciones o métodos que no generen flapping ni falsos positivos, para evitar o reducir el ruido de alarmas/problemas.
Acción, condición y filtro
Las acciones definen qué hacer cuando ocurre un evento. Pueden utilizar condiciones como:
- Severidad;
- Host;
- Grupo de hosts;
- Trigger;
- Tag;
- Valor del evento;
- Expresión lógica personalizada.

En este ejemplo, tenemos las condiciones definidas para los hosts:
- Condición C igual a Zabbix server;
- Condición D igual a ZABBIX-WEB;
Combinado con la severidad de las triggers:
- Condición A: severidad igual a High;
- Condición B: severidad igual a Disaster.
Esto permite construir alertas mucho más sofisticadas que una simple notificación de problema.
Dependencia de triggers
La dependencia de triggers es la forma más directa de evitar alertas duplicadas o secundarias.
Una trigger dependiente deja de generar una notificación si su trigger “padre” ya se encuentra en estado de problema. Esto resulta útil cuando un síntoma es consecuencia natural de otro incidente mayor.
Ejemplo clásico:
- Trigger padre: “Switch core no disponible”
- Trigger hija: “Servidor sin acceso al gateway”
Si el switch core se cae, la alerta del servidor no debe competir con la causa principal.
Trigger padre
max(/Switch core/icmpping,#3)=0

Trigger hija
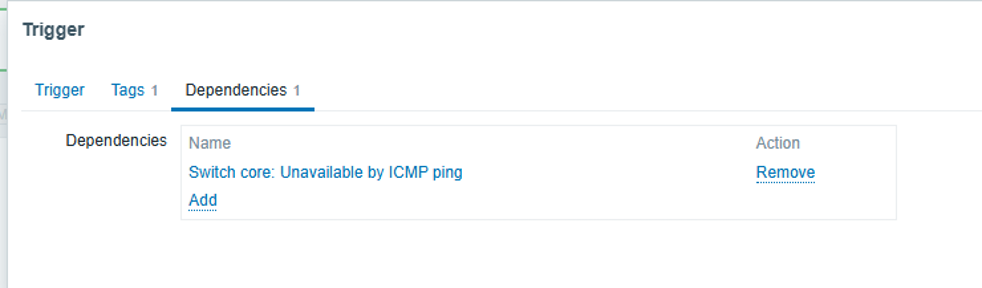
max(/SERVER APP/icmpping,#3)=0

Se configura la dependencia de la trigger que verifica la indisponibilidad de SERVER APP, vinculándola a la trigger del Switch core:
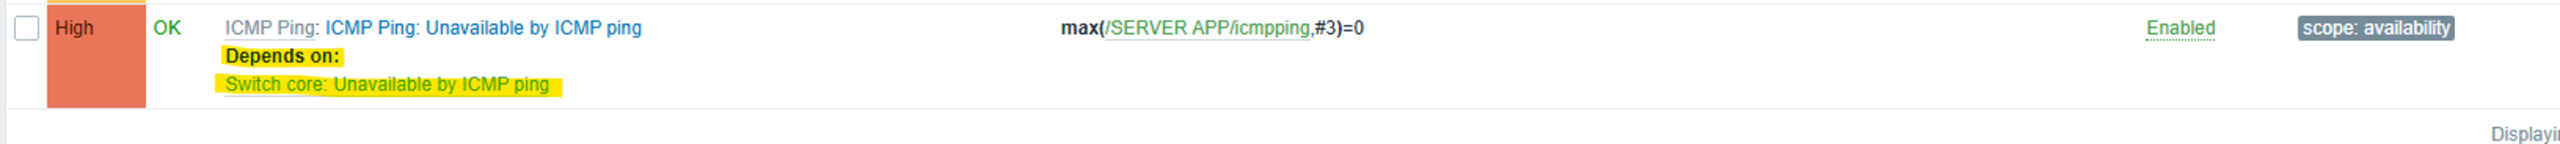
Cuándo utilizar la dependencia
- Link de red que afecta a los hosts detrás de él;
- Storage que impacta bases de datos y aplicaciones;
- DNS no disponible que afecta múltiples servicios;
- Gateway fuera de servicio que afecta el enrutamiento del tráfico.
Limitación de la dependencia
La dependencia no sustituye una correlación más avanzada. Funciona bien en relaciones jerárquicas simples, pero no siempre resuelve casos en los que es necesario combinar varios eventos para definir el incidente.
Alertas combinadas con múltiples triggers
En muchos casos, no basta con depender de un único evento padre. Es necesario combinar condiciones de varias triggers para identificar una situación crítica real.
Modelo lógico
Puedes pensar en las alertas combinadas como una expresión booleana:
Trigger A AND Trigger B AND Trigger CO:
Trigger A OR Trigger B, pero con condición adicional de contextoLa lógica exacta depende del objetivo operativo. En Zabbix existe el Constructor de expresiones, que ayuda a construir y validar la lógica de la trigger.
Ejemplo: degradación de un servidor
Imagina un servidor donde:
- La CPU está por encima del 90 %;
- El load promedio está por encima de 8;
- La cola de disco es alta.
De forma aislada, cada condición puede ser tolerable. En conjunto, indican un riesgo real de indisponibilidad.
Ejemplos de triggers:
High CPU utilization
min(/Zabbix server/system.cpu.util,5m)>90Load average is too high
min(/Zabbix server/system.cpu.load[all,avg1],10m)>8Disk read/write request responses are too high
min(/Zabbix server/vfs.dev.read.await[sda],15m) > 20 or min(/Zabbix server/vfs.dev.write.await[sda],15m) > 20Un enfoque maduro consiste en utilizar estas triggers por separado para el diagnóstico, pero crear una acción o trigger combinada que solo se active cuando coexistan dos o más condiciones. Ejemplo:
(min(/Zabbix server/system.cpu.util,5m)>90)
and
(min(/Zabbix server/system.cpu.load[all,avg1],10m)>8)
and
(min(/Zabbix server/vfs.dev.read.await[sda],15m) > 20 or min(/Zabbix server/vfs.dev.write.await[sda],15m) > 20)
Con la trigger en funcionamiento, se puede crear una acción específica que ejecute un comando o script para resolver el problema o abrir un incidente de alta criticidad para que el equipo responsable lo gestione lo antes posible.
Estrategias para la combinación
En Zabbix, la combinación puede realizarse mediante:
- Dependencia entre triggers;
- Tags en eventos;
- Acciones con múltiples condiciones;
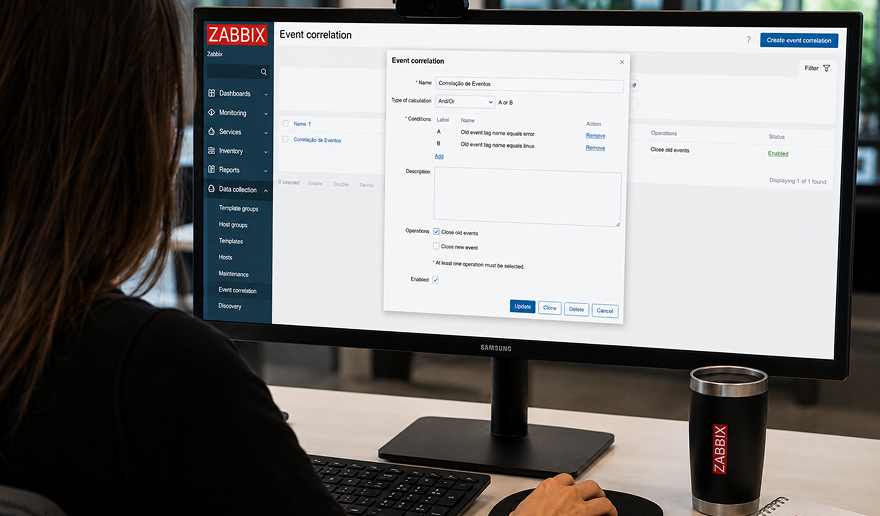
- Correlación mediante reglas;
- Uso de eventos de mantenimiento y supresiones.
Alertas combinadas por tags
Las tags están compuestas por un nombre de tag y un valor de tag. Al etiquetar entidades, puedes utilizar solo el nombre o asociarlo con un valor (por ejemplo, mysql, jira, target:mysql, service:jira, etc.).
Las tags pueden definirse para varias entidades:
- Templates;
- Hosts;
- Items;
- Escenarios web;
- Triggers;
- Servicios;
- Items y triggers de template;
- Prototipos de host, item y trigger.
¿Por qué utilizar tags?
Las tags permiten clasificar eventos por contexto, como:
- service=web;
- service=db;
- env=prod;
- site=dc1;
- tier=backend;
- team=infra.
Esto permite crear reglas de acción que no dependen únicamente del host, sino de la función del evento dentro de la arquitectura.
Ejemplo práctico
Considera dos eventos:
- Trigger 1 en el host db01, tag service=db
- Trigger 2 en el host app01, tag service=web
Si ambos ocurren en producción y dentro del mismo site, la acción puede considerar que existe una falla sistémica más amplia.
Uso en acciones
Una acción puede configurarse para activarse únicamente cuando:
- El evento contiene la tag env=prod;
- El evento contiene la tag service=web;
- La severidad es alta o superior;
- El host pertenece al grupo Datacenter-SP;
- El evento no está en mantenimiento.
Esto permite reducir el ruido y realizar un escalamiento inteligente.
Ejemplo avanzado: correlación entre eventos
La correlación de eventos es el mecanismo más robusto para las alertas combinadas.
Escenario
Imagina los siguientes eventos:
- El ping del router principal falló;
- Los hosts del mismo segmento perdieron conectividad;
- Los servicios HTTP dejaron de estar disponibles;
- El monitoreo remoto perdió el acceso a varios nodos.
La respuesta deseada no es abrir cuatro incidentes independientes, sino reconocer que existe un incidente raíz en la capa de red.
Correlación por regla
Una regla de correlación puede utilizar criterios como:
- Mismo grupo de hosts;
- Misma tag de servicio;
- Misma ventana temporal;
- Mismo tipo de problema;
- Relación de supresión entre clases de eventos.
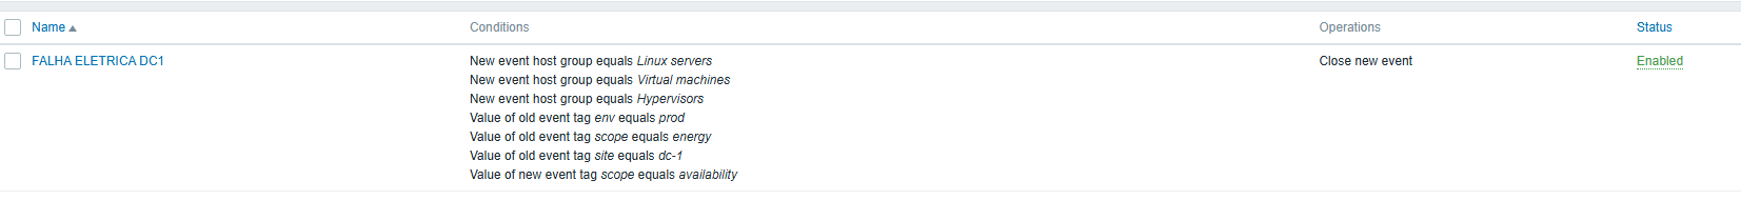
Si el evento raíz de red está activo, se deben suprimir los eventos secundarios que indiquen la indisponibilidad de hosts pertenecientes al mismo segmento.
Ejemplos de triggers para alertas combinadas
Trigger de indisponibilidad con confirmación mediante múltiples fallas
last(/Zabbix server/agent.ping)=0 and last(/Zabbix server/icmpping)=0

Esta trigger solo entra en estado de problema cuando tanto el ping como el agente fallan. Esto reduce los falsos positivos causados por un bloqueo parcial de ICMP.
Trigger de degradación del servicio
max(/ZABBIX-WEB/web.test.fail[zabbix.com],10m)=0 and avg(/ZABBIX-WEB/net.tcp.service[http],10m)=0

Aquí se cruza la indisponibilidad del puerto HTTP con una falla en la prueba web. Es más confiable que depender de una sola de las señales.
Casos de uso reales
Datacenter con falla eléctrica
Cuando un UPS o PDU falla, diversos hosts pueden entrar en estado crítico casi al mismo tiempo.
Sin correlación, esto genera:
- Decenas de alertas de host;
- Alertas de aplicaciones;
- Alertas de storage;
- Alertas de red.
Con las dependencias correctamente configuradas, Zabbix debería identificar el elemento físico raíz y suprimir el resto como consecuencia. Mediante el diseño de la dependencia entre los hosts, la infraestructura en su conjunto y el uso de tags, se puede crear una correlación global para tratar este tipo de falla.
Caída del link principal
Si el link de borde se cae, los servicios externos, la VPN, el acceso a las API y las consultas DNS pueden verse afectados.
La trigger principal debe ser la del link físico o lógico, y las demás alertas deben tratarse como impactos derivados.
Buenas prácticas avanzadas
Documenta las relaciones entre los componentes:
- Red;
- Virtualización;
- Storage;
- Base de datos;
- Aplicación;
- Integración externa.
Sin este mapa, la configuración de dependencias se convierte en un proceso de prueba y error.
Estandarización de tags
Define un estándar único para las tags de eventos. Esto evita inconsistencias y facilita la creación de acciones.
Ejemplo:
- env=prod
- service=api
- tier=frontend
- site=sp01
Recuerda que Zabbix es case-sensitive, es decir: env es diferente de Env. Por lo tanto, estandariza las tags y documéntalas para que todos los analistas/usuarios del entorno sigan el estándar. Esto evitará errores/problemas en los mantenimientos que utilizan tags, correlaciones globales, acciones, etc.
Revisión periódica de las acciones
En entornos dinámicos, la lógica de las alertas no puede ser estática. Lo que hoy representa un evento secundario puede, en otro contexto, convertirse en la causa raíz de un incidente. Por ello, las acciones de Zabbix deben revisarse periódicamente para acompañar los cambios en la infraestructura, la criticidad de los servicios y la topología de los entornos monitoreados.
Esta revisión debe incluir:
- Triggers obsoletos o sin uso práctico;
- Dependencias que ya no reflejan la realidad operativa;
- Acciones duplicadas o superpuestas;
- Reglas de activación mal calibradas;
- Tags inconsistentes o fuera del estándar adoptado.
Además de la revisión manual, es altamente recomendable monitorear el propio entorno de monitoreo. Esto incluye extraer informes sobre:
- Estado actual de las triggers;
- Volumen y recurrencia de eventos;
- Acciones ejecutadas con mayor frecuencia;
- Fallos de notificación;
- Patrones de alertas repetitivas o excesivamente silenciosas.
A partir de estos datos, es posible crear automatizaciones para validar el estado de la propia capa de observabilidad. Por ejemplo, pueden implementarse verificaciones para identificar:
- Triggers que permanecen en estado de problema durante demasiado tiempo;
- Acciones que no se están activando según lo esperado;
- Eventos sin tag de clasificación;
- Dependencias sin una relación clara con los servicios actuales;
- Activaciones redundantes para el mismo incidente.
Este tipo de automatización transforma Zabbix no solo en una herramienta de monitoreo de activos, sino también en un entorno autorregulado, capaz de auditar su propia eficiencia. El resultado es una operación más confiable, con menos ruido, mayor previsibilidad y mayor alineación con la realidad de la infraestructura.
Conclusión sobre la creación de alertas combinadas y basadas en otros eventos
Las alertas combinadas en Zabbix representan un avance importante en la madurez de la estrategia de monitoreo, especialmente en entornos corporativos de alta criticidad y con múltiples dependencias entre servicios. En estructuras más complejas, la capacidad de identificar no solo la ocurrencia de una falla, sino también su contexto operativo, es esencial para garantizar una respuesta más precisa y eficiente.
La aplicación de dependencias, tags, acciones condicionales y mecanismos de correlación de eventos contribuye directamente a reducir el ruido operativo y aumentar la confiabilidad del proceso de notificación. En la práctica, esto permite:
- Reducir los falsos positivos;
- Eliminar las notificaciones redundantes;
- Acelerar la identificación de la causa raíz;
- Aumentar la eficiencia de los equipos de NOC y SRE;
- Elevar el nivel de gobernanza y calidad del monitoreo.
En entornos críticos, este nivel de inteligencia en el tratamiento de alertas tiene un impacto directo en la estabilidad de los servicios.
Transforma el monitoreo de tu infraestructura con Zabbix
Implementar estrategias avanzadas de alertas combinadas, correlación de eventos y eliminación del ruido operativo requiere conocimiento práctico y una arquitectura adaptada a las necesidades de tu negocio.
Si tu equipo dedica más tiempo a analizar notificaciones duplicadas que a resolver problemas de causa raíz, Zabbix puede ayudarte a elevar la madurez de tu operación. Habla con nuestros especialistas para entender cómo diseñar un entorno de monitoreo inteligente, escalable y de alta precisión. Contacta al equipo de Zabbix y habla con un especialista.
 Prev Post