Em ambientes maduros de monitoramento, o desafio está em distinguir sinais relevantes de ruído operacional. O Zabbix é extremamente eficiente na coleta de métricas e geração de triggers, porém, quando a infraestrutura cresce, alertas simples baseados em uma única condição passam a gerar excesso de notificações, especialmente em cenários de falha em cascata. É aqui que entra o sistema de alertas combinados no Zabbix.
Esse problema é comum em ambientes com:
- Redes hierárquicas;
- Dependências entre serviços;
- Clusters com componentes compartilhados;
- Datacenters com múltiplas camadas de infraestrutura;
- Sistemas distribuídos com alta interdependência.
Nessas situações, um único incidente raiz pode gerar dezenas de sintomas. Sem correlação, a equipe recebe múltiplos alertas redundantes, o que aumenta o tempo de análise e reduz a eficácia da operação.
Os alertas combinados no Zabbix resolvem esse problema ao permitir que a notificação seja disparada com base em múltiplos eventos, condições correlacionadas ou dependências entre triggers. O objetivo não é apenas alertar, mas alertar com contexto.
Conceitos fundamentais
Trigger, problema e recuperação
Uma trigger é uma expressão lógica que avalia um conjunto de itens monitorados. Quando a expressão se torna verdadeira, o Zabbix gera um evento de problema. Quando a condição deixa de ser verdadeira, é criado o evento de recuperação.
Exemplo:
max(/Linux by Zabbix agent/agent.ping,{$AGENT.TIMEOUT})=0

Esse tipo de trigger indica indisponibilidade do agente Zabbix.
Em ambientes mais complexos, triggers podem envolver:
- Valores atuais;
- Janelas históricas;
- Funções de tendência;
- Comparação entre múltiplos itens;
- Agregação por tempo;
- Dependência de outros objetos monitorados.
Evento não é necessariamente incidente raiz
Um evento no Zabbix representa uma mudança de estado, mas isso não significa que ele seja a causa raiz do problema. Um mesmo incidente pode gerar vários eventos diferentes.
Exemplo:
- Falha de energia;
- Host fora do ar;
- Agente indisponível;
- Serviço HTTP indisponível;
- Banco de dados sem resposta.
Todos esses eventos podem ser consequência de uma única falha física. Porém, é recomendado a utilização de funções ou métodos que não gerem flapping ou falsos positivos, para evitar ou diminuir os ruídos de alarmes/problemas.
Ação, condição e filtro
As ações definem o que fazer quando um evento ocorre. Elas podem usar condições como:
- Severidade;
- Host;
- Grupo de hosts;
- Trigger;
- Tag;
- Valor do evento;
- Expressão lógica personalizada.

Neste exemplo, temos as condições definidas para hosts:
- Condição C igual a Zabbix server;
- Condição D igual a ZABBIX-WEB;
Combinado com a severidade das triggers:
- Condição A severidade igual a High;
- Condição B severidade igual a Disaster.
Isso permite construir alertas muito mais sofisticados do que uma simples notificação por problema.
Dependência de triggers
A dependência de triggers é a forma mais direta de evitar alertas duplicados ou secundários.
Uma trigger dependente deixa de gerar notificação se sua trigger “pai” já estiver em problema. Isso é útil quando um sintoma é consequência natural de outro incidente maior.
Exemplo clássico:
- Trigger pai: “Switch core indisponível”
- Trigger filha: “Servidor sem acesso ao gateway”
Se o switch core caiu, o alerta do servidor não deve competir com a causa principal.
Trigger pai
max(/Switch core/icmpping,#3)=0

Trigger filha
max(/SERVER APP/icmpping,#3)=0

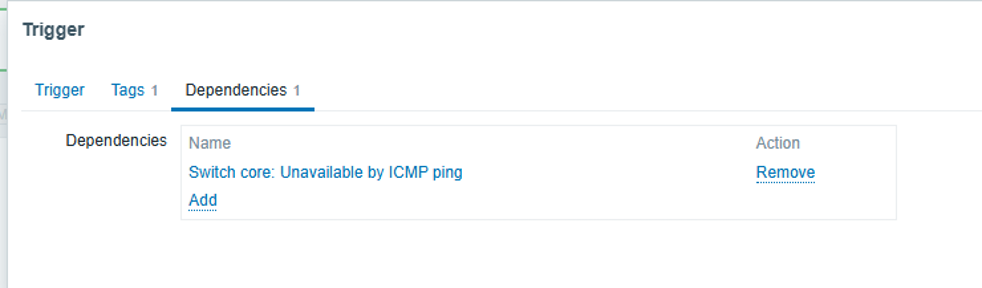
Configura-se a dependência de trigger que verifica a indisponibilidade de SERVER APP, atrelando-a à trigger do Switch core:
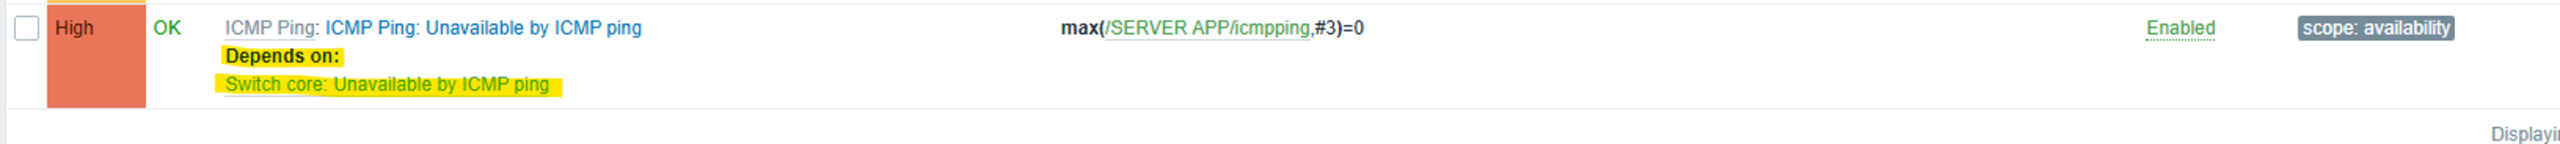
Quando usar dependência
- Link de rede afetando hosts atrás dele;
- Storage impactando bancos e aplicações;
- DNS indisponível afetando múltiplos serviços;
- Gateway fora do ar afetando roteamento de tráfego.
Limitação da dependência
A dependência não substitui uma correlação mais avançada. Ela funciona bem em relações hierárquicas simples, mas nem sempre resolve casos em que a combinação de vários eventos é necessária para definir o incidente.
Alertas combinados com múltiplas triggers
Em muitos casos, não basta depender de um único evento pai. É preciso combinar condições de várias triggers para identificar uma situação crítica real.
Modelo lógico
Você pode pensar em alertas combinados como uma expressão booleana:
Trigger A AND Trigger B AND Trigger COu:
Trigger A OR Trigger B, mas com condição adicional de contextoA lógica exata depende do objetivo operacional. No Zabbix existe o Construtor de Expressão que ajuda a construir e validar a lógica da trigger.
Exemplo: degradação de servidor
Imagine um servidor onde:
- CPU está acima de 90%;
- load médio está acima de 8;
- fila de disco está alta.
Isoladamente, cada condição pode ser tolerável. Em conjunto, elas indicam risco real de indisponibilidade.
Exemplos de triggers:
High CPU utilization
min(/Zabbix server/system.cpu.util,5m)>90Load average is too high
min(/Zabbix server/system.cpu.load[all,avg1],10m)>8Disk read/write request responses are too high
min(/Zabbix server/vfs.dev.read.await[sda],15m) > 20 or min(/Zabbix server/vfs.dev.write.await[sda],15m) > 20Uma abordagem madura é usar essas triggers separadas para diagnóstico, mas criar uma ação ou trigger combinada que só dispare quando duas ou mais condições coexistirem. Exemplo:
(min(/Zabbix server/system.cpu.util,5m)>90)
and
(min(/Zabbix server/system.cpu.load[all,avg1],10m)>8)
and
(min(/Zabbix server/vfs.dev.read.await[sda],15m) > 20 or min(/Zabbix server/vfs.dev.write.await[sda],15m) > 20)
Com a trigger em funcionamento, pode-se criar uma ação específica que dispare um comando ou script que resolva o problema ou abra um incidente com alta criticidade para o time responsável realizar o tratamento o quanto antes.
Estratégias para combinação
No Zabbix, a combinação pode ser feita por:
- Dependência entre triggers;
- Tags em eventos;
- Ações com múltiplas condições;
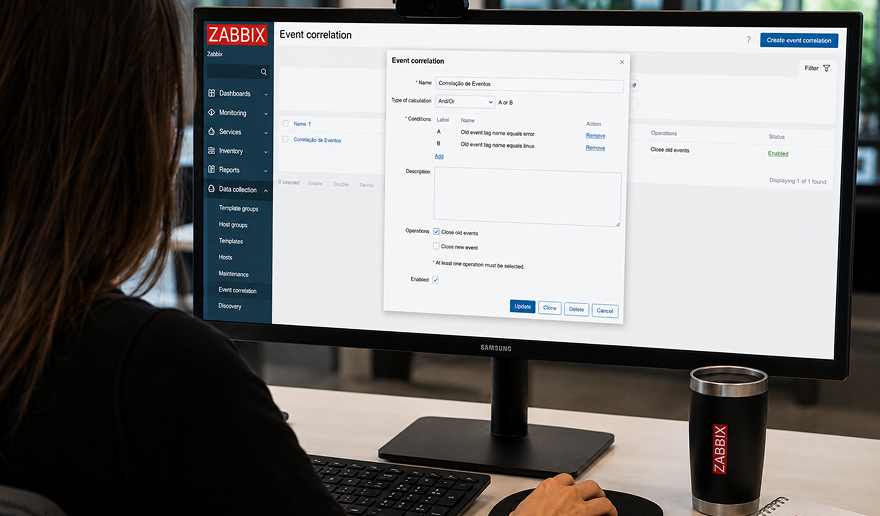
- Correlacionamento por regra;
- Uso de eventos de manutenção e supressões.
Alertas combinados por tags
As tags consistem em um nome de tag e um valor de tag. Ao marcar entidades, você pode usar apenas o nome ou emparelhá-lo com um valor (por exemplo, mysql, jira, target:mysql, service:jira, etc.).
As tags podem ser definidas para várias entidades:
- Templates;
- Hosts;
- Items;
- Cenários web;
- Triggers;
- Serviços;
- Items e triggers de template;
- Protótipos de host, item e trigger.
Por que usar tags?
Tags permitem classificar eventos por contexto, como:
- service=web;
- service=db;
- env=prod;
- site=dc1;
- tier=backend;
- team=infra.
Isso permite criar regras de ação que não dependem apenas do host, mas da função do evento dentro da arquitetura.
Exemplo prático
Considere dois eventos:
- Trigger 1 no host db01, tag service=db
- Trigger 2 no host app01, tag service=web
Se ambos ocorrerem em produção e dentro do mesmo site, a ação pode considerar que há uma falha sistêmica mais ampla.
Uso em ações
Uma ação pode ser configurada para disparar somente quando:
- Evento contém tag env=prod;
- Evento contém tag service=web;
- Severidade é alta ou superior;
- Host pertence ao grupo Datacenter-SP;
- Evento não está em manutenção.
Isso permite reduzir ruído e fazer escalonamento inteligente.
Exemplo avançado: correlação entre eventos
A correlação de eventos é o mecanismo mais robusto para alertas combinados.
Cenário
Imagine os seguintes eventos:
- Ping do roteador principal falhou;
- Hosts do mesmo segmento perderam conectividade;
- Serviços HTTP ficaram indisponíveis;
- Monitoramento remoto perdeu acesso a vários nós.
A resposta desejada não é abrir quatro incidentes independentes, mas reconhecer que existe um incidente raiz na camada de rede.
Correlação por regra
Uma regra de correlação pode usar critérios como:
- Mesmo grupo de hosts;
- Mesma tag de serviço;
- Mesma janela temporal;
- Mesmo tipo de problema;
- Relação de supressão entre classes de eventos.
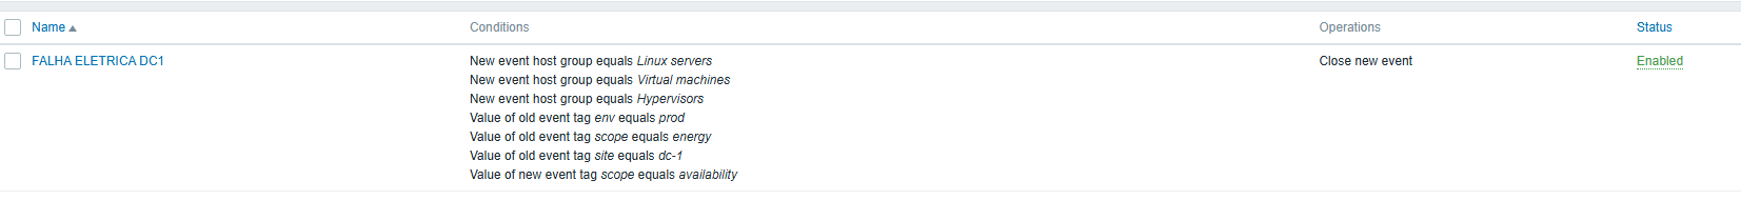
Se o evento de rede raiz estiver ativo, suprimir eventos filhos que indiquem indisponibilidade de hosts pertencentes ao mesmo segmento.
Exemplos de triggers para alertas combinados
Trigger de indisponibilidade com confirmação por múltiplas falhas
last(/Zabbix server/agent.ping)=0 and last(/Zabbix server/icmpping)=0

Essa trigger só entra em problema quando tanto o ping quanto o agente falham. Isso reduz falso positivo causado por bloqueio parcial de ICMP.
Trigger de degradação de serviço
max(/ZABBIX-WEB/web.test.fail[zabbix.com],10m)=0 and avg(/ZABBIX-WEB/net.tcp.service[http],10m)=0

Aqui você cruza a indisponibilidade da porta HTTP com falha de teste web. É mais confiável do que depender de apenas um dos sinais.
Casos de uso reais
Datacenter com falha elétrica
Quando um nobreak ou PDU falha, diversos hosts podem entrar em estado crítico quase ao mesmo tempo.
Sem correlação, isso gera:
- Dezenas de alertas de host;
- Alertas de aplicações;
- Alertas de storage;
- Alertas de rede.
Com dependências bem configuradas, o Zabbix deve identificar o elemento físico raiz e suprimir o restante como consequência. Com o desenho da dependência entre os hosts, a infraestrutura como um todo e a utilização das tags, pode-se criar a correlação global para tratar esse tipo de falha.
Queda de link principal
Se o link de borda cai, serviços externos, VPN, acesso a APIs e consultas DNS podem ser afetados.
A trigger principal deve ser a do link físico ou lógico, e os demais alertas devem ser tratados como impactos derivados.
Boas práticas avançadas
Documente as relações entre componentes:
- Rede;
- Virtualização;
- Storage;
- Banco;
- Aplicação;
- Integração externa.
Sem esse mapa, a configuração de dependências vira tentativa e erro.
Padronização de tags
Defina um padrão único para tags de evento. Isso evita inconsistências e facilita a criação de ações.
Exemplo:
- env=prod
- service=api
- tier=frontend
- site=sp01
Lembre-se, o Zabbix é case-sensitive, isto é: env é diferente de Env. Logo, padronize as tags e documente-as para que todos os analistas/usuários do ambiente sigam o padrão. Isso evitará erros/problemas nas manutenções que utilizam tags, correlações globais, ações, etc.
Revisão periódica das ações
Em ambientes dinâmicos, a lógica de alertas não pode ser estática. O que hoje representa um evento secundário pode, em outro contexto, tornar-se a causa raiz de um incidente. Por isso, as ações do Zabbix devem ser revisadas periodicamente para acompanhar mudanças na infraestrutura, na criticidade dos serviços e na topologia dos ambientes monitorados.
Essa revisão deve incluir:
- Triggers obsoletas ou sem uso prático;
- Dependências que já não refletem a realidade operacional;
- Ações duplicadas ou sobrepostas;
- Regras de disparo mal calibradas;
- Tags inconsistentes ou fora do padrão adotado.
Além da revisão manual, é altamente recomendável monitorar o próprio ambiente de monitoramento. Isso inclui extrair relatórios sobre:
- Estado atual das triggers;
- Volume e recorrência de eventos;
- Ações executadas com maior frequência;
- Falhas de notificação;
- Padrões de alertas repetitivos ou silenciosos demais.
A partir desses dados, é possível criar automações para validar a saúde da própria camada de observabilidade. Por exemplo, podem ser implementadas verificações para identificar:
- Triggers que permanecem em problema por tempo excessivo;
- Ações que não estão sendo acionadas como esperado;
- Eventos sem tag de classificação;
- Dependências sem relação clara com os serviços atuais;
- Disparos redundantes para o mesmo incidente.
Esse tipo de automação transforma o Zabbix não apenas em uma ferramenta de monitoração de ativos, mas em um ambiente autorregulado, capaz de auditar sua própria eficiência. O resultado é uma operação mais confiável, com menor ruído, maior previsibilidade e maior aderência à realidade da infraestrutura.
Conclusão sobre criação de alertas combinados e baseados em outros eventos
Os alertas combinados no Zabbix representam um avanço importante na maturidade da estratégia de monitoramento, especialmente em ambientes corporativos com alta criticidade e múltiplas dependências entre serviços. Em estruturas mais complexas, a capacidade de identificar não apenas a ocorrência de uma falha, mas também o seu contexto operacional, é essencial para garantir uma resposta mais assertiva e eficiente.
A aplicação de dependências, tags, ações condicionais e mecanismos de correlação de eventos contribui diretamente para a redução do ruído operacional e para o aumento da confiabilidade do processo de notificação. Na prática, isso permite:
- Reduzir falsos positivos;
- Eliminar notificações redundantes;
- Acelerar a identificação da causa raiz;
- Aumentar a eficiência das equipes de NOC e SRE;
- Elevar o nível de governança e qualidade do monitoramento.
Em ambientes críticos, esse nível de inteligência no tratamento de alertas faz diferença direta na estabilidade dos serviços.
Transforme o monitoramento da sua infraestrutura com a Zabbix
Implementar estratégias avançadas de alertas combinados, correlação de eventos e eliminação de ruído operacional exige conhecimento prático e arquitetura sob medida para o seu negócio.
Se a sua equipe gasta mais tempo analisando notificações duplicadas do que resolvendo problemas de causa raiz, a Zabbix pode ajudar a elevar a maturidade da sua operação. Fale com nossos especialistas para entender como desenhar um ambiente de monitoramento inteligente, escalável e de alta precisão. Entre em contato com a equipe Zabbix e converse com um especialista.
 Prev Post